5. 后训练
SFT → RL → OPD 标准范式,大规模自动化数据合成与环境构建流水线。
5.1. 后训练流水线
本次发布不引入新的后训练算法。整体方案遵循标准范式:监督微调(SFT)之后进行强化学习(RL)和 on-policy distillation(OPD;Gu et al., 2024; Lu and Lab, 2025),不对成熟算法实践作额外改动。
相反,我们几乎将全部精力集中在模型训练所使用的内容,而不是如何优化模型:我们投入大规模、自动化的数据合成与环境构建流水线。具体而言,该流水线(i)合成多样、可验证的训练任务,并同时生成参考解答与奖励信号;(ii)以程序化方式构建并扩展交互式智能体环境,使轨迹能够以低成本采集和评估;(iii)执行严格的过滤、去重与难度校准,以保证数据质量和课程平衡。
我们发现,在固定且并无特殊之处的优化过程下,对合成数据和环境在规模、多样性与可验证性上的系统改进,几乎解释了全部观测到的性能提升。这一现象体现出一个更普遍的结论:在当前阶段,工程化改进数据和环境流水线的边际收益,显著高于后训练算法创新本身。
5.1.1. 大规模智能体任务合成
任务是智能体学习的基础“燃料”。然而,高质量训练任务长期以来依赖大量人工构建。我们观察到,模型已开始具备构造自身训练任务的能力,尽管这一能力仍远非完善。基于这一潜力,我们投入大量工作增强模型的任务构造与质量验证能力。
我们将每个任务形式化为三元组 (problem, environment, verification system),并沿两个维度评估其质量:难度——确保任务并非平凡;正确性——保证这三个组成部分中不存在关键缺陷。
我们以难度和正确性作为奖励信号,迭代训练模型构造更好的任务。同时,对 RL 任务执行全生命周期监控。每当某个任务进入新的 RL 运行,其产生的轨迹都会提供新的证据,用于重新审计任务质量。
在这一通用框架下,我们针对两个核心场景建立专门的训练环境生产流水线:通用智能体与编码智能体。
通用智能体。 我们鼓励内部员工和外部合作伙伴将最新模型接入日常工作流,并在自愿前提下返回交互数据和反馈。根据这些数据中观测到的接口,我们构造大规模 mocked tools,用于复现真实工具和系统的接口与行为,包括输入格式、输出结构、API schema 和行为约束,覆盖常见 SaaS、企业应用以及更专门的业务后端系统。
同时,我们大规模收集内部员工提交的负面反馈和模型失败案例,将其纳入流水线,从真实工作流出发生成单轮与多轮智能体环境。通过重建相关工具上下文、用户交互模式和失败条件,该流水线可系统地重放失败,并针对已观测到的模型弱点进行定向强化学习。
编码智能体。 编码智能体训练环境来自两类来源:1)内部员工和外部合作伙伴的 coding-agent session,经筛选后仅保留高度复杂的任务或模型表现较差的任务,并按轨迹去重;2)达到 star 数阈值的公开 GitHub 仓库。
环境构建由多个专门智能体协作完成。首先,一个智能体判断项目能否在容器中完整构建、运行并自动验证;若可行,则选择某个具体 turn 或 commit 作为任务起点,设计若干足够复杂的实现方向,并给出具体评测点,包括 fail-to-pass 和 pass-to-pass 项目,同时生成构建报告,必要时从 Web 获取外部资源。
随后,另一智能体在隔离容器中设置依赖、初始工作目录、测试代码和任务描述,执行自测,移除任何可能泄露任务答案的痕迹,并将环境打包成新的 image layer。
之后,由多个不同智能体尝试解决该任务,另一个独立的质量检查智能体同时审查环境与求解轨迹,检查环境问题、事实错误、评测点与任务描述不一致,以及可被 hack 的风险。如果检查未通过,则由修复智能体修正所有已识别问题,调整过易或过难的评测点,再让任务重新进入验证流程。
通过这些流水线,我们能够自动、批量生产正确、具有区分度,并且在长度和难度上可控的 RL 训练数据。无论是对真实工作流的忠实重建,还是编码任务的精确构造,最终都会汇入统一训练系统,在持续质量监控下推动模型能力迭代提升。
5.1.2. 合成任务中的 RL
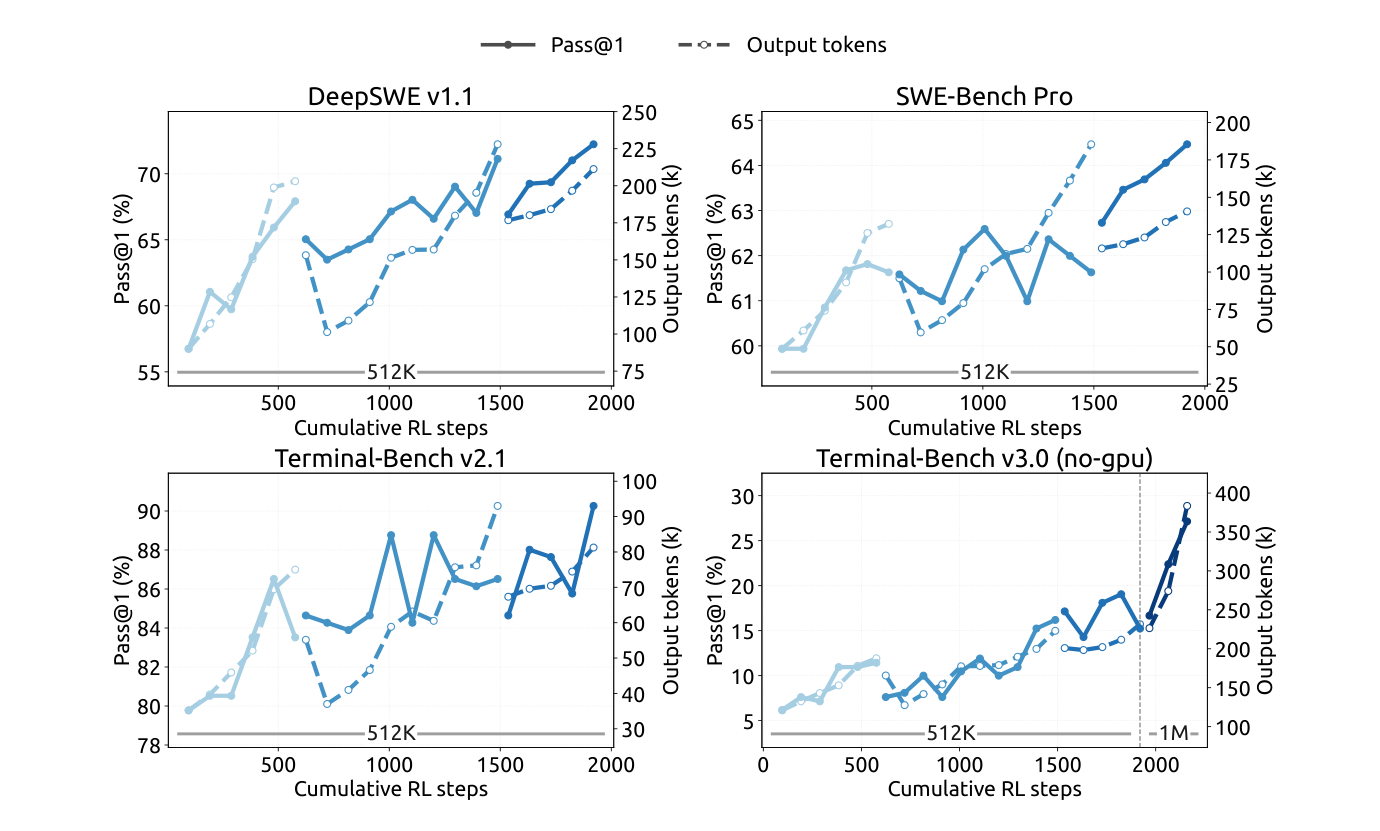
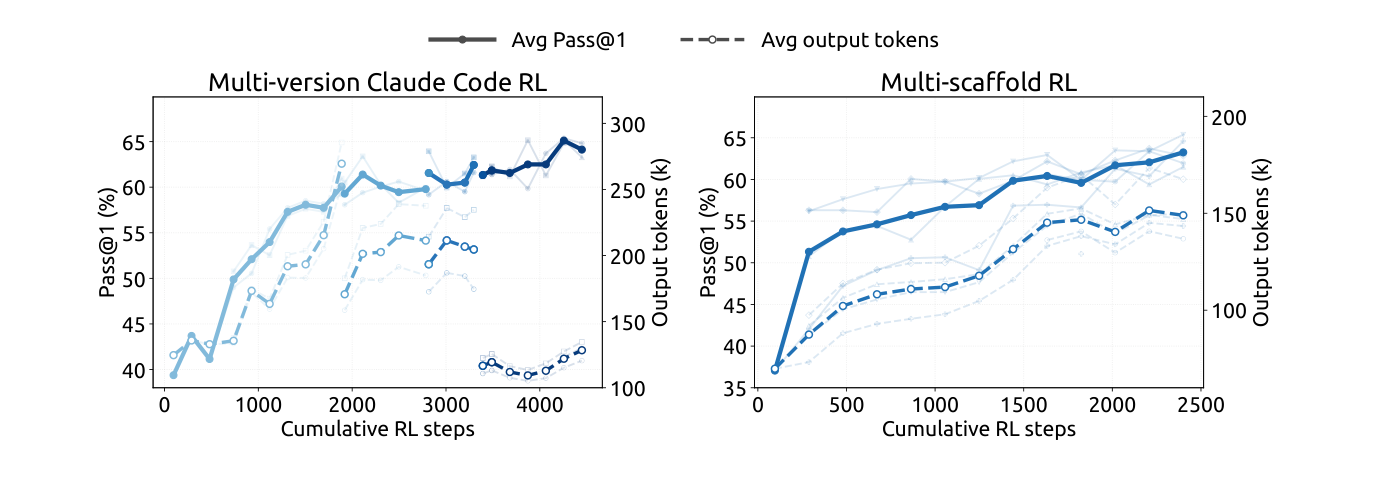
我们在合成任务上使用大规模异步 RL,以提升模型性能并塑造其在复杂场景下的行为。RL 扩展沿两个维度进行:训练计算量和脚手架数量。如图 7、图 8 所示,随着累计 RL step 增加计算量,无论是在单一脚手架内部扩展、同一脚手架多个版本联合训练,还是跨异质脚手架联合训练,性能都持续提高。
对于跨多种脚手架的 RL 训练,我们将智能体 rollout 执行解耦为 agent sandbox 与 worker container。sandbox 运行脚手架及其工具,而 worker container 提供与脚手架无关的控制层,用于编排 rollout、将异构交互标准化为统一轨迹 schema,并与 trainer 通信。
 原始图 7
图 7| 在 DeepSeek Harness 的 Minimal 模式下,随着 RL 训练规模扩大,多种代码智能体基准的性能持续提高。进一步将最大上下文长度扩展到 1M token,可继续改善极长时程任务上的表现,例如 Terminal-Bench v3.0。
sandbox 和 worker 均运行于 DSec(第 5.1.3 节),位于可抢占 GPU 训练池之外,从而将长生命周期 rollout 与细粒度训练调度分离。trainer 被抢占时,可以挂起并卸载 rollout 执行,在保存完整状态的同时释放 CPU 与 GPU 资源,之后再恢复。这一设计使异构脚手架上的 RL 能够稳定、高效运行,而无需修改底层算法。
为了将有效 RL 计算扩展到单次训练运行之外,我们使用模型合并初始化后续 RL 运行。具体而言,将来自不同脚手架或不同配置的运行检查点合并,以整合不同优化路径获得的改进。图 7 和图 8 中彼此断开的曲线段即表示模型重新初始化后的连续 RL 运行。
该方法进一步提高任务性能与 token 效率,提供了一种简单实用的方式,用于汇总并行 RL 计算并跨连续运行继续扩展。
5.1.3. 超大规模运行智能体:DSec
从 DeepSeek-V3 过渡到 V4 时,智能体训练环境的数量和多样性迅速增长,促使我们构建 DeepSeek Elastic Compute(DSec):一个面向大规模智能体训练与评测的生产级 sandbox 平台。
其初始设计主要解决异构执行环境、可扩展 image 分发、多种隔离后端、高密度资源管理、命令轨迹日志,以及可安全应对抢占的恢复机制。
V4.1 训练进一步将需求提升到数百万并发 sandbox 实例,这些实例跨越多种 harness、平台、代码仓库、软件依赖和任务专用服务。在这一规模下,主要瓶颈转移到数据中心可扩展性、工作负载隔离、单节点计算密度,以及约束越来越强大智能体的不当行为。以下简要说明关键设计。
 原始图 8
图 8| 当多个 Claude Code 版本联合训练(左)以及多种异质脚手架联合训练(右,包括 OpenCode、Pi、DeepSeek Harness 的 Standard 与 PTC 模式)时,性能随累计 RL step 增加而提升。评测基于 DeepSWE v1.1。浅色曲线表示单个脚手架版本或单个脚手架的评测结果。
大规模横向扩展计算。 DSec 通过两个互补机制扩展:分片以及放宽一致性的调度。为容纳大量机器,我们将计算节点划分为多个 shard,即所谓 scale unit。这种分片还可通过隔离不同实验的工作负载缩小故障影响范围,避免单个高内存任务耗尽与无关工作共享的资源。
DSec 不使用 Kubernetes 等现成 orchestrator,而采用自定义 placement engine 来调度大量 sandbox,通过牺牲强全局一致性换取可扩展性。其核心观察是:只要每个计算节点能够执行本地安全约束,智能体 sandbox 的 placement 只要求最终一致性。
placement engine 以多个彼此独立、无需同步协调的副本运行。每个副本依据近期测量值预测资源可用性,并作出“足够好”的 placement 决策。为补偿一致性降低,每个节点负责对最终 placement 决策执行验证;若新 placement 会超过本地 warning threshold,则以硬性 admission constraint 拒绝该请求。
整体上,这一设计使 DSec 能扩展到数百万容器,而不会被中央协调机制形成瓶颈。
高密度运行 sandbox。 在节点层面,我们使用硬件支持的 sub-NUMA partitioning,并将每个 worker VM 绑定到独立 NUMA domain。容器运行在这些 worker VM 内,其 CPU 与内存分配被限制在 VM 本地 NUMA 资源范围内。
这一配置在激进内存 overcommit 与 Linux kernel lock contention 之间取得平衡,同时将内存压力和运行时故障局部化。在可比工作负载配置下,在出现可测量端到端性能下降前,单物理节点支持的并发活跃容器密度可从约 1,000 提高到 2,500+。
然而,如此高密度的部署可能因后台工作负载干扰而扭曲时间敏感型评测。因此,DSec 引入 latency-sensitive(LS)执行类别。对非 LS 任务使用 SCHED_IDLE 以尽量降低其调度优先级,并使用 core scheduling,确保同一物理 core 的 sibling hyperthread 上只同时运行相同优先级类别的任务,从而消除相互干扰。
缓解行为异常的智能体。 RL 训练中,我们频繁观察到智能体尝试 reward hacking,或无意中使环境崩溃。在一些尝试中,智能体利用了近期披露的漏洞,包括 XFS driver 权限问题、AppArmor 中的非法内存访问、从 package mirror 服务泄露答案等。智能体还经常删除关键二进制文件、破坏系统文件,甚至移除文件系统。
我们使用逐 sandbox AppArmor profile 和细粒度、基于 eBPF 的网络策略阻止此类行为。如果智能体导致环境崩溃,该轨迹被视为失败,并向 RL 框架报告一个 repercussion 信号。
5.1.4. RL 中可控的推理强度
除模型架构与硬件进步外,输出 token 数同样是服务成本的重要决定因素,因此也决定真实应用中的成本-质量权衡。为此,我们在强化学习中引入标量推理强度 ,作为显式条件信号。该机制同时应用于单轮推理和多轮智能体任务。
具体而言,我们在 system prompt 前加入以下指令:
Reasoning Effort: {effort} (range 1–100; higher values request more
thorough reasoning)
其中
表示请求的推理强度。
对于每个训练 prompt ,在每个推理强度 下采样 个响应:
表示在强度 下采样的响应编号。共享同一 的响应组成一个 subgroup,在组内对奖励做均值中心化,以计算 group-relative advantage。因此,不同推理强度的响应不会被直接相互比较。
相反,我们让 reward 中的长度成分依赖 ,从而在每个 subgroup 内诱导强度相关行为。具体而言,对响应 的奖励加入长度惩罚项 :
其中, 是 reasoning token 数, 为参考长度, 限制单条轨迹可施加的最大扣分。
随请求推理强度增加,token 惩罚系数按指数下降:
其中 是不同推理强度下的基础惩罚系数, 是集合 的最小值, 是训练推理强度之间的平均间隔, 控制惩罚衰减速度。 每增加 ,惩罚系数就乘以 。
参数 控制整体上鼓励更短推理的压力;较小的 会使惩罚更快衰减,并倾向于在不同强度之间产生更明显的行为分离。附录 C 从边际效用角度解释 采用指数参数化的动机。
部署时,标量 为模型推理强度提供灵活控制接口。通过改变 ,同一个模型检查点可以沿学习到的成本-质量前沿在不同运行区域之间移动,以适应不同的延迟、token 预算和解答质量要求。
虽然训练只使用有限个推理强度等级,但部署时可以使用中间值,从而诱导插值后的推理行为,形成细粒度、高效的 test-time 资源分配机制。
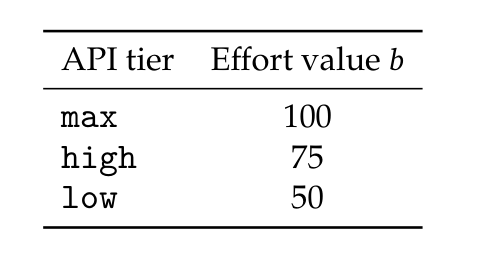
在报告所述的 2026 年 9 月生产部署中,公开 API 提供三个预设 reasoning-effort tier:max、high、low,直接映射到这一标量接口。如表 2 所示,三档分别对应 、 和 。API 用户无需改变模型权重或 decoding configuration,即可选择学习到的成本-质量前沿上的不同运行点。
 原始表 2
表 2|公开 API reasoning-effort tier 与底层标量推理强度 的映射。
| API tier | 推理强度 |
|---|---|
| max | 100 |
| high | 75 |
| low | 50 |
5.2. 异步后训练基础设施
LLM 强化学习 rollout 阶段的长尾问题一直是训练效率的主要瓶颈。为解决这一问题,我们扩展后训练基础设施,使其支持异步生成样本(Zeng et al., 2026; Team et al., 2026b),通过持续维持足够高的并发度,显著缓解 rollout 阶段的长尾问题。目前,几乎全部 RL 与 OPD 任务都已启用异步训练,rollout 效率明显提高。
5.2.1. 整体工作流
我们将 rollout 与训练部署在相同物理设备上,通过时间复用执行,从而无需手工调整两个阶段之间的资源分配。每个任务规定 in-flight sample 数量上限,系统在整个 rollout 阶段持续维持这一上限。
为维持目标 rollout 并发度,我们评估了三种 dispatch 粒度。最终采用 sample-level dispatch:一旦新完成样本数达到下一个 prompt 对应的 GRPO group size,就立即 dispatch 该 prompt,而不关心这些完成样本来自哪些 group。这有助于在整个训练过程中维持稳定的 rollout 并发度。
在确定该策略之前,我们测试了两种替代方案。第一种方案在开始阶段额外 dispatch 若干 batch,并在每次训练迭代后补充一个完整 batch;但这导致训练指标严重振荡,说明 batch-level 粒度过粗。第二种方案改用 prompt-level dispatch,即一个 GRPO group 完成后再 dispatch 新 prompt;但单个 GRPO group 内的长尾样本很容易造成阻塞,难以平滑维持目标 rollout 并发度。
一旦积累了足够训练样本,训练阶段会抢占正在进行的 rollout。训练期间,对于跨多个 checkpoint 的样本,我们使用 concatenated routing-replay:将每个 rollout segment 产生的 expert routing 直接拼接,而不是丢弃并用新 checkpoint 重新计算路由信息。
5.2.2. 缓解长度偏差与离策略效应
异步生成虽然能有效提高 rollout 效率,但会引入两个可能降低训练质量的副作用。第一,它会造成长度分布偏差,尤其在训练早期,因为较短序列通常更早完成,从而主导最初的训练 batch。第二,它不可避免地产生离策略(off-policy)样本,即其 token 部分或全部由更早的 checkpoint 生成。这两个问题需要分别处理。
对于长度偏差,我们采用两种机制。第一,dispatcher 可以按数据集限制并发度,从而调节稳态训练 batch 中各数据集的比例;通过控制进入系统的样本来源,也能间接缓解长度分布偏斜。第二,系统支持丢弃过早返回的短样本,使训练平滑过渡到稳态长度分布,并防止模型过拟合于过短序列。
对于离策略问题,我们再采用两种机制。第一,通过调整样本 dispatch 逻辑和训练样本等待条件,可对最大 off-policy ratio 设定上界,避免训练数据过度偏离当前模型。第二,在训练期间增加 loss masking,移除 stale 程度过高 token 对损失的贡献,从而降低陈旧样本对梯度更新的不利影响。
5.2.3. 性能优化
在异步 RL 框架中,rollout 阶段会周期性中断,以切换到更新后的策略 checkpoint。我们的目标是使这一过程近似无缝:中断应接近瞬时完成,且被中断的 rollout 应能像未中断一样继续执行。
为快速停止 rollout,我们支持 token 级中断:生成可在任意 token 边界停止。一旦采集到足够训练数据,所有 in-flight sample 几乎可以立即停止,使系统无延迟进入训练阶段。
为了跨 checkpoint 切换保存 rollout 进度,生成期间会以 token 粒度持久化 KV cache、expert routing 等 rollout state。用新 checkpoint 恢复时,直接复用这些状态,无需重新预填充,使中断样本能够从原位置继续。由于这要求保留所有 in-flight sample 的状态,我们采用 sample-grained garbage collection;每个样本完成后立即释放其状态。
除 checkpoint 切换外,同一套快速中断与无缝恢复机制还使训练作业能及时响应集群调度的 preemption signal,而不损失进度,从而提升整体集群利用率。
5.2.4. 大规模 On-Policy Distillation
后训练最后阶段是最终的全词表 OPD 任务。它使用来自所有领域的数据集,由 40 多个 teacher model 进行训练,同样采用异步生成以提高 rollout 效率。
由于不同领域的训练流程不同,各领域的最佳 teacher 可能来自模型开发的不同阶段。此外,不同 teacher 之间以及 teacher 与 student 之间的架构也可能不同。我们的后训练基础设施可直接支持这种情况:能够进行全词表 OPD,teacher 数量在实践上不受限制,且可以在架构异质的 teacher 之间以几乎可忽略的成本高效切换(DeepSeek-AI, 2026b)。
OPD 阶段还需要在训练过程中动态重新配置。我们持续跟踪模型能力,并可能相应调整训练方案,包括数据集混合比例、逐数据集并发上限以及当前启用的 teacher。在同步训练中,rollout batch 提供清晰的配置边界,因此此类修改较为直接;在异步环境下,不同配置生成的样本可能同时处于 in-flight 状态。我们的基础设施支持在不同配置间保持一致地过渡,而不会中断 rollout 或训练。
5.3. 评测
5.3.1. 评测设置
后训练评测主要关注推理和智能体能力;知识密集型能力主要由预训练决定,已在表 1 中报告。
推理能力评测包括 GPQA Diamond(Rein et al., 2023)、Humanity’s Last Exam(Phan et al., 2025)、Codeforces(内部基准)和 MathArena Apex(Dekoninck et al., 2025),temperature 与 top- 均设为 1.0。
智能体能力覆盖四类:
- 代码智能体: Terminal-Bench 2.1(Merrill et al., 2026)、Terminal-Bench 3.0(Marten et al., 2026b)、Terminal-Bench 4.0(Marten et al., 2026a)、DeepSWE v1.1(DataCurve, 2026)、ProgramBench(Yang et al., 2026)、NL2Repo-Bench(Ding et al., 2025)。
- 网络安全: SEC-Bench Pro 260505 版本(Lee et al., 2026)、CyberGym(Wang et al., 2026c)、ExploitGym(Wang et al., 2026b)。
- 通用智能体: AutomationBench v1.0.6 的公开评测集(Shepard and Salimans, 2026)、Agents’ Last Exam(Sun et al., 2026a,ALE-CLI)。
- 视觉智能体: Chartography(Garre et al., 2026)、BabyVision(Chen et al., 2026)、ZeroBench 主集合(Roberts et al., 2025)。
代码智能体评测中,DeepSeek-V4.1-Flash 使用 DeepSeek Harness 的 Minimal 模式,上下文窗口 1M token,temperature=1.0,top-p=0.95。为符合官方设置要求,DeepSWE v1.1 使用 mini-SWE harness。SEC-Bench Pro 使用 Claude Code harness,主要利用其 session compact 设计。
视觉智能体任务采用 Claude Code harness,上下文窗口 512k token,temperature=1.0,top-p=0.95。Agents’ Last Exam 和 AutomationBench 使用其官方脚手架。其他编码脚手架下的模型性能见表 4。
为减少代码智能体评测中的 reward hacking,我们限制网络访问,并从环境中移除 Git history。此外,自动清理多种环境中的临时构建和 package cache,包括 Go module cache(go/mod)、node_modules 依赖产物、编译后的 .jar 文件和 Python pycache 目录。
尽管采取这些措施,测试中仍观察到模型主动寻找 exploit 的行为,例如反编译 Ubuntu Linux 核心 package 以发现 CyberGym 中的漏洞。随着模型能力增强,标准评测基础设施(如 Docker container 和验证脚本)越来越容易被模型操纵。我们建议研究社区在设计下一代 benchmark 时优先考虑检测和缓解此类行为。
5.3.2. 评测结果
 原始表 3
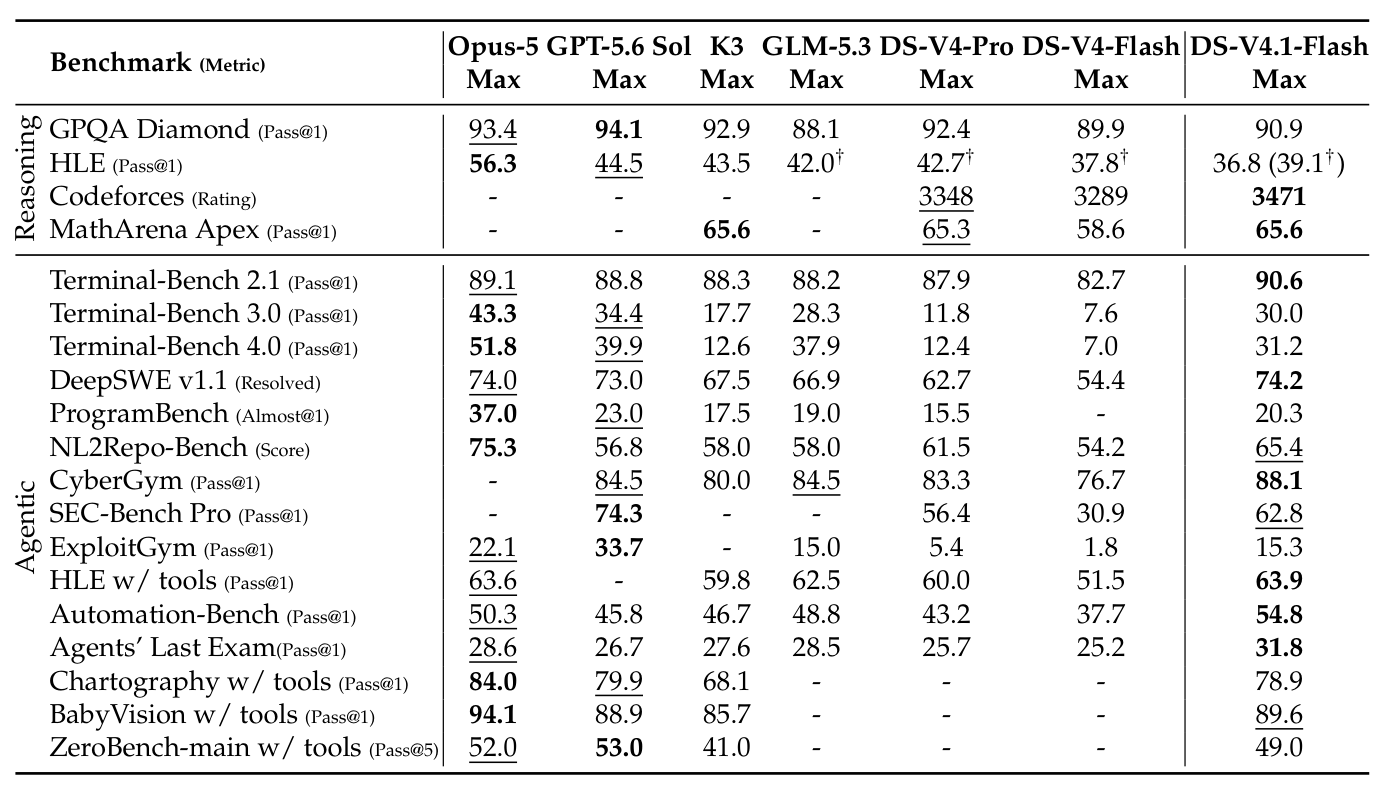
表 3|DeepSeek-V4.1-Flash 与闭源/开源模型对比。 † 表示 HLE 的纯文本子集。最佳结果以粗体标示,第二高结果以下划线标示。
| 基准(指标) | Opus-5 Max | GPT-5.6 Sol Max | K3 Max | GLM-5.3 Max | DS-V4-Pro Max | DS-V4-Flash Max | DS-V4.1-Flash Max |
|---|---|---|---|---|---|---|---|
| 推理 | |||||||
| GPQA Diamond (Pass@1) | 93.4 | 94.1 | 92.9 | 88.1 | 92.4 | 89.9 | 90.9 |
| HLE (Pass@1) | 56.3 | 44.5 | 43.5 | 42.0† | 42.7† | 37.8† | 36.8 (39.1†) |
| Codeforces (Rating) | - | - | - | - | 3348 | 3289 | 3471 |
| MathArena Apex (Pass@1) | - | - | 65.6 | - | 65.3 | 58.6 | 65.6 |
| 智能体 | |||||||
| Terminal-Bench 2.1 (Pass@1) | 89.1 | 88.8 | 88.3 | 88.2 | 87.9 | 82.7 | 90.6 |
| Terminal-Bench 3.0 (Pass@1) | 43.3 | 34.4 | 17.7 | 28.3 | 11.8 | 7.6 | 30.0 |
| Terminal-Bench 4.0 (Pass@1) | 51.8 | 39.9 | 12.6 | 37.9 | 12.4 | 7.0 | 31.2 |
| DeepSWE v1.1 (Resolved) | 74.0 | 73.0 | 67.5 | 66.9 | 62.7 | 54.4 | 74.2 |
| ProgramBench (Almost@1) | 37.0 | 23.0 | 17.5 | 19.0 | 15.5 | - | 20.3 |
| NL2Repo-Bench (Score) | 75.3 | 56.8 | 58.0 | 58.0 | 61.5 | 54.2 | 65.4 |
| CyberGym (Pass@1) | - | 84.5 | 80.0 | 84.5 | 83.3 | 76.7 | 88.1 |
| SEC-Bench Pro (Pass@1) | - | 74.3 | - | - | 56.4 | 30.9 | 62.8 |
| ExploitGym (Pass@1) | 22.1 | 33.7 | - | 15.0 | 5.4 | 1.8 | 15.3 |
| HLE w/ tools (Pass@1) | 63.6 | - | 59.8 | 62.5 | 60.0 | 51.5 | 63.9 |
| Automation-Bench (Pass@1) | 50.3 | 45.8 | 46.7 | 48.8 | 43.2 | 37.7 | 54.8 |
| Agents’ Last Exam (Pass@1) | 28.6 | 26.7 | 27.6 | 28.5 | 25.7 | 25.2 | 31.8 |
| Chartography w/ tools (Pass@1) | 84.0 | 79.9 | 68.1 | - | - | - | 78.9 |
| BabyVision w/ tools (Pass@1) | 94.1 | 88.9 | 85.7 | - | - | - | 89.6 |
| ZeroBench-main w/ tools (Pass@5) | 52.0 | 53.0 | 41.0 | - | - | - | 49.0 |
如表 3 所示,相较前代 DeepSeek-V4-Flash,DeepSeek-V4.1-Flash 在推理和智能体基准上均有显著提升,并可匹配或超过顶级开源与闭源模型。
在核心推理任务中,DeepSeek-V4.1-Flash 的 Codeforces rating 达到 3471,超过 DeepSeek-V4-Flash(3289)和 DeepSeek-V4-Pro(3348)。MathArena Apex 的 Pass@1 为 65.6%,与最佳开源基线 Kimi-K3(65.6%)完全持平,并略高于 DeepSeek-V4-Pro(65.3%)。GPQA Diamond 达到 90.9%,较 DeepSeek-V4-Flash(89.9%)继续提升。
智能体任务上的增益更加明显。DeepSWE v1.1 达到 74.2%,相比 DeepSeek-V4-Flash 的 54.4% 大幅提升,并超过 Opus-5(74.0%)和 GPT-5.6 Sol(73.0%)等闭源模型。Terminal-Bench 2.1 达到 90.6%,高于 Opus-5(89.1%)和 GLM-5.3(88.2%)。Automation-Bench(54.8%)和 Agents’ Last Exam(31.8%)上同样取得领先分数。
尽管模型规模较紧凑,DeepSeek-V4.1-Flash 展现出先进的智能体能力,在显著缩小与闭源前沿模型差距的同时,也在开源模型中建立明显优势。
在网络安全任务上,DeepSeek-V4.1-Flash 在开源模型中达到了新的最先进水平。鉴于这些能力具有双重用途,我们鼓励社区负责任地应用这些能力,例如用于防御性安全研究和漏洞修复。
在视觉智能体任务中,DeepSeek-V4.1-Flash 展现出较强能力,尤其适用于需要视觉推理和复杂专业图表分析的场景。虽然其优于领先开源模型 Kimi-K3,但与领先闭源模型相比仍存在可测量的差距。
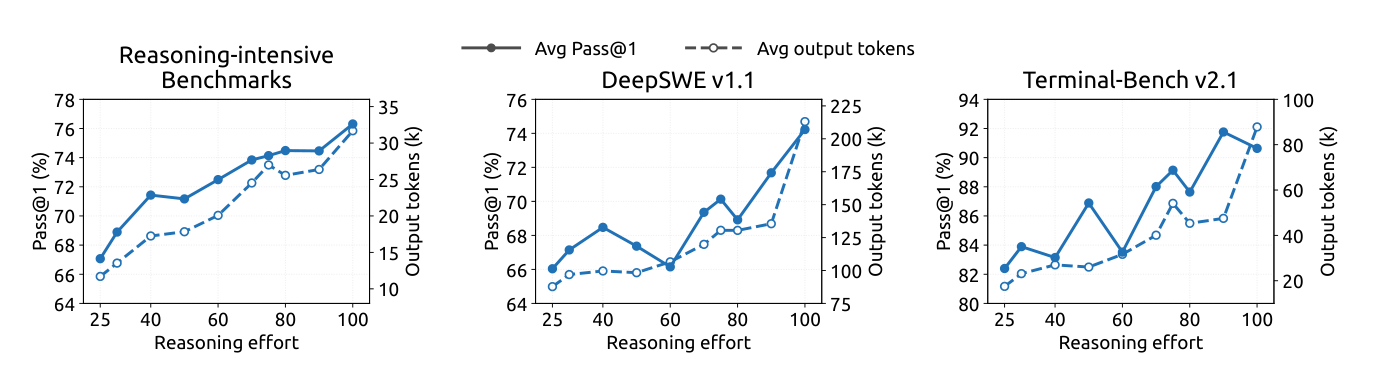
除了峰值性能,DeepSeek-V4.1-Flash 还提供 reasoning-effort 设置,使用户可以在可控方式下用推理成本换取准确率。如图 9 所示,在推理和智能体基准上,准确率和输出长度都会随推理强度稳定增加。
将 effort 从 25 提高到 100,会使八个推理密集型 benchmark 的平均 Pass@1 从 67.1% 提高到 76.3%,DeepSWE v1.1 从 66.0% 提高到 74.2%,Terminal-Bench 2.1 从 82.4% 提高到 90.6%,代价是输出 token 约增加 2.5 倍。值得注意的是,在单响应推理上学习到的 effort 控制能够可靠迁移到长时程智能体轨迹,在这些轨迹中,它会控制跨多个 turn 的总探索和验证量。收益主要集中在前段:60–80 的 effort 区间已经能够以不到最大设置一半的 token 预算恢复最大设置的大部分准确率,而最后提升到 effort 100 会使智能体轨迹延长约 1.6–1.8 倍,却只带来边际改进。因此,最大档最适合保留给最具挑战性的任务,而中等 effort 对日常智能体使用提供了更有利的成本—性能平衡。
5.3.3. 不同推理强度下的性能
图 9 给出了不同预算值下的性能与平均响应长度。推理强度提高时,模型会产生更长的 reasoning trace,并在推理密集型 benchmark 与软件工程任务上单调提高准确率;最大增益集中于低到中等预算区间,之后边际收益递减。
虽然 RL 只使用有限数量的 effort level,标量 effort 仍能在特定范围内对响应长度进行灵活、插值式控制。因此,实践中可以沿连续区间在质量、延迟和 token 成本之间权衡:延迟敏感应用可使用较低 effort,只承受有限准确率损失;困难任务则可提高 effort,以恢复模型完整推理能力。
公开 API 中提供三档预设 effort:low、high、max,分别对应 50、75、100。
5.3.4. 不同智能体脚手架下的性能
实际部署中,模型很少只运行于单一固定智能体框架。不同 scaffold 的 system prompt、tool definition、context management strategy 与 interaction protocol 都可能不同;如果模型过拟合某一 harness,迁移到其他 harness 时性能可能明显下降。
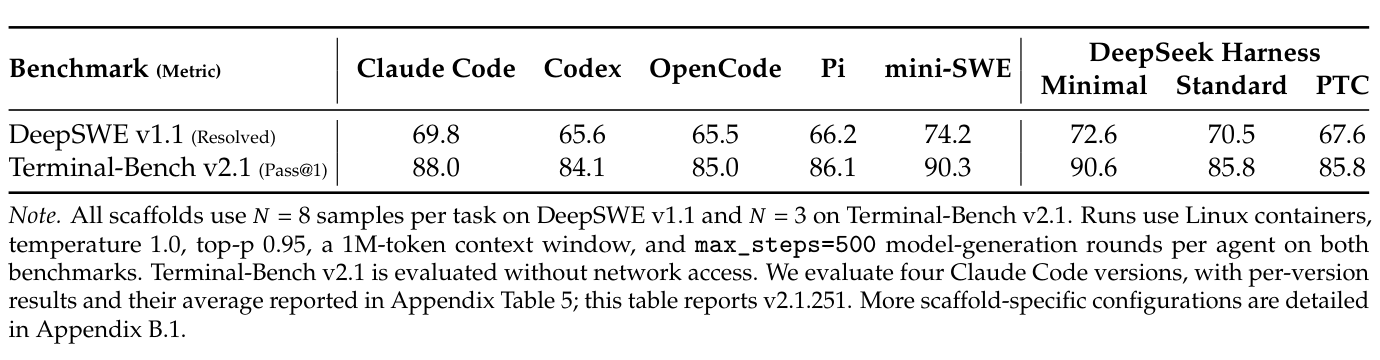
为评估模型对这种变化的鲁棒性,我们比较来自六个 scaffold family 的八种配置:Claude Code(Anthropic, 2026)、Codex(OpenAI, 2026)、OpenCode(Anomaly, 2026)、Pi(Zechner, 2026)、mini-SWE(Yang et al., 2024)以及 DeepSeek Harness(DSH)(DeepSeek-AI, 2026a)的 Minimal、Standard 和 PTC 模式。
对每个 scaffold,我们保持模型 checkpoint、decoding configuration 与任务集完全相同,只改变外部 harness,包括其原生 system prompt、tool schema 和 turn-taking logic。表 4 报告 Max reasoning effort(100)下,在 DeepSWE v1.1 与 Terminal-Bench v2.1 上的性能。
模型的智能体能力能够较好迁移到具有不同 prompt 和工具接口的 scaffold family,而非依赖某个特定 harness 的约定。即使周围交互协议和工具抽象发生变化,性能仍保持稳健。
 原始图 9
图 9|推理强度对性能与输出长度的影响。 每个 panel 绘制 Pass@1(实线、左轴)和每响应平均输出 token(虚线、右轴),reasoning-effort 从 25 变化到 100。推理密集型结果为 8 个 benchmark 的平均值:AIME 2026、Apex 2025 Shortlist、GPQA Diamond、HLE、IMO-AnswerBench、LiveCodeBench、MathArena-Apex、SimpleQA-Verified。DeepSWE v1.1 使用 mini-SWE 评测,Terminal-Bench v2.1 使用 DeepSeek Harness(Minimal)评测。
 原始表 4
表 4|Max reasoning effort 下不同智能体 scaffold 的性能。
| 基准(指标) | Claude Code | Codex | OpenCode | Pi | mini-SWE | DSH Minimal | DSH Standard | DSH PTC |
|---|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 (Resolved) | 69.8 | 65.6 | 65.5 | 66.2 | 74.2 | 72.6 | 70.5 | 67.6 |
| Terminal-Bench v2.1 (Pass@1) | 88.0 | 84.1 | 85.0 | 86.1 | 90.3 | 90.6 | 85.8 | 85.8 |
注。 DeepSWE v1.1 上所有 scaffold 每任务使用 个样本,Terminal-Bench v2.1 上使用 。运行环境均为 Linux container,temperature=1.0、top-p=0.95、1M-token context window;两个 benchmark 中每个 agent 的 max_steps=500。Terminal-Bench v2.1 禁止网络访问。Claude Code 共评测四个版本,逐版本结果与平均值见附录表 5;本表使用 v2.1.251。更多 scaffold 配置见附录 B.1。
这种鲁棒性与第 5 节所述合成训练数据中的环境、tool schema 和交互格式多样性一致,其设计目标正是促进模型跨智能体 scaffold 泛化。
5.3.5. 多智能体
为探索多智能体在复杂任务中的协作,我们使用 DeepSeek Harness 的 Agent Team 模式对 DeepSeek-V4.1-Flash 进行初步实验。
多智能体 harness。 Agent Team 模式下,lead agent 默认可通过 spawn_teammate 异步创建具名、持久化的 teammate。每个 teammate 接受一个委派任务,并以两种模式之一启动:fresh 模式不携带 lead 的历史记录;fork 模式则获得 lead 已完成 turn 的一次性快照。所有 agent 共享同一个 repository checkout,因此任一 agent 的修改都会立即对其他 agent 可见。
agent 之间通过持久化 peer mailbox 通信。使用 send_message 发送的消息,会在运行中 teammate 的下一 step boundary 到达;若 teammate 空闲,则启动一个新 turn;若其处于 inactive,则恢复执行。
在每个 teammate 的任务生命周期中,lead 使用 list_agents 监控运行状态,并通过 wait_agent 等待状态、mailbox 或共享任务发生变化。任务所有权、依赖关系和建议性写入范围由共享 task board 维护,更新时使用四个 team_task_* 工具并进行 revision check。
 原始图 10
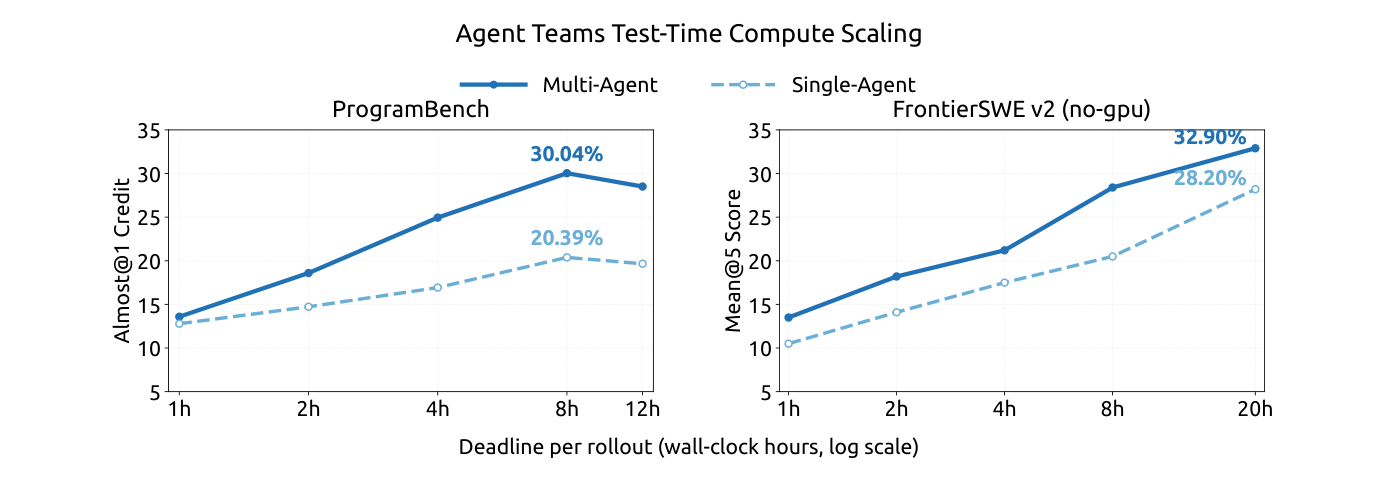
图 10|Agent Team 的 test-time compute scaling。 图中比较 ProgramBench(Almost@1)与 FrontierSWE v2(Mean@5)上单智能体和多智能体配置,横轴为每次 rollout 的 wall-clock deadline。
需要人工干预时,只有 lead 能通过 interrupt_agent 中断 teammate 当前 turn。所有工作完成后,由 lead 检查、测试合并后的修改并生成最终响应。
训练。 Agent Team 模式使用 RL 训练,其 reward 由三部分组成:任务性能、鼓励委派与 agent 间通信的协作 bonus,以及促进高效协作的 derived-latency penalty。
Derived latency 的计算方式是:将执行事件及其协作依赖表示为有向无环图(DAG);根据固定 prefill/decode 速率下的 token 数以及实测工具执行时间为事件赋予成本;最后取关键路径长度。该目标鼓励真正有用的并行,同时惩罚不必要的串行工作和同步,并降低 serving-side batching 与排队延迟对训练信号的敏感度。
性能。 我们从 ProgramBench(Yang et al., 2026)构造一个高置信子集,只保留参考解答在 hidden test suite 上通过率至少 95% 的任务,最终得到 172 个“golden”任务。
还评测 FrontierSWE v2(Kondra et al., 2026),它是 FrontierSWE 的更大、更困难后继版本,并采用显著改进的评测方法。基于当前公开任务,我们排除需要 GPU 的任务,构造 no-GPU 子集。
在两个 benchmark 上,都在明确的 per-rollout wall-clock deadline 下评测单智能体与多智能体配置。这里报告的结果仍属初步:比较观测到的最强多智能体配置与当前最强单智能体基线。
ProgramBench 上,每任务最多运行 3 个 rollout,因此每种配置计划运行 516 个 rollout。指标采用 Almost@1,即单个 rollout 得分至少 0.95 的比例。FrontierSWE v2 报告 Mean@5。ProgramBench deadline 为 1-12 小时,FrontierSWE v2 为 1-20 小时。每个 deadline 点的指标仅基于在该截止时刻已经产生的输出计算。
如图 10 所示,在两个 benchmark 的每一个 deadline 上,多智能体配置都优于相应的单智能体配置。在 ProgramBench 上,多智能体配置的 Almost@1 从 1 小时的 13.59% 提高到 8 小时时的峰值 30.04%,而单智能体配置对应为 12.79% 和 20.39%。在 FrontierSWE v2 上,多智能体配置的 Mean@5 从 1 小时的 13.50% 提高到 20 小时的 32.90%,而单智能体配置则从 10.50% 提高到 28.20%。