DeepSeek-V4.1-Flash:推动 KV 缓存压缩极限
552B 主干参数、100 万 token 上下文的多模态 MoE 模型,把每 token 全局 KV 缓存压到 890 字节。
DeepSeek-AI
research@deepseek.com
摘要
长时程智能体的广泛应用使模型工作负载日益呈现输入密集型特征。尽管既有工作已经显著降低长上下文计算成本,预填充(prefill)的计算开销仍然很高,而大型 KV 缓存继续对 HBM、SSD 容量以及数据传输带宽造成巨大压力。计算、存储与带宽需求共同构成进一步降低部署成本的主要瓶颈。
为应对这一挑战,我们提出 DeepSeek-V4.1-Flash:一个拥有 552B 主干参数、支持最长 100 万 token 上下文的多模态混合专家(Mixture-of-Experts, MoE)模型。借助因果编码器-解码器(Causal Encoder-Decoder, CED)架构,模型在解码阶段每个 token 激活 16B 参数,而预填充阶段仅激活 8B 参数,从而显著提升智能体工作负载下的成本效率。
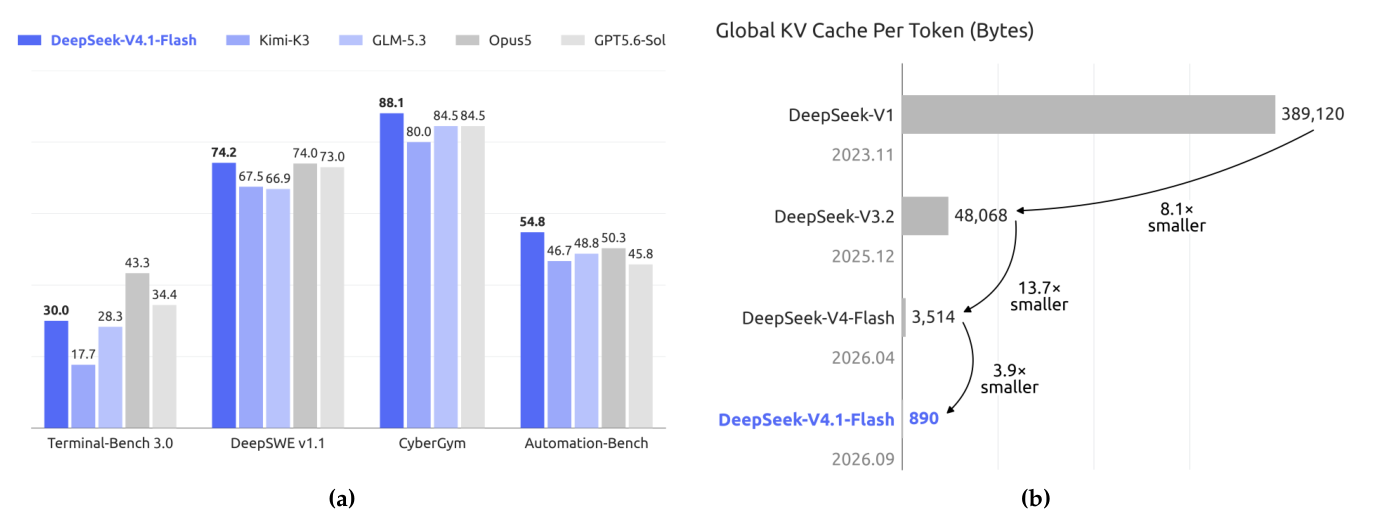
为进一步推动 KV 缓存压缩极限,DeepSeek-V4.1-Flash 将 Compressed Sparse Attention 2(CSA2)中的跨层 KV 缓存复用与 FP4 KV 缓存结合。这些设计将其全局 KV 缓存占用(始终驻留于 HBM)降低到每 token 890 字节,约为 DeepSeek-V4-Flash 对应占用的 1/4。此外,通过专门的部署优化 SWA Bounded Replay,DeepSeek-V4.1-Flash 将持久化 KV 缓存占用(始终位于 SSD 或主机内存中)降低至 DeepSeek-V4-Flash 的约 1/8。
尽管 KV 缓存显著缩小,该模型的性能仍明显优于基线。除此之外,我们简化了 DeepSeek-V4 架构并引入若干高效架构扩展。我们在包含 45T token 的多模态语料上对 DeepSeek-V4.1-Flash 进行预训练,并开展全面的后训练,从而在多种文本与多模态智能体场景中取得强劲性能。模型检查点可在 https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash 获取。
 原始图 1
图 1| (a) DeepSeek-V4.1-Flash 及其同类模型在智能体基准上的性能。(b) 各代 DeepSeek 模型每 token 的全局 KV 缓存大小(字节),体现 DeepSeek 持续降低上下文内存需求的工作。相较 DeepSeek-V4-Flash 和 DeepSeek-V1,DeepSeek-V4.1-Flash 的每 token 全局 KV 缓存大小分别约缩小 4 倍和 437 倍。
目录
-
1 引言 — 4
-
2 架构 — 7
- 2.1 概述 — 7
- 2.1.1 多模态架构 — 8
- 2.2 因果编码器-解码器(CED) — 9
- 2.3 Compressed Sparse Attention 2(CSA2) — 9
- 2.3.1 跨层 KV 与索引复用 — 10
- 2.3.2 分层稀疏索引器 — 11
- 2.4 高效架构扩展 — 12
- 2.4.1 Single-Pass mHC — 12
- 2.4.2 Engram — 13
- 2.4.3 DSpark — 13
- 2.4.4 FP4 主 KV 缓存 — 14
- 2.5 优化 — 14
-
3 通用基础设施 — 16
- 3.1 训练基础设施 — 16
- 3.1.1 多模态训练基础设施 — 16
- 3.1.2 CSA2 的注意力共享训练 — 17
- 3.1.3 Engram — 18
- 3.2 推理系统 — 18
- 3.2.1 持久化 KV 缓存管理 — 19
- 3.2.2 SWA Bounded Replay — 20
-
4 预训练 — 20
- 4.1 数据构建 — 20
- 4.2 预训练设置 — 21
- 4.2.1 模型设置 — 21
- 4.2.2 训练设置 — 22
- 4.3 评测 — 23
- 4.3.1 评测基准 — 23
- 4.3.2 评测结果 — 23
-
5 后训练 — 25
-
5.1 后训练流水线 — 25
- 5.1.1 大规模智能体任务合成 — 25
- 5.1.2 合成任务中的强化学习 — 26
- 5.1.3 超大规模运行智能体:DSec — 27
- 5.1.4 RL 中可控的推理强度 — 29
-
5.2 异步后训练基础设施 — 30
- 5.2.1 整体工作流 — 30
- 5.2.2 缓解长度偏差与离策略效应 — 31
- 5.2.3 性能优化 — 31
- 5.2.4 大规模 On-Policy Distillation — 31
-
5.3 评测 — 32
- 5.3.1 评测设置 — 32
- 5.3.2 评测结果 — 33
- 5.3.3 不同推理强度下的性能 — 34
- 5.3.4 不同智能体脚手架下的性能 — 34
- 5.3.5 多智能体 — 35
-
6 结论、局限与未来方向 — 37
-
A 作者名单 — 46
-
B 评测细节 — 47
- B.1 脚手架配置 — 47
- B.2 各脚手架下的推理强度 — 48
- B.3 不同推理强度下推理基准的详细结果 — 48