4. 预训练
45T token 多模态语料上的数据构建、训练设置与评测。
4.1. 数据构建
文本数据整理。 为追求更高智能水平,我们不再只关注小规模数据实验所反映的单样本质量,而更重视不同语料之间能够带来独特信息增益的整体交互。我们采用更系统、更标准化的数据构建流水线,以提升数据质量并优化数据混合比例。
具体而言,我们基于更全面的评测,精心设计覆盖模型参数量和训练数据规模的 scaling ladder,用于指导大规模训练。我们过滤信息增益有限的模型生成内容,包括能力较弱模型的输出和低质量机器翻译文本。此类内容主要只是对已有信息重新表述,因而可视为隐式重复;在很长训练周期中甚至可能产生负面作用。
我们还探索 model-in-the-loop 的数据迭代方法,作为未来大规模合成数据的基础。此外,我们让更多领域专家参与,构建细粒度的数据质量评测维度。与上一版本相比,新语料纳入了更多来自近期发布的开源仓库、commit、库和新兴框架的代码,以覆盖更广泛的编程语言,并更好地反映当代真实软件工程场景。
多模态数据整理。 我们的多模态预训练数据集主要包含三类数据:图文对、图文交错数据和领域专用数据。基于原始 Web 数据天然包含丰富多模态知识这一前提,我们没有采用大规模数据合成,而是优先清洗并使用数据的原生形式,以在预训练阶段实现最直接、可扩展的视觉知识压缩。
初始数据采集过程中,我们发现爬虫系统过度偏向文本中心的网页内容,因此以 Common Crawl 为基础重新初始化,以提升对多模态来源的覆盖。对于图文数据,我们从网页提取图像及其对应 alt text,依据图文相关性阈值过滤,并基于图像语义去重。
对于图文交错数据,该子集主要来自网页和 PDF。大规模多模态语料的处理通常比纯文本语料需要更多 CPU 和磁盘存储,因此我们将交错数据构建组织为成本逐步提高的多阶段流程。在获取图像之前,先通过启发式与统计过滤、去重和质量模型筛选高价值文档。存留下来的文档随后被组装为图文交错序列,并再次以图像感知方式执行过滤与去重。最后,我们使用 SmolVLM(Marafioti et al., 2025)严格评估图文内容质量,从而提取高质量交错数据。流程中被过滤掉的部分文档还会经筛选与重组,回收为额外的图文对。
为弥补 Web 数据自身的局限,我们还引入领域专用数据集,以增强模型在细粒度视觉感知(例如视觉 grounding 与 pointing)、光学字符识别(OCR)和长尾知识获取方面的能力。同时,我们收集大量图像-代码对和 computer-use 轨迹,以提升多模态智能体理解能力。
数据整合与去重。 由于纯文本数据和多模态数据分别通过独立流水线处理,我们将两者的并集作为最终训练语料。对于重复样本,使用多模态版本替换纯文本版本,并采用两种配置中更大的 epoch 数。完成替换后,最终语料中纯文本 token 与多模态 token 的比例为 7:1。
我们通过联合预取和分配训练样本,尽量减少预训练与上下文扩展期间的样本重叠。超长文档在混合前会以确定性方式预先切分,以保证训练 token 在各数据 shard 和训练 step 上均匀分布。我们还进一步改进 best-fit packing 算法,使 padding rate 不超过
4.2. 预训练设置
4.2.1. 模型设置
Transformer 层数设为 40,隐藏维度 。采用 Causal Encoder-Decoder 架构,编码器 20 层、解码器 20 层。
前两层使用纯滑动窗口注意力。其余 18 个编码器层使用压缩率 的 CSA2,并被划分为三个配置完全相同的 6 层组。每组第一层为 Full Mode,其余 5 层为 Reuse Mode。
20 个解码器层使用压缩率 的 CSA2,并划分为五个 4 层组。第一组中,第一层为 Full Mode,其余三层为 Reuse Mode。剩余四组采用同一配置:第一层为 Reindex Mode,其余三层为 Reuse Mode。
所有 CSA2 层中,索引器 query head 数设为 32,索引器 head 维度为 128,稀疏注意力选择的 KV 条目数(attention top-k)为 512。query head 数为 64,head 维度为 512,query 压缩维度为 1280。
对于 Hierarchical Sparse Indexer,最多选择 2,048 个块,每块 8 个位置,总候选位置最多 16,384 个。输出投影组数设为 8,每个中间注意力输出维度为 1024。额外滑动窗口注意力分支的窗口大小设为 。
所有 Transformer block 均使用 MoE 层。激活函数采用带 clamping 的 SwiGLU(OpenAI, 2025),阈值为 10。每个 MoE 层包含 1 个共享专家和 384 个路由专家,每个专家的中间隐藏维度为 2304。每个 token 会激活 6 个路由专家。
mHC 的 expansion factor 设为 4,Sinkhorn-Knopp 迭代次数为 20。视觉编码器层数为 32,隐藏维度 1024,注意力 head 数 16,图像 patch size 为 14。视觉 MLP projector 含 2 层,隐藏维度为 5120。
在该配置下,DeepSeek-V4.1-Flash 包含 552B 主干参数;预填充阶段每 token 激活 8B 参数,解码阶段激活 16B 参数。
4.2.2. 训练设置
线性变换参数使用 Muon 优化器(Jordan et al., 2024; Liu et al., 2025),所有 RMSNorm 模块权重与其他非矩阵参数使用 AdamW(Loshchilov and Hutter, 2019),所有 embedding 和 prediction head 使用 Sinkhorn-balanced update。
AdamW 超参数为
Muon 的 momentum 为 0.95,weight decay 为 0.1,并将每个更新矩阵的 RMS 重新缩放到 0.18,以复用 AdamW 学习率。
Sinkhorn-balanced update 使用与 Muon 相同的 momentum coefficient 与学习率修正因子,并设
按照 Cheng et al.(2026b),Engram 的学习率扩大 5 倍。我们使用 45T token 的多模态数据训练 DeepSeek-V4.1-Flash,训练过程中未出现不稳定。整个训练期间 batch size 固定为 100.6 million token。
学习率在最初 2,000 step 线性 warm-up,之后维持在 ,直到训练量达到 28T token。28T 到 40T token 之间按 cosine schedule 将学习率衰减至 ;40T 到 45T token 阶段保持该值。
模型从头开始即以 64K 序列长度训练稀疏注意力,并在 34T token 时将序列长度扩展到 1M。无辅助损失负载均衡中,图像与文本 token 的 bias update speed 均设为 0.001;同时保留一个较小的 sequence-level balance loss,权重为 0.0001,以避免单个序列内部出现极端不平衡。与 DeepSeek-V4 类似,预训练期间使用 sample-level attention masking。
视觉编码器训练。 DeepSeek-ViT 在与语言主干整合前会单独经历一个训练阶段。训练流水线包括两个阶段:对比预训练与自回归微调。
对比预训练期间,我们在约 47B 图文对上使用 SigLIP(Zhai et al., 2023)提出的 sigmoid contrastive loss 进行优化,这些数据主要来自 alt-text。为了在如此大规模数据上高效学习视觉表示,我们将最大输入分辨率限制为 像素;更大图像在保持长宽比的同时下采样。
虽然该阶段使用更高分辨率可以获得明显局部收益,但实验表明这些收益对最终模型贡献很小。后续自回归阶段会专门处理高分辨率外推,因此在对比预训练期间提高分辨率会显著增加计算成本,却不能带来相应的整体收益。
自回归微调阶段,我们将视觉编码器连接到一个 4B MoE LLM,并在包含图像 caption、alt text、chart 和 OCR 等数据的 236B token 上,以 next-token prediction 为目标进行训练。该阶段旨在增强编码器对细粒度视觉特征的建模能力。因此,我们将输入分辨率限制在 至 像素之间,对超出范围的图像按比例缩放。
该阶段结束后,我们丢弃 LLM,只保留已优化的视觉编码器,供后续预训练流水线使用,并继续沿用相同的输入分辨率策略。
4.3. 评测
4.3.1. 评测基准
我们将 DeepSeek-V4.1-Flash-Base 与前代模型 DeepSeek-V4-Flash-Base 和 DeepSeek-V4-Pro-Base 比较。评测覆盖五个关键维度:世界知识、语言理解与推理、编码与数学、长上下文、多模态能力。
世界知识基准包括 AGIEval(Zhong et al., 2023)、MMLU-Pro(Wang et al., 2024b)、C-Eval(Huang et al., 2023)、MultiLoKo(Hupkes and Bogoychev, 2025)、SimpleQA-Verified(Haas et al., 2025)和 SuperGPQA(Du et al., 2025)。
语言理解与推理基准包括 BigBench Hard(BBH)(Suzgun et al., 2022)、BigBench Extra Hard(BBEH)(Kazemi et al., 2025)、DROP(Dua et al., 2019)和 HellaSwag(Zellers et al., 2019)。
编码与数学基准包括 BigCodeBench(Zhuo et al., 2025)、HumanEval(Chen et al., 2021)、GSM8K(Cobbe et al., 2021)、MATH(Hendrycks et al., 2021)和 MGSM(Shi et al., 2023)。
长上下文基准包括 LongBench-V2(Bai et al., 2025)。
多模态基准包括 MMMU-Pro(Yue et al., 2025)、DocVQA(Mathew et al., 2021)、CVBench(Tong et al., 2024)以及 RefCOCO/RefCOCO+/RefCOCO-g(Kazemzadeh et al., 2014; Nagaraja et al., 2016; Mao et al., 2016; Yu et al., 2016)。
4.3.2. 评测结果
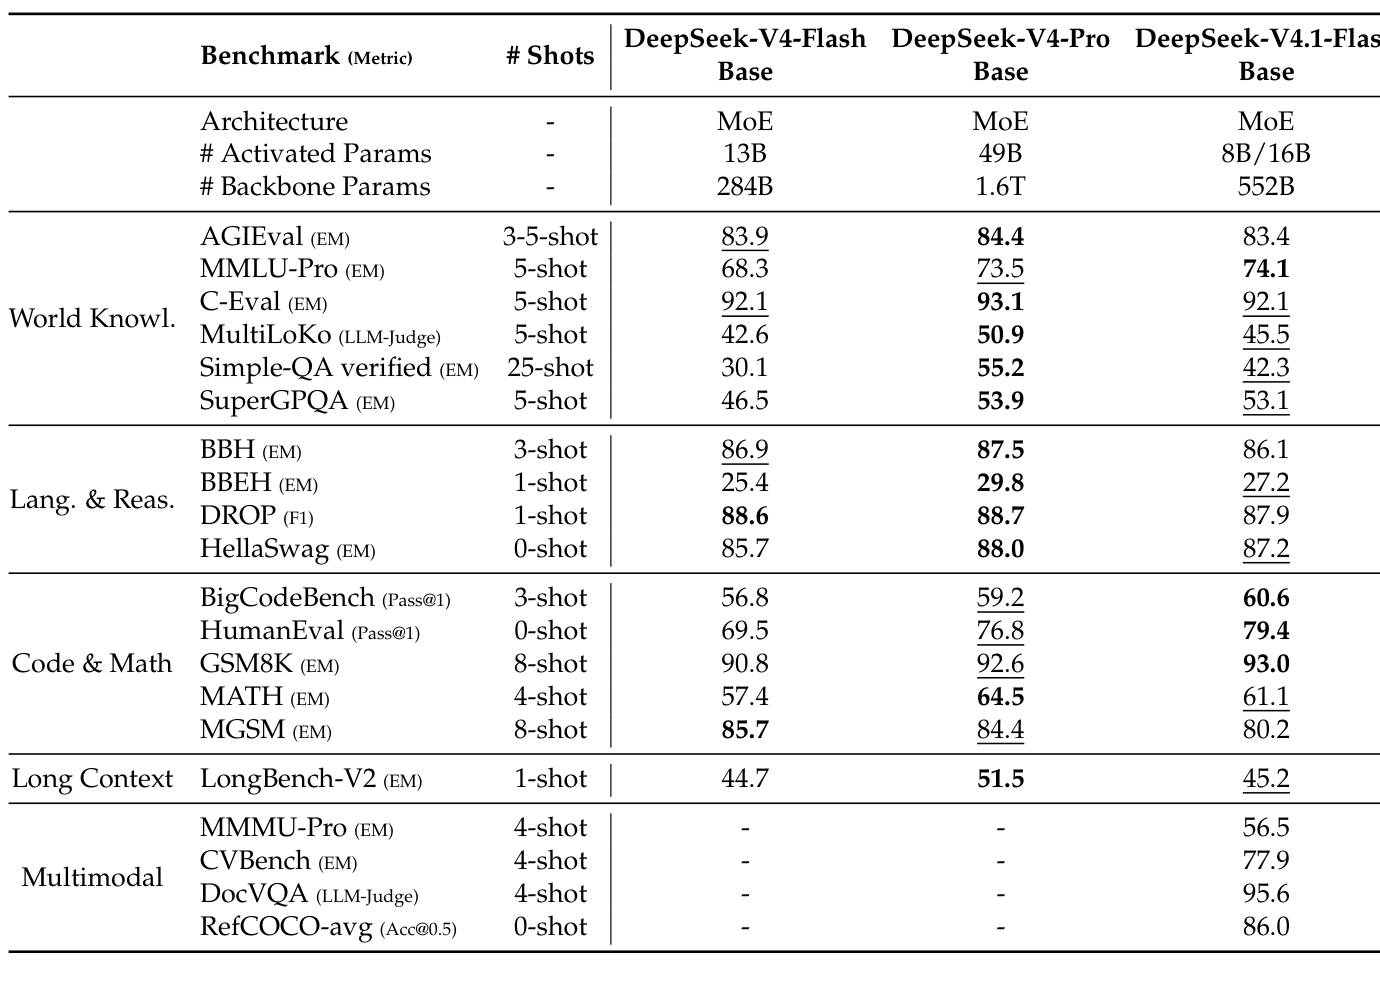
表 1 给出了 DeepSeek-V4-Flash、DeepSeek-V4-Pro 与 DeepSeek-V4.1-Flash 三个基础模型的详细比较。三者均在内部评测框架下、以严格受控且可复现的相同设置评测。与 DeepSeek-V4-Flash-Base 和 DeepSeek-V4-Pro-Base 相比,最新基础模型体现出显著效率提升。DeepSeek-V4.1-Flash 的激活参数量远小于 DeepSeek-V4-Pro-Base,KV 缓存也显著缩小,但性能仍与前代模型处于同一水平或更优。
 原始表 1
表 1|DeepSeek-V4-Flash-Base、DeepSeek-V4-Pro-Base 与 DeepSeek-V4.1-Flash-Base 对比。 所有模型均在我们的内部框架中评测,并采用相同的评测设置。分差不超过 0.3 的分数视为处于同一水平。每行最高分以粗体标示,第二高分以下划线标示。
| 基准(指标) | Shots | DeepSeek-V4-Flash Base | DeepSeek-V4-Pro Base | DeepSeek-V4.1-Flash Base |
|---|---|---|---|---|
| 架构 | - | MoE | MoE | MoE |
| 激活参数量 | - | 13B | 49B | 8B/16B |
| 主干参数量 | - | 284B | 1.6T | 552B |
| 世界知识 | ||||
| AGIEval (EM) | 3-5-shot | 83.9 | 84.4 | 83.4 |
| MMLU-Pro (EM) | 5-shot | 68.3 | 73.5 | 74.1 |
| C-Eval (EM) | 5-shot | 92.1 | 93.1 | 92.1 |
| MultiLoKo (LLM-Judge) | 5-shot | 42.6 | 50.9 | 45.5 |
| Simple-QA verified (EM) | 25-shot | 30.1 | 55.2 | 42.3 |
| SuperGPQA (EM) | 5-shot | 46.5 | 53.9 | 53.1 |
| 语言与推理 | ||||
| BBH (EM) | 3-shot | 86.9 | 87.5 | 86.1 |
| BBEH (EM) | 1-shot | 25.4 | 29.8 | 27.2 |
| DROP (F1) | 1-shot | 88.6 | 88.7 | 87.9 |
| HellaSwag (EM) | 0-shot | 85.7 | 88.0 | 87.2 |
| 编码与数学 | ||||
| BigCodeBench (Pass@1) | 3-shot | 56.8 | 59.2 | 60.6 |
| HumanEval (Pass@1) | 0-shot | 69.5 | 76.8 | 79.4 |
| GSM8K (EM) | 8-shot | 90.8 | 92.6 | 93.0 |
| MATH (EM) | 4-shot | 57.4 | 64.5 | 61.1 |
| MGSM (EM) | 8-shot | 85.7 | 84.4 | 80.2 |
| 长上下文 | ||||
| LongBench-V2 (EM) | 1-shot | 44.7 | 51.5 | 45.2 |
| 多模态 | ||||
| MMMU-Pro (EM) | 4-shot | - | - | 56.5 |
| CVBench (EM) | 4-shot | - | - | 77.9 |
| DocVQA (LLM-Judge) | 4-shot | - | - | 95.6 |
| RefCOCO-avg (Acc@0.5) | 0-shot | - | - | 86.0 |
这些结果也反映了预训练数据整理流水线的显著改进。本版本引入原生多模态训练,并通过对应多模态评测验证其有效性。经过更多样化的多模态语料训练后,DeepSeek-V4.1-Flash 的世界知识与理解能力已与 DeepSeek-V4-Pro 相当;在推理和编码基准上也持续进步,多项指标接近或超过 DeepSeek-V4-Pro。
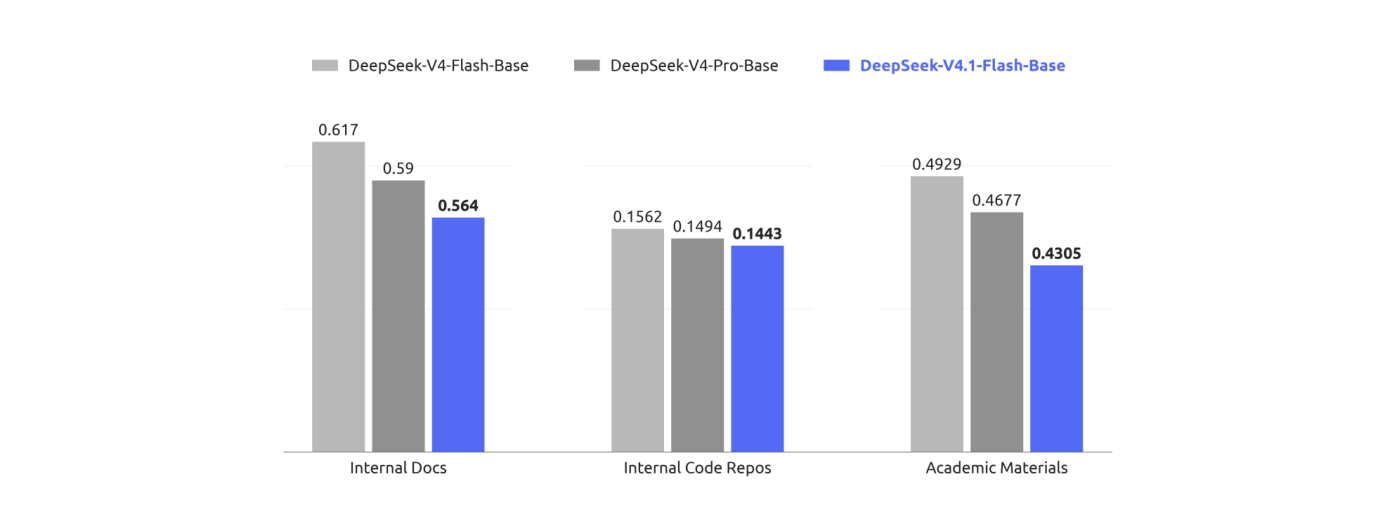
为进一步评估真实研发场景中的模型能力,我们还在专门的内部语料上进行困惑度测试。由于通过模型 API 无法进行 perplexity 测试,因此主要比较自有预训练基础模型。评测集合基于日常研发过程独立收集,包括内部文档、专有代码仓库与学术材料,重点考察复杂科学问题和前沿研究中的推理、归因和问题解决能力。
结果见图 6。我们报告不同模型的 bits-per-byte(BPB),数值越低表示性能越好。
 原始图 6
图 6| DeepSeek-V4-Flash-Base、DeepSeek-V4-Pro-Base 与 DeepSeek-V4.1-Flash-Base 在保留评测集上的 bits-per-byte(BPB)对比。DeepSeek-V4.1-Flash-Base 在所有任务上均取得最低 BPB,显示其作为强基础模型具有更大潜力。