1. 引言
长时程智能体负载下的成本挑战与 DeepSeek-V4.1-Flash 的总体思路。
背景与挑战
近年来,长时程智能体的应用快速扩展,使超长上下文处理成为越来越重要的模型工作负载。支持这类工作负载不仅要求高效处理长序列,还要求对大型 KV 缓存进行持久化存储、复用与传输。因此,KV 缓存管理已成为模型部署的一项基础能力,同时也在计算、存储和通信方面带来显著挑战。此前稀疏注意力方面的进展(DeepSeek-AI, 2025, 2026b)已经大幅降低长序列处理的计算成本,使持久化存储与数据移动日益成为主要瓶颈。
DeepSeek-V4 的 KV 缓存约束
具体而言,DeepSeek-V4(DeepSeek-AI, 2026b)将覆盖完整上下文的全局注意力分支与局部滑动窗口注意力(Sliding-Window Attention, SWA)结合。全局分支维护全局 KV,其中包括主 KV 和索引器 K;SWA 则维护局部 KV 状态。在窗口大小固定时,SWA KV 的存储量与序列长度无关并受到上界约束。当序列足够长时,全局 KV 因而主导运行时 KV 占用,而其容量受到 HBM 的限制。此外,一部分 KV 会被持久化以支持前缀复用,我们将其称为持久化 KV 缓存,其容量受到 SSD 和主机内存限制。I/O 与互连带宽同样限制缓存迁移和加载。综合而言,这些约束限制服务吞吐量、提高部署成本,并最终阻碍智能体在更长任务时程及更广泛应用场景中的部署与普及。
DeepSeek-V4.1-Flash 概览
因此,进一步降低 KV 缓存占用对于缓解存储与通信瓶颈、降低长上下文服务成本至关重要。为此,我们开发了 DeepSeek-V4.1-Flash,这是一种面向更激进 KV 缓存压缩而设计的多模态 MoE 模型。DeepSeek-V4.1-Flash 拥有 552B 主干参数,原生支持多模态输入,并支持最长 100 万 token 的上下文。我们采用因果编码器-解码器(CED)架构,其中解码器的全局 KV 由编码器最后一层隐藏状态投影得到。该设计使模型在预填充阶段每个 token 仅激活 8B 参数、解码阶段激活 16B 参数,因此尤其适合输入密集型智能体场景。尽管 DeepSeek-V4.1-Flash 的模型规模显著大于 DeepSeek-V4-Flash,但在相同序列长度下,其运行时 KV 缓存存储量仅约为后者的 1/4,持久化 KV 缓存存储量仅约为后者的 1/8。同时,DeepSeek-V4.1-Flash 的总体性能也优于 DeepSeek-V4-Flash。
全局 KV 压缩核心设计:CSA2 与 FP4 缓存
这种程度的 KV 缓存压缩来自模型架构、缓存精度与部署策略的联合优化。从概念上看,DeepSeek-V4 可以视为一个基于 SWA 的局部处理主干,再辅以压缩后的全局上下文。基于这一视角,我们主要简化全局分支,同时基本保留局部注意力设计。在架构层面,我们设计 Compressed Sparse Attention 2(CSA2),对全局 KV(包括主 KV 和索引器 K)以及 Top-K 索引实施跨层复用,从而显著降低 KV 缓存存储量。CSA2 具有三种静态分配的模式:Full、Reindex 和 Reuse。Full Mode 生成全局 KV 并执行索引;Reindex Mode 复用前一层的全局 KV,并使用自身索引器 Q 对共享索引器 K 重新打分以选择新的 Top-K 索引;Reuse Mode 同时复用前一层的全局 KV 和 Top-K 索引,直接执行稀疏注意力。在三种模式下,每一层都保留自身的全局 Q 与 SWA KV。共享全局 KV 和索引器 K 可减少重复缓存存储。
此外,与采用 Compressed Sparse Attention(CSA)-Heavily Compressed Attention(HCA)混合架构的 DeepSeek-V4 不同,DeepSeek-V4.1-Flash 使用纯 CSA2。在缓存精度方面,我们在训练期间使用 FP4 全局 KV 缓存,仅造成极小的性能下降。CSA2 与 FP4 KV 缓存共同构成其全局 KV 压缩的核心。
 原始图 2
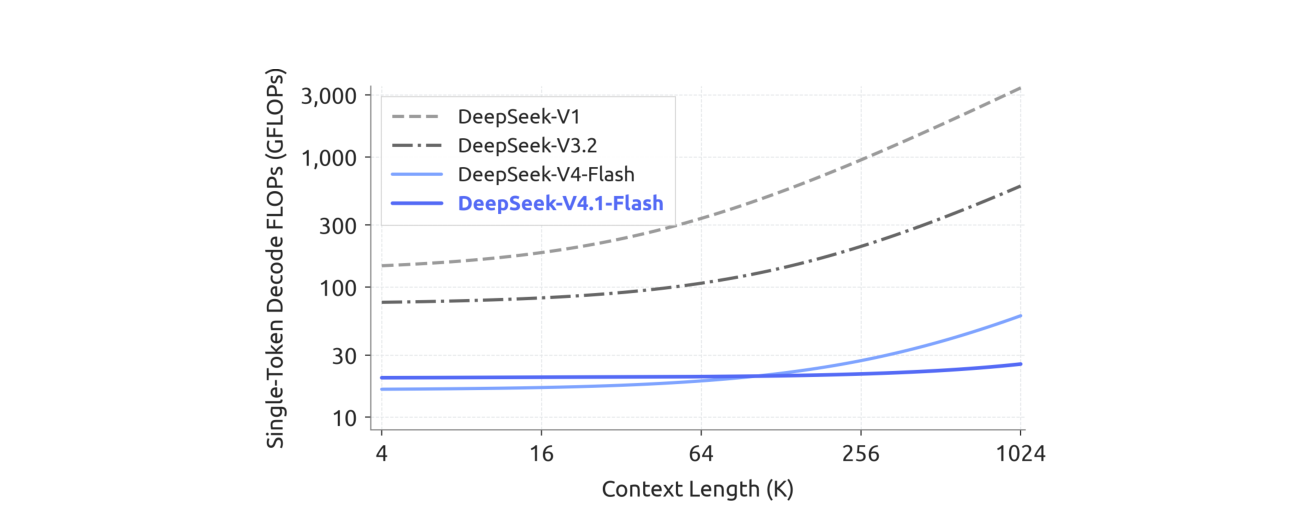
图 2| 各代 DeepSeek 模型的单 token 解码 FLOPs 与上下文长度之间的关系。为计入计算精度差异,我们分别按 1、0.5、0.25 的权重计算 BF16、FP8 和 FP4 运算。随着上下文长度增加,DeepSeek-V4.1-Flash 的 Decode FLOPs 基本保持不变,从而显著降低长上下文场景中的计算成本。
SWA Bounded Replay
如图 1(b) 所示,CSA2 与 FP4 KV 缓存将全局 KV 缓存存储量降低至 DeepSeek-V4-Flash 的约 1/4。在部署层面,DeepSeek-V4.1-Flash 与 DeepSeek-V4 一样,在每一层都采用滑动窗口注意力(SWA)。在 DeepSeek-V4 中,我们采用混合策略,在持久化 SWA KV 缓存的存储成本与精确重建所需计算之间进行权衡。精确重建要求重放最近的 个 token,其中 是层数, 是 SWA 窗口大小。
在 DeepSeek-V4.1-Flash 中,我们提出 SWA Bounded Replay:仅重放最近的 个 token,以近似重建所需的 SWA KV 状态。实验表明,该方法只会造成可忽略的性能下降。这一发现建立了一种新的存储-计算权衡,使我们能够不再将 SWA KV 缓存持久化到 SSD,只需承担少量预填充重计算。借助 SWA Bounded Replay,持久化 KV 缓存占用进一步降至 DeepSeek-V4-Flash 的约 1/8。这些优化显著缓解 HBM 与 SSD 容量压力,降低部署成本,并为更大规模部署创造条件。
其他架构简化
作为 CED 与 CSA2 的补充,我们进一步简化原始 DeepSeek-V4 架构。我们还将原始 mHC(Xie et al., 2026)升级为 Single-Pass mHC,并配套设计 Mega-mHC 部署内核,相较原先的四内核实现将激活内存流量减半。此外,我们集成 Engram(Cheng et al., 2026b)条件记忆模块以增强模型能力,并引入 DSpark(Cheng et al., 2026a)推测解码架构,通过半自回归草稿生成与置信度调度验证提高解码效率。
恒定的 Decode FLOPs
结合全部架构改进后,DeepSeek-V4.1-Flash 的单 token Decode FLOPs 在不同上下文长度下基本保持恒定。图 2 显示,当上下文长度从 4K 扩展至 1M,即增加 256 倍时,其 Decode FLOPs 仅增加约 1/4,显著小于 DeepSeek-V4-Flash 的增长幅度。
训练与推理系统协同优化
为充分释放这些架构设计带来的 KV 缓存压缩收益,并进一步提高训练与推理效率,我们对 DeepSeek-V4.1-Flash 的训练基础设施和推理系统进行系统性的协同优化,以支持高效、可扩展的大规模多模态训练和长上下文部署。训练基础设施支持解耦式视觉编码器执行、长序列中的均衡图像分片,以及面向注意力复用的跨流水线阶段共享状态管理。推理系统则实现编码器和解码器两条 SWA Bounded Replay 路径。
进一步的优化还包括通信-计算重叠、分片 Engram 嵌入表以及推理内核融合。尤其是,每个 CSA2 Reuse Mode 层在预填充时只执行 15 个内核,在解码时只执行 11 个内核。我们还在主机内存中将长生命周期的全局 KV 存储与短生命周期的编码器 SWA KV 分离,并通过有界重放近似重建缺失的编码器 SWA 状态。
预训练与后训练
预训练阶段,我们在一个包含 45T token 的大规模多模态语料上训练 DeepSeek-V4.1-Flash。稀疏注意力从序列长度 64K 开始直接从头训练,不使用任何稠密注意力预热阶段。预训练完成后,模型具备原生多模态能力,并支持最长 100 万 token 的上下文。在评测中,DeepSeek-V4.1-Flash-Base 的世界知识、推理和编码能力与 DeepSeek-V4-Pro-Base 相当,并在保留评测上取得 5%-10% 的提升,同时仅使用后者 1/3 的总参数量和 1/4 的激活参数量。这些结果体现出较强的参数效率,也反映了训练数据质量面向真实部署场景的提升。
在该基础模型之上,我们进行后训练,以激发其推理与智能体能力。与上述架构创新不同,我们的后训练没有引入算法创新:训练方案遵循标准范式,即监督微调(SFT)之后进行强化学习(RL)和 on-policy distillation(OPD),除了 DeepSeek-V4 开发过程中已经采用的成熟实践外,不再增加额外修改(DeepSeek-AI, 2026b)。所有实质性变化都集中在数据流水线上。我们开发了大规模自动化的数据合成与环境构建流水线,并逐步扩大 RL 使用的数据、任务和 rollout 规模,从而扩展模型在文本、多模态和智能体领域的能力。
智能体基准性能特征
图 1(a) 汇总了 DeepSeek-V4.1-Flash 在核心智能体基准上的性能。评测显示,尽管模型规模较紧凑,DeepSeek-V4.1-Flash 仍呈现出鲜明的能力特征:
- 推理。 模型具备强推理能力,在数学、竞赛编程等高强度推理基准上保持较高准确率,性能与 Kimi-K3(Team et al., 2026a)和 DeepSeek-V4-Pro 等顶级开源模型相当。
- 智能体。 在 Terminal-Bench 2.1(Merrill et al., 2026)、DeepSWE v1.1(DataCurve, 2026)和 AutomationBench(Shepard and Salimans, 2026)等标准智能体基准上,DeepSeek-V4.1-Flash 达到与闭源前沿模型相当的水平。其已能够充分处理日常编码任务和白领工作流。不过,在 Terminal-Bench 4.0(Marten et al., 2026a)等需要专家级领域知识的科学型智能体任务上,与超大模型之间仍存在差距。
- 多模态。 在多模态领域,模型在视觉推理和专业图表理解基准上超过 Kimi-K3 等顶级开源竞争者。除正式指标外,它还在真实视觉智能体工作流中体现出实际价值,例如前端开发和办公自动化,可利用渲染后的屏幕截图进行视觉检查和自我纠正。不过,与超大型闭源系统相比,整体性能仍存在明显差距。
这些结果表明,DeepSeek-V4.1-Flash 已能在绝大多数基准上匹配闭源前沿模型,并能够完成超过 95% 的真实世界任务。同时,其较小的激活参数占用带来较低推理延迟和服务成本。因此,我们认为 DeepSeek-V4.1-Flash 在能力与效率之间实现了较有利的权衡,可作为快速、低成本的助手支持广泛用户的日常工作。
 原始图 3
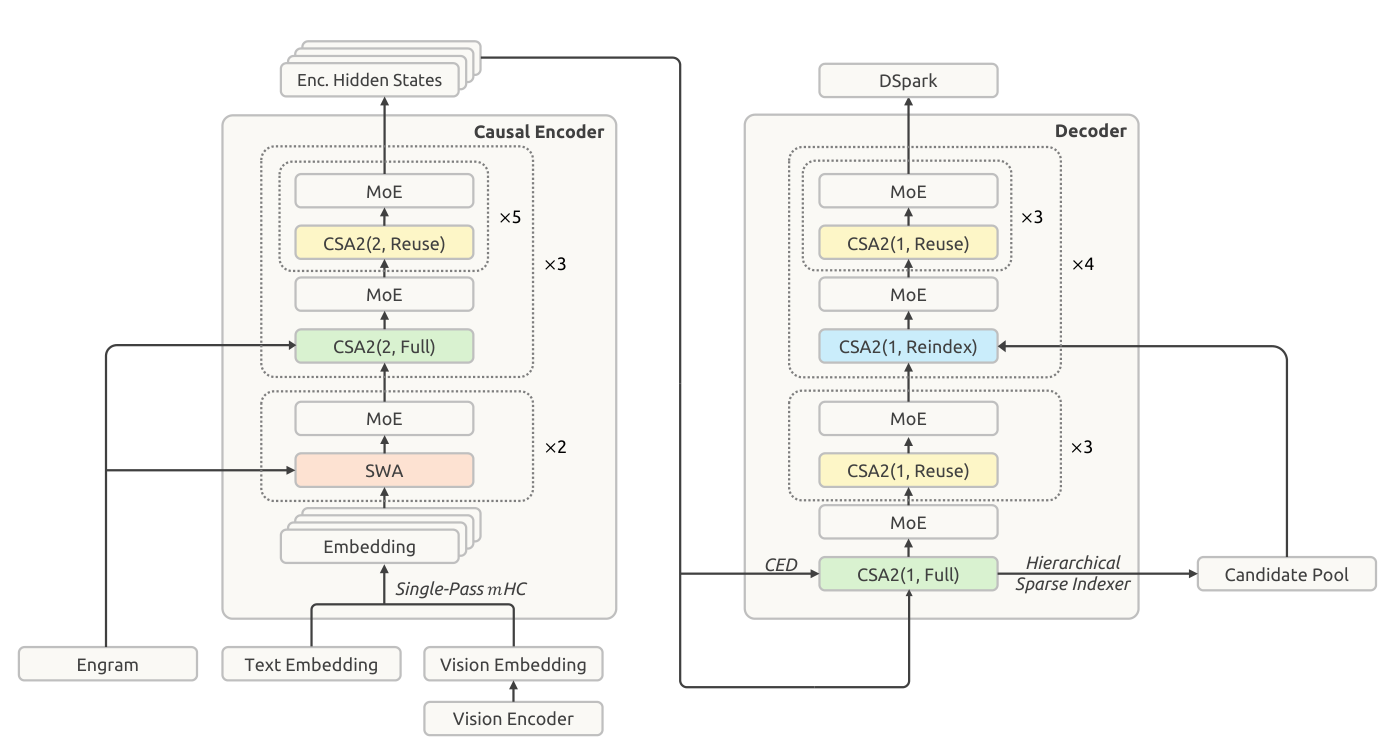
图 3|DeepSeek-V4.1-Flash 总体架构。 40 层网络被划分为因果编码器和解码器,各包含 20 层。所有前馈层均采用标准 DeepSeekMoE。编码器前两层使用滑动窗口注意力(SWA),其余层使用 Compressed Sparse Attention 2(CSA2),其中 CSA2(ratio, mode) 表示压缩率与模式。模型还采用 Single-Pass mHC、Engram、DSpark 和分层稀疏索引器(Hierarchical Sparse Indexer)。
总体而言,DeepSeek-V4.1-Flash 在提升模型智能水平和推理效率的同时降低了部署成本。它显著降低了大规模部署长时程智能体的成本门槛,为更广泛场景中的采用创造了新的可能。DeepSeek-V4.1-Flash 也构成我们继续扩展模型规模的新起点。在此基础上,我们将继续联合扩展模型架构、预训练和后训练,以进一步探索模型智能的前沿。