AI 智能体长期记忆:Memory Bank
AI agent long-term memory with memory bank · Google Cloud Tech · 中文讲座报告 以 15 张视频关键帧与英文人工字幕重建讲座实况:让智能体在数天乃至数周内保持一致、具备上下文感知。
AI agent long-term memory with memory bank · Google Cloud Tech · 中文讲座报告 以 15 张视频关键帧与英文人工字幕重建讲座实况:让智能体在数天乃至数周内保持一致、具备上下文感知。
本报告还原 Google Cloud「Agent Memory」系列第三集。讲者 Annie Wang 从服务角色划分讲起,演示如何用 Vertex AI Memory Bank 为智能体建立跨会话、跨媒体类型的长期记忆:会话结束时归档整段对话,或直接把图像、视频、音频写入记忆库;新对话开始时由 PreloadMemory 工具自动做语义检索,把相关事实注入提示词。文中幻灯片文字以视频帧截图为准(SCREENSHOT),讲者口述来自英文人工字幕(CC),表格与文字流程图为编辑性归纳(EDITORIAL)。
1. 讲座元信息
| 项目 | 内容 |
|---|---|
| 议题名称 | AI agent long-term memory with memory bank |
| 讲者 | Annie Wang — Software Engineer, Google Cloud |
| 频道 | Google Cloud Tech |
| 系列 | Agent Memory 系列第 3 集(共 3 集) |
| 发布 | 2026 年 4 月 16 日 |
| 时长 | 6 分 43 秒 |
| 录播 | https://www.youtube.com/watch?v=KZPo15M2DbM |
| 演示代码 | memory_agent(main.py / terminal 实机演示) |
| 动手资源 | https://goo.gle/agentmemorylab |
2. 证据边界与阅读方式
| 标记 | 含义 | 阅读方式 |
|---|---|---|
SCREENSHOT | 视频关键帧可直接核验的幻灯片文字、代码与终端输出 | 以嵌入帧截图为准 |
CC | 讲者口述,来自英文人工字幕 | 保留口述边界,不扩写为官方文档结论 |
EDITORIAL | 本报告的组织性说明、表格归纳与文字流程图 | 帮助阅读,不新增技术主张 |
官方未发布独立讲稿。下文嵌入的 15 张图均为录播视频的关键帧截图,版权归 Google Cloud 所有,本站仅用于教育性评论与引用;需要观看实机画面时,请使用原始 YouTube 链接并跳到图注中的时间码。
3. 系列定位与学习目标
图 1 · 00:01 · 标题页。本集主题:长期记忆与 Memory Bank。
本集是系列收官:第一集讲短期记忆(sessions & state,“记住本次对话”),第二集讲持久化记忆(database,“跨重启存活、个性化新对话”),第三集讲长期记忆(memory bank,“归档对话与媒体、按语义检索”)(SCREENSHOT)。
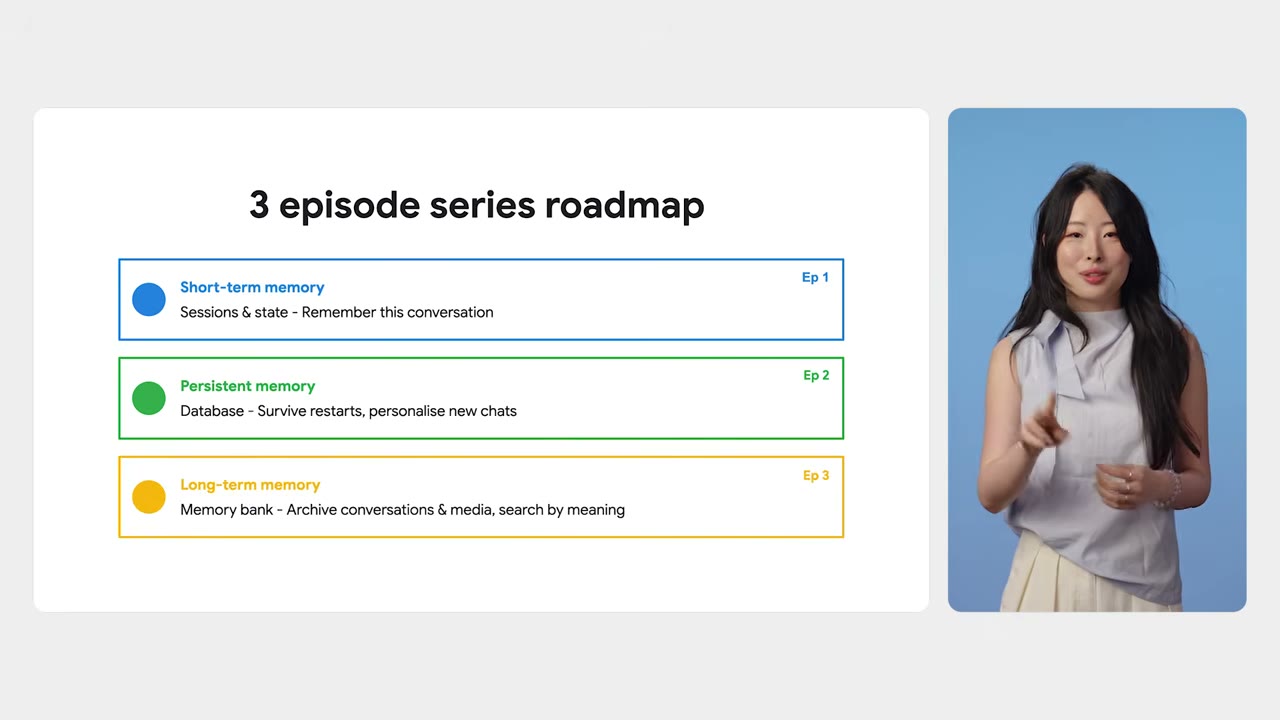
图 2 · 00:14 · 系列路线图:Ep.1 短期记忆、Ep.2 持久化记忆、Ep.3 长期记忆(本集)。
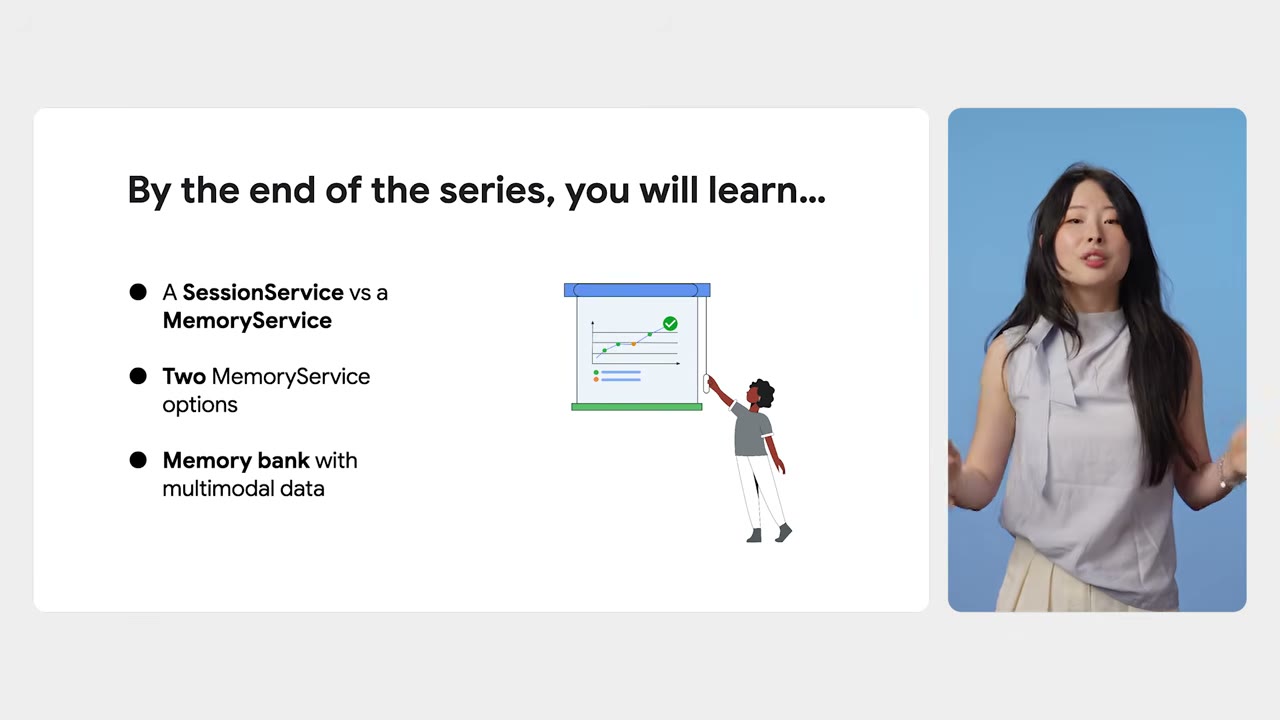
图 3 · 00:56 · 学习目标:区分 SessionService 与 MemoryService;掌握两种 MemoryService 选项;构建含多模态数据的 Memory Bank。
学习目标有三条:区分 SessionService 与 MemoryService;了解两种 MemoryService 选项;以及构建一个能容纳多模态数据的 Memory Bank(SCREENSHOT)。讲者同时预告本集将覆盖:会话服务与记忆服务的差异、内存版与 Vertex AI Memory Bank 的取舍、整段会话与媒体文件的写入方式,以及新对话中用 PreloadMemory 工具自动检索相关事实(CC)。
4. 两个服务角色:Session vs Memory
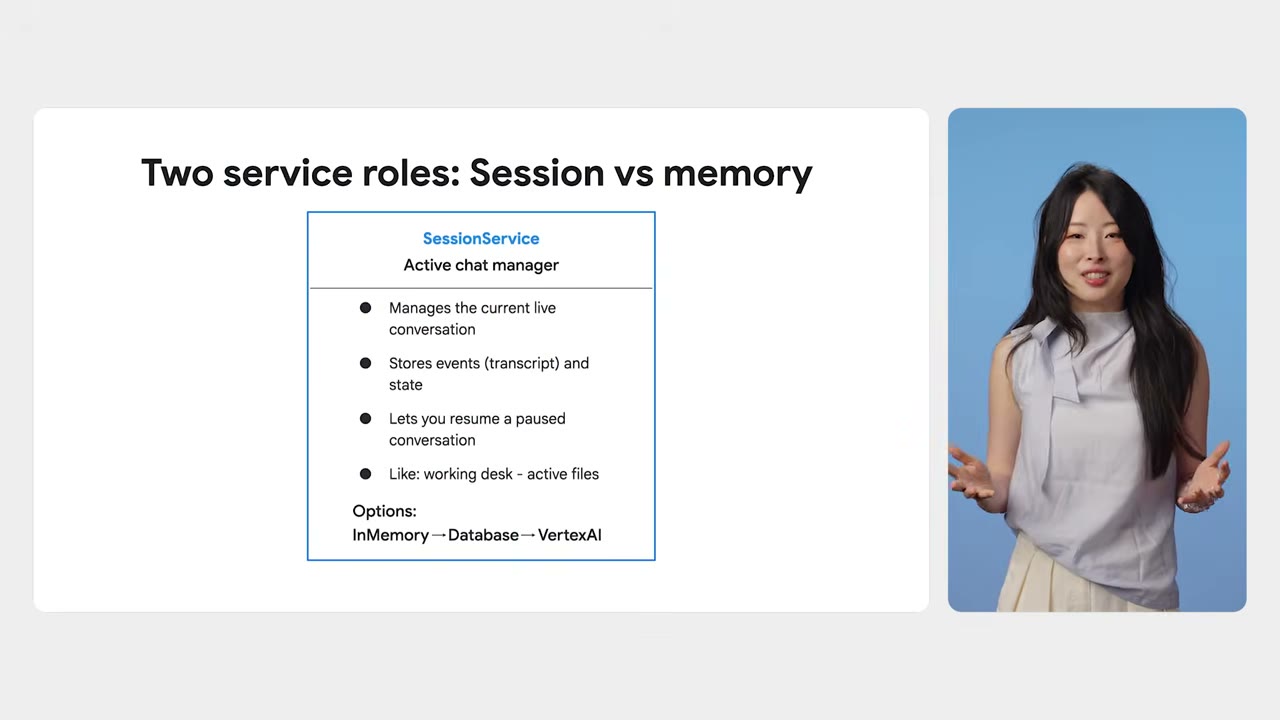
图 4 · 01:16 · 服务角色页。SessionService 是”活跃聊天管理器”:管理当前实时会话、保存事件与状态、可恢复暂停的会话,类似”工作态——正在处理的文件”。
构建个性化智能体之前,先厘清两类服务角色。SessionService 管理活跃聊天,使进行中的对话可以被恢复;MemoryService 管理长期归档,是”档案柜”(CC)。幻灯片把 SessionService 描述为活跃聊天管理器:管理当前实时会话、保存事件(转录)与状态、允许恢复暂停的会话,类比”工作态——活跃文件”,可选实现包括 InMemory、Database 与 VertexAI(SCREENSHOT)。
5. MemoryService 的两种选项
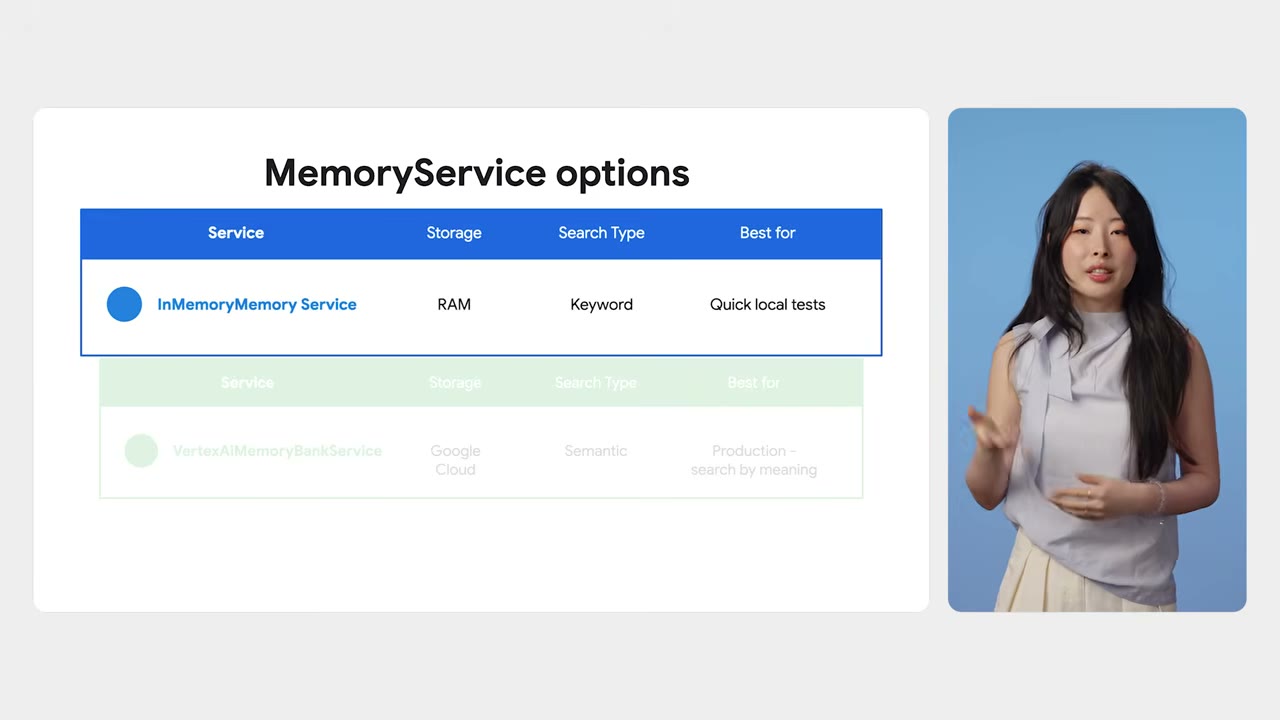
图 5 · 01:40 · 选项对照表:InMemoryMemoryService 存于 RAM、关键词检索、适合快速本地测试;VertexAiMemoryBankService 存于 Google Cloud、语义检索、适合生产环境。
记忆服务有两种实现路线。简单的内存版(InMemoryMemoryService)适合快速本地测试:存于 RAM、关键词检索、重启即失;Vertex AI Memory Bank 服务(VertexAiMemoryBankService)存于 Google Cloud、支持语义检索、面向生产(SCREENSHOT)。语义检索的含义是”按含义而非字面匹配”:幻灯片举例,查询”two-wheeled vehicle”(两轮车辆)能够命中”user owns a bicycle”(用户拥有自行车)这条记忆,而关键词检索会漏掉它(SCREENSHOT + CC)。
| 服务 | 存储 | 检索类型 | 适用 |
|---|---|---|---|
| InMemoryMemoryService | RAM | 关键词(Keyword) | 快速本地测试 |
| VertexAiMemoryBankService | Google Cloud | 语义(Semantic) | 生产环境按语义检索 |
6. Vertex AI Memory Bank 架构与配置
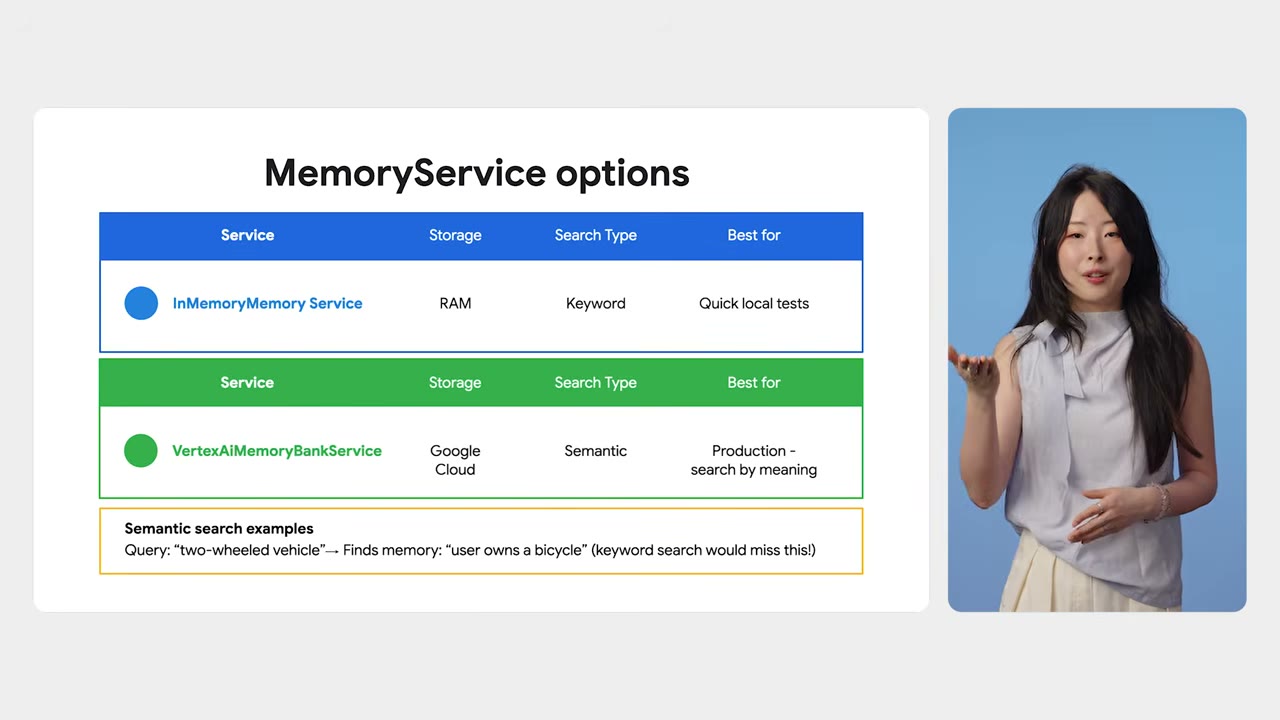
图 6 · 01:52 · 架构页:会话与媒体经 Gemini 抽取事实、经 Agent Engine 嵌入,写入带主题(Preferences、Facts、Experiences、Credentials)的 Memory Bank。
本集选用 Vertex AI Memory Bank 服务与 Vertex AI 会话服务,二者由 Agent Engine 驱动:用 Gemini 抽取事实、生成嵌入,存储的不仅是文本而是语义(CC)。架构图显示两条流水线——“Gemini 抽取事实”与”Agent Engine 嵌入事实”——汇入 Memory Bank(Agent Engine),并以主题组织存储内容,如偏好、事实、经历与凭证(SCREENSHOT)。
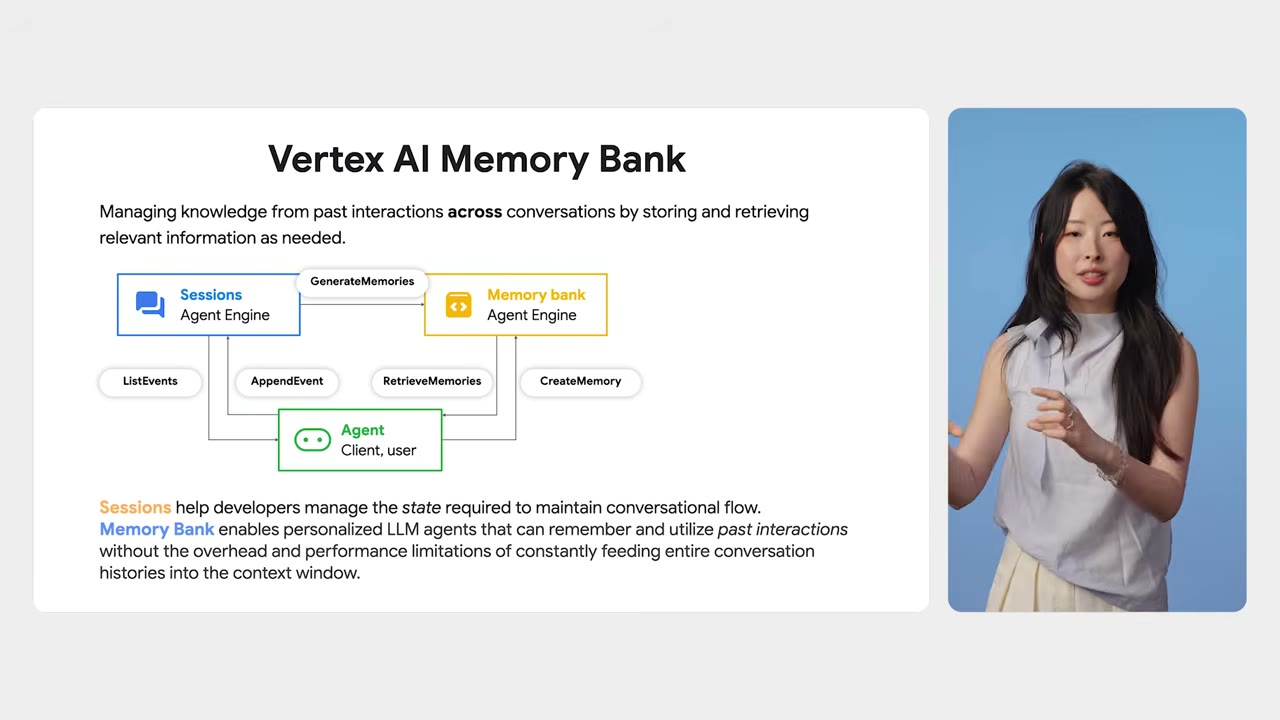
图 7 · 02:10 · 配置代码:AgentEngine.create 指定抽取模型与嵌入模型;同一 engine 同时驱动 VertexAiSessionService 与 VertexAiMemoryBankService。
配置 Memory Bank 即配置驱动它的 Agent Engine:选择两类模型,一类从对话与媒体中抽取事实,另一类把事实嵌入为向量以支持按语义检索;还可以定义主题来组织存储内容,如用户偏好与旅行经历(CC + SCREENSHOT)。代码页强调:同一引擎内同时挂载两个服务时,它会处理内容、抽取事实并使其可检索——“这不仅仅是一张表,而是一个服务”(SCREENSHOT)。
7. 写入记忆:两条路径
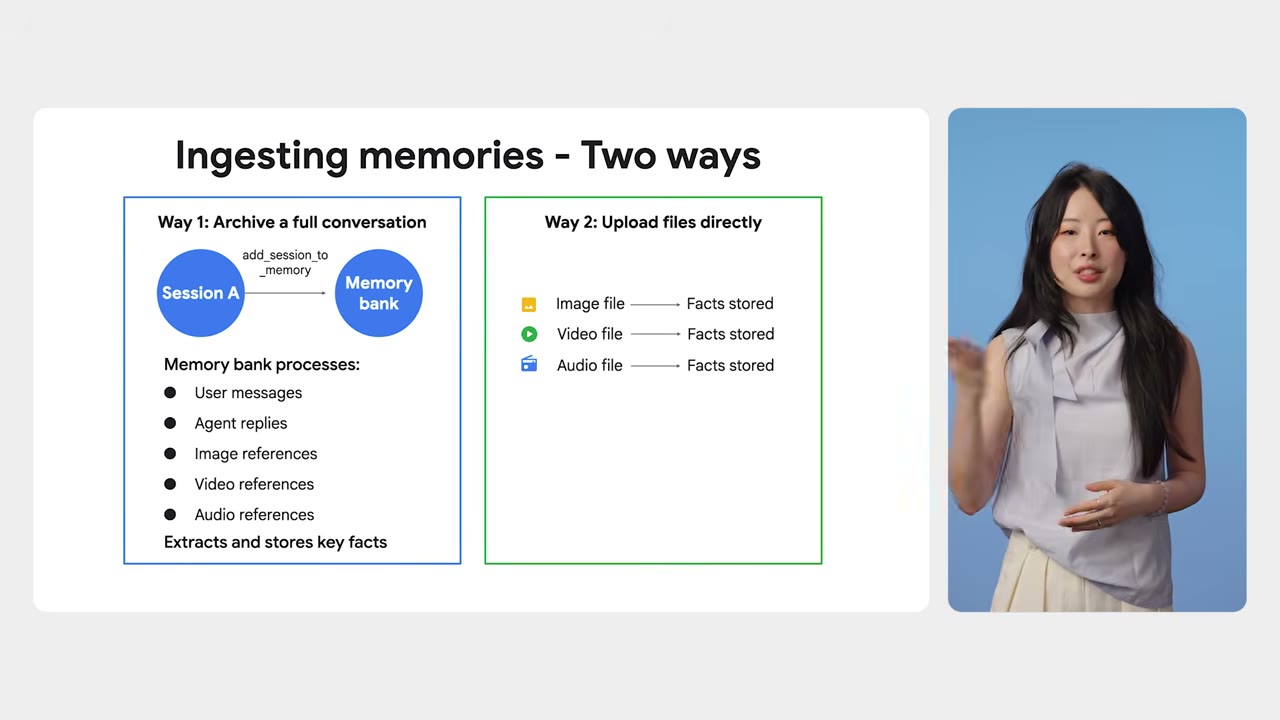
图 8 · 03:30 · 写入两路径。Way 1:会话结束调用 add_session_to_memory,归档整段对话;Way 2:直接上传图像/视频/音频文件,事实直接存储。
写入记忆有两条路径。第一条是在会话结束时归档整段对话:调用 add_session_to_memory,Memory Bank 处理用户消息、智能体回复以及图像、视频、音频引用,抽取并存储关键事实。第二条是直接上传文件:图像、视频、音频文件连同文本上下文直接生成并存储事实,即使这些文件并非来自某次聊天(SCREENSHOT + CC)。无论哪条路径,目标都是构建一个智能体日后可用的长期知识库(CC)。
Way 1 · 归档整段对话                    Way 2 · 直接上传文件
session ──add_session_to_memory──►      image / video / audio file ──►
        │                                        │
        ▼                                        ▼
Memory bank processes:                    Facts stored directly
· User messages                           (可附带文本上下文)
· Agent replies
· Image / video / audio references
        │
        ▼
Extracts and stores key facts
8. 检索记忆:PreloadMemory 工具
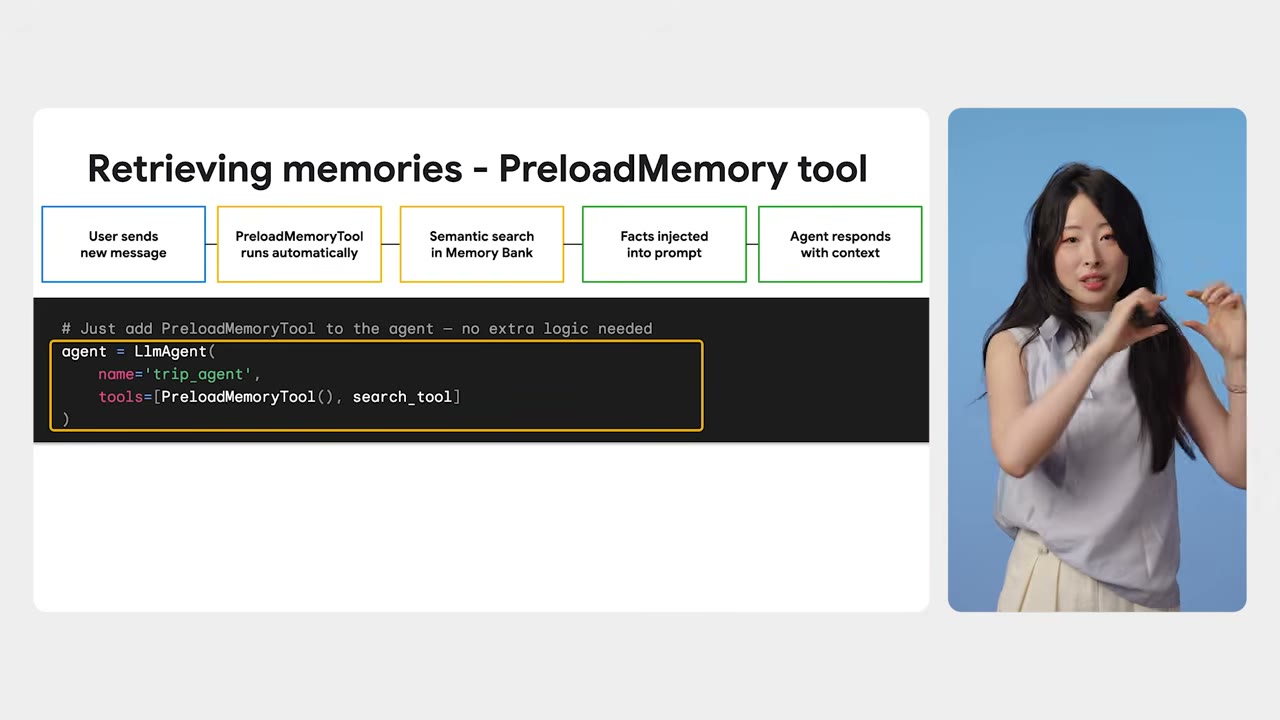
图 9 · 04:04 · 检索页:用户新消息 → PreloadMemory 自动运行 → 语义检索 Memory Bank → 事实注入提示词 → 智能体带上下文回应。代码中只需把 PreloadMemoryTool 加入工具列表。
知识库就绪后,检索由 PreloadMemory 工具自动完成:它在每一轮开始时运行——回应之前读取用户新消息、在 Memory Bank 中执行语义检索、收集最相关的事实并注入提示词;智能体本身无需任何特殊逻辑(SCREENSHOT + CC)。代码页显示只需把 PreloadMemoryTool 加入智能体工具列表,“no extra logic needed”(SCREENSHOT)。
User sends new message
        │
        ▼
PreloadMemory tool runs automatically(每轮开始、回应之前)
        │  语义检索 Memory Bank
        ▼
Relevant facts injected into prompt
        │
        ▼
Agent responds with context(无需特殊逻辑)
9. 演示:跨会话多模态召回
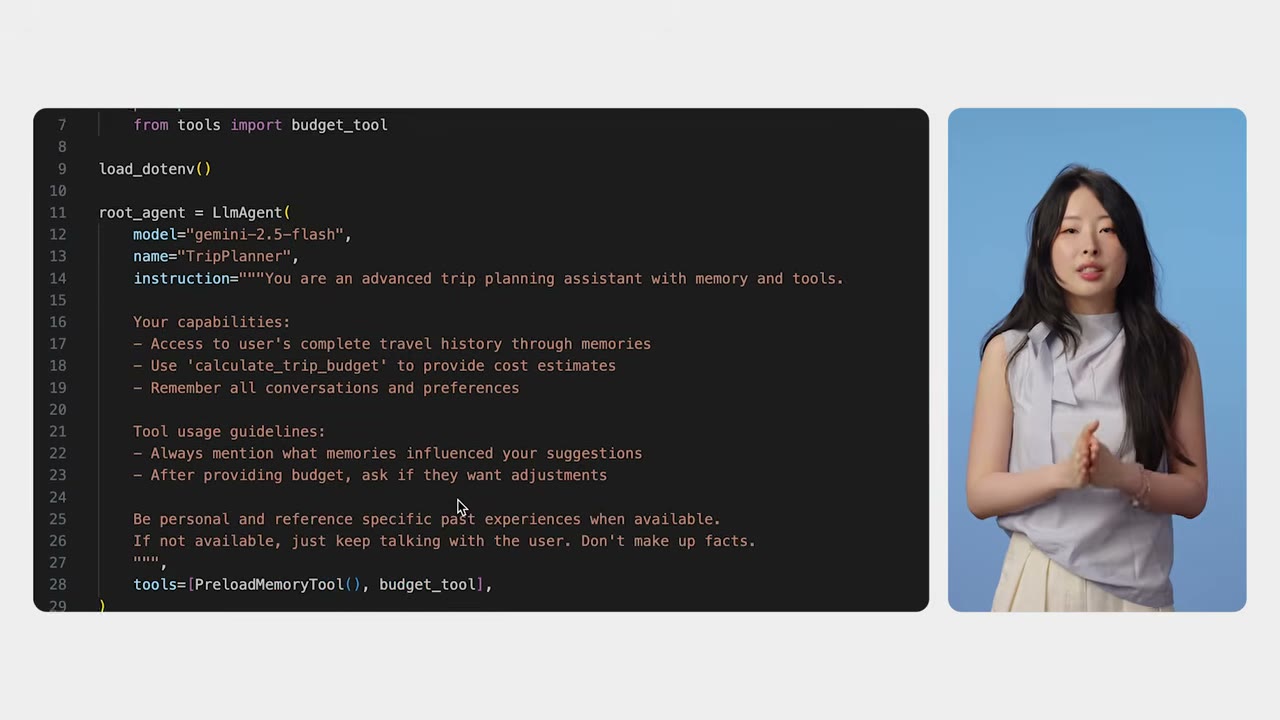
图 10 · 04:21 · 会话 A 的共享媒体之一:历史建筑画面(另有海边短视频与小镇音频便签)。
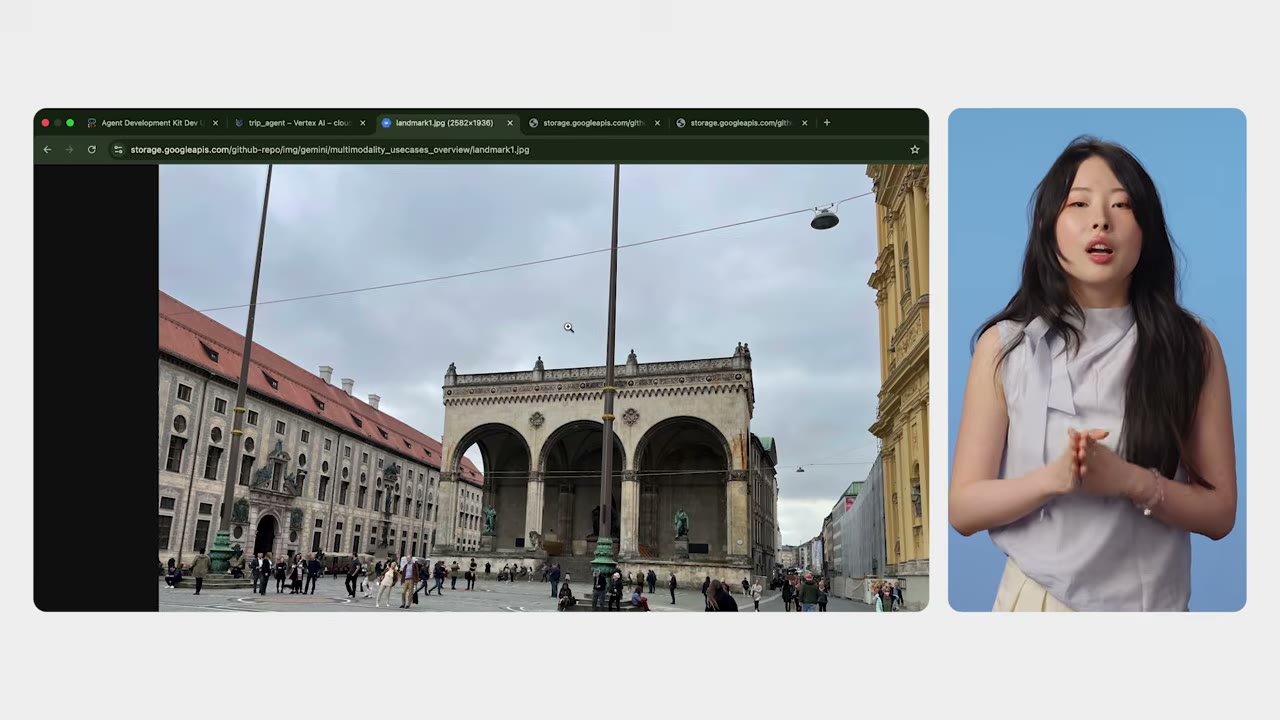
图 11 · 04:28 · 会话 A 代码:发送图片、视频、音频后,调用 add_session_to_memory 归档会话。
演示分两个会话。会话 A 中,用户分享一张历史建筑照片、一段海边短视频和一条小镇音频便签;随后结束聊天并调用 add_session_to_memory 归档(CC + SCREENSHOT)。引擎抽取出”历史建筑""享受海岸""到访过小镇”等事实;接着模拟重启与时间流逝(CC)。
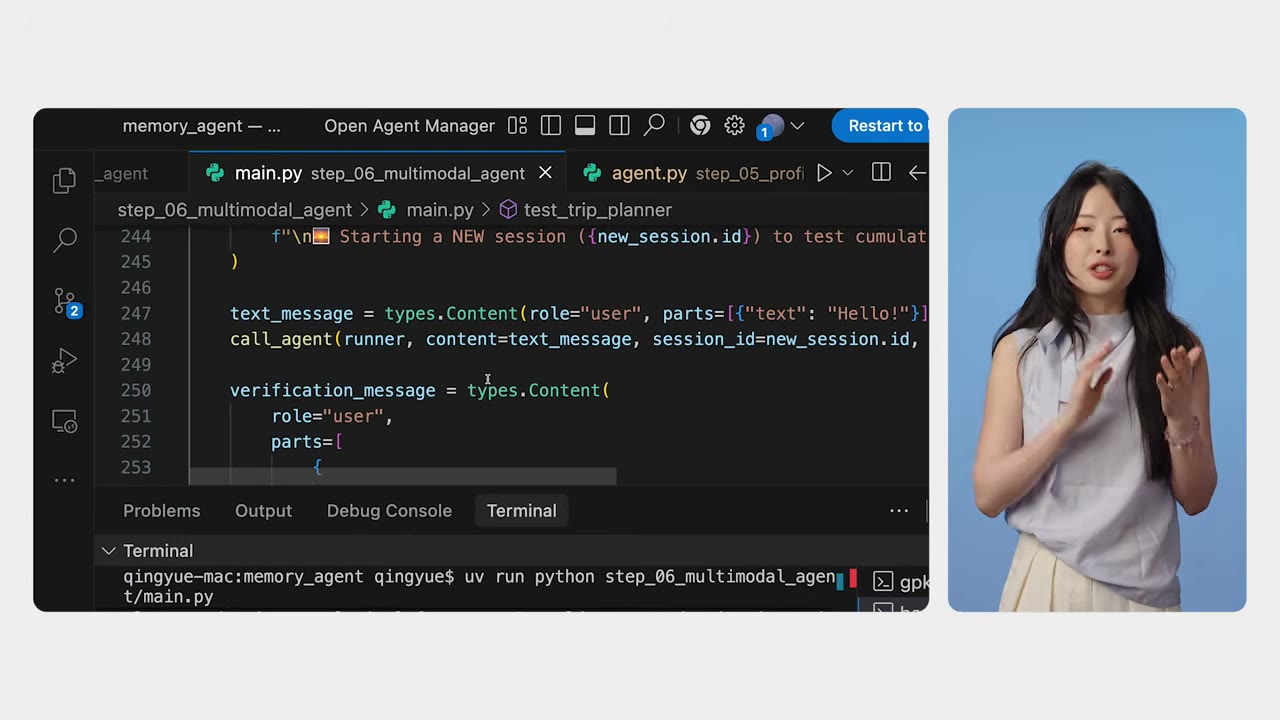
图 12 · 04:56 · 会话 B 代码:全新会话(空状态)提问”基于我之前分享的图片、视频和音频,推荐一个文化目的地”。
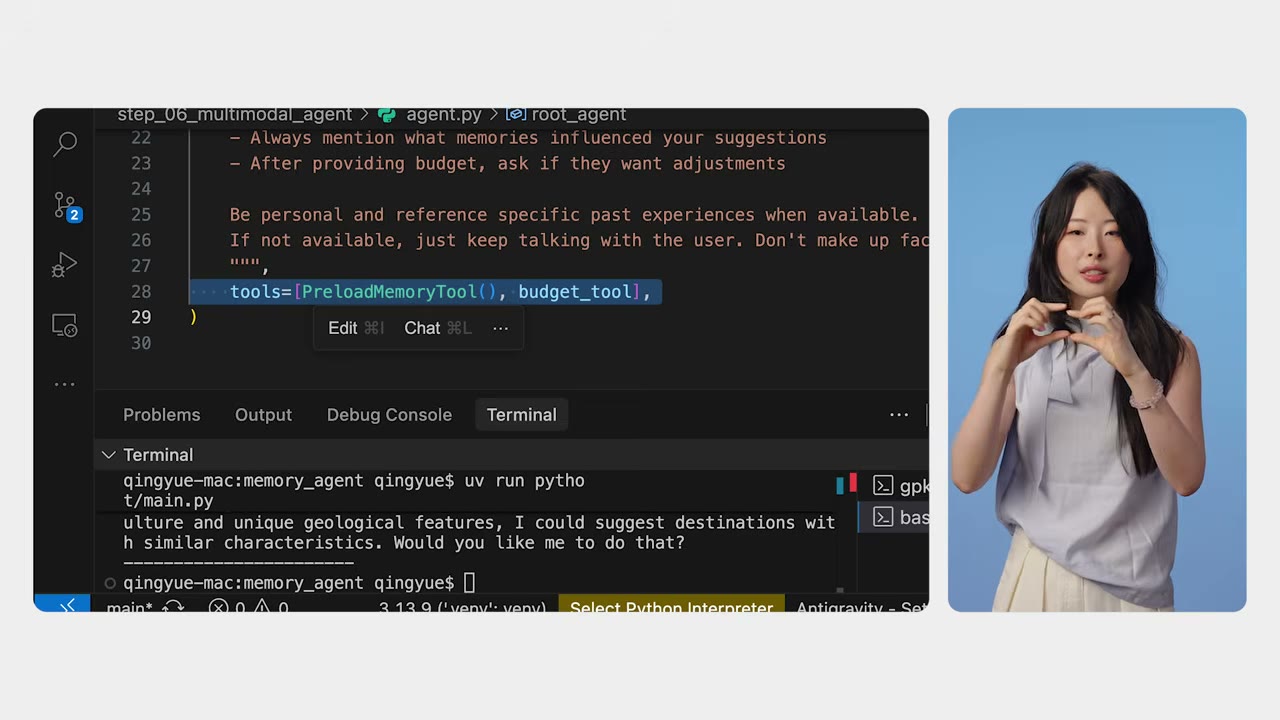
图 13 · 05:16 · 终端输出:PreloadMemory 注入记忆后,智能体推荐与历史建筑、海滨偏好相匹配的文化目的地。
会话 B 是一个状态为空的全新对话:用户提问”基于我之前分享的图片、视频和音频,能否推荐一个文化目的地?“回应之前,PreloadMemory 检索 Memory Bank 并注入”用户喜欢历史建筑、喜爱海滨地区、到访过小镇”等记忆;智能体继而给出匹配的个性化推荐(CC + SCREENSHOT)。终端输出显示,智能体明确”基于你之前的分享”给出建议——这正是长期多模态召回的实际运作(SCREENSHOT)。
10. 系列总结:三层记忆
图 14 · 05:40 · 三层记忆总结:短期工作记忆(InMemorySessionService)、持久化记忆(DatabaseSessionService + 用户偏好工具)、长期多模态记忆(VertexAiMemoryBankService + PreloadMemoryTool)。
三集系列收束为三层记忆体系:
| 层 | 角色 | 实现(幻灯片) |
|---|---|---|
| 短期记忆 | 实时聊天期间的工作记忆 | InMemorySessionService —— 快速、同一会话跨轮次 |
| 持久化记忆 | 跨重启存活、个性化新对话 | DatabaseSessionService + recall/save_user_preferences 工具 |
| 长期记忆 | 归档整段对话与媒体、按语义召回 | VertexAiMemoryBankService + PreloadMemoryTool —— search by meaning |
有了这三层,智能体便能在数天乃至数周内保持一致、具备上下文感知(CC)。
11. 收尾与动手资源
图 15 · 06:18 · 结束页。完整演示与安装步骤见视频描述与 goo.gle/agentmemorylab。
讲者以屏幕链接与二维码(goo.gle/agentmemorylab)提供完整演示与安装步骤,并邀请观众尝试后反馈想构建的下一个应用(CC + SCREENSHOT)。对工程师而言,本集可带走的结论是:会话与记忆是两种不同的服务角色;生产环境的长期记忆应选择云端语义检索的 Memory Bank;写入靠”归档会话 + 直接上传”两条路径,检索靠 PreloadMemory 在每轮开始时自动注入事实——智能体代码无需为记忆编写特殊逻辑(EDITORIAL)。
12. 来源与说明
- 录播视频:https://www.youtube.com/watch?v=KZPo15M2DbM,Google Cloud Tech 频道,2026-04-16 发布,时长 6:43。
- 字幕证据:英文人工字幕(CC)json3,2026-08-06 检索下载。
- 图像证据:本地下载 720p 视频流后以 ffmpeg 抽取 15 张关键帧,存于
public/images/agent-memory-bank/;帧截图版权归 Google Cloud 所有,仅用于教育性评论与引用。 - 时间码以 4 秒网格定位,误差约 ±2 秒;代码页小字在 720p 下部分不清晰,正文只转述可核验部分。
- 官方未发布独立讲稿;文中表格与文字流程图为编辑性归纳(
EDITORIAL),不新增技术主张。