AI Engineering Skills Map 2026:四项核心能力的技术体系、理论框架、工程实践与学习路线
本文以 2026 年 AI Engineering Skills Map 为基础,系统讨论构建与部署 AI 应用、软件工程基础、Coding Agents 与 Shaping the Build 四项能力,并将它们统一为由规格、实现、执行、评测和反馈组成的概率性系统工程闭环。
执行摘要
本报告在 DeepLearning.AI 2026 年提出的 AI Engineering Skills Map 基础上进行系统扩展。原 Skills Map 依据超过 10,000 个招聘职位、专家及招聘方访谈、调查与在线数据归纳出四项核心能力[1]。本报告进一步综合 40 余项官方标准、研究报告、原始论文和 2025–2026 工程一手材料,形成面向开发者、技术负责人和招聘方的能力框架。
最重要的结论:2026 年的 AI Engineering 已经从“模型调用与 Prompt”转向“概率性系统工程与 Agent-native 软件工程”。模型能力快速上升,但生产可靠性仍主要取决于软件工程、Context、Harness、Verifier、Sandbox、Observability 和产品约束。最有价值的人才不是单纯“会用最强模型”的人,而是能把开放式 AI 能力放入可测、可控、可审计闭环,并决定什么值得构建的人。
摘要
DeepLearning.AI 于 2026 年 8 月提出的 AI Engineering Skills Map,将现代开发者最重要的 AI 工程能力归纳为四项:构建与部署 AI 应用、软件工程基础、使用 Coding Agents、Shaping the Build(塑造构建对象与范围)。该框架的直接证据来自超过 10,000 个招聘职位、结构化专家访谈、招聘经理与 Recruiter 调研以及在线数据综合分析[1]。本报告在此基础上进行扩展研究,结合 2026 Stanford AI Index、DORA、METR、NIST、ISO、OWASP、MCP/A2A 标准、OpenTelemetry 以及 OpenAI、Anthropic、Google、GitHub 的一手工程资料,系统讨论四项能力在 2026 年的技术边界、理论基础、知识结构、工程要求、学习路线和人才评估方法。
报告的核心结论是:2026 年 AI Engineering 的竞争优势已经不再主要来自“会调用模型”或“会写提示词”,而来自将概率性模型置于可靠的软件闭环之中。决定系统上限的对象正在从单一模型扩展为“模型 + 上下文 + 工具 + Agent Harness + 执行环境 + Verifier + 观测与治理”的复合系统。Stanford 2026 AI Index 显示,SWE-bench Verified 的领先表现一年内从约 60% 上升到接近 100%,但 OSWorld 等真实计算机任务的成功率仍约为三分之二,体现了能力的显著非均匀性;同时,组织 AI 使用率达到 88%,但业务功能中的 Agent 部署仍普遍处于个位数比例[2][3]。这意味着行业处于“能力快速上升、可靠性基础设施仍不足”的阶段。
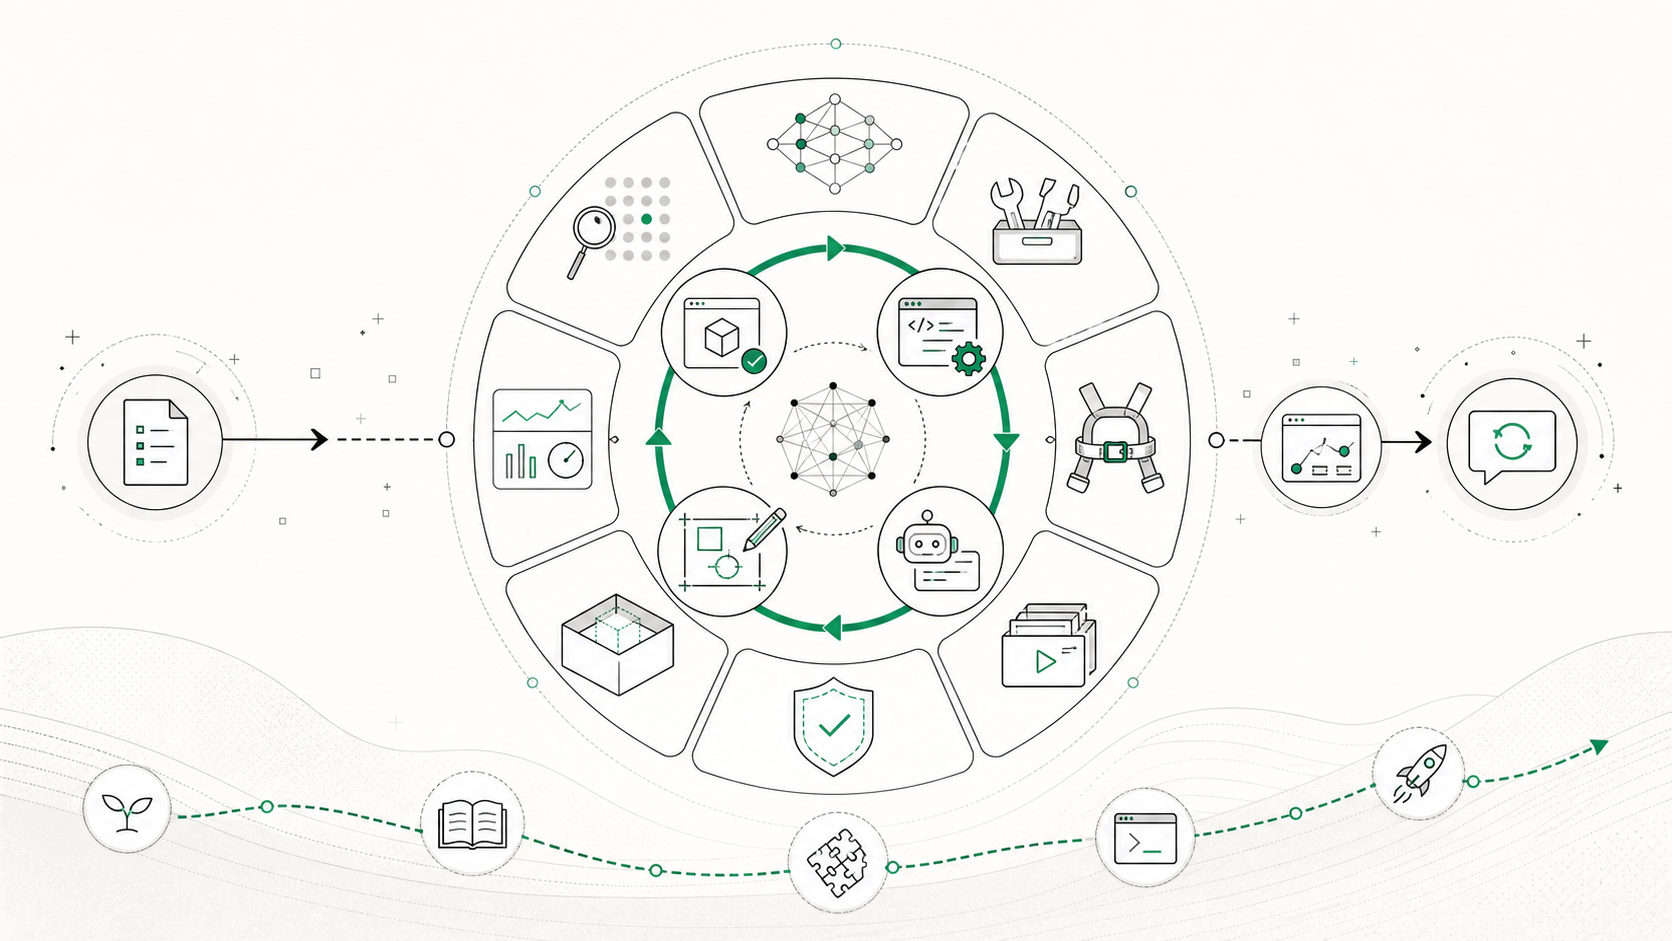
本报告提出一个面向 2026–2028 的能力模型:AI 工程师需要同时具备概率性系统工程(eval、RAG、工具调用、Agent、观测)、传统软件工程(架构、数据、测试、安全、SRE)、Agent 编排与 Harness Engineering(上下文、任务分解、验证器、沙箱、并行执行)以及产品/业务塑形(问题定义、约束、验收标准、风险、迭代)的能力。四项能力不是并列的知识清单,而是一个闭环:Shaping 定义目标和约束;软件工程设计确定性边界;AI 应用工程管理概率性行为;Coding Agents 扩大执行杠杆;Evals、生产数据与用户反馈再反哺下一轮 Shaping。
关键词
AI Engineering;Coding Agent;Agent Harness;Context Engineering;RAG;Evals;Software Engineering;MCP;A2A;Agent Security;Product Shaping;2026
1. 引言
1.1 研究背景
2022 年的主流生成式 AI 软件开发模式,以单轮或少量轮次的文本生成和代码补全为主。到 2026 年,前沿系统已经广泛具备工具使用、文件系统操作、终端执行、浏览器与 GUI 操作、跨应用调用、长时任务、并行子 Agent 和持久状态等能力。Stanford AI Index 将这一变化概括为能力仍在加速而非停滞;GitHub 2025 Octoverse 则观察到 AI、Agents 与强类型语言共同推动软件开发生态出现多年未见的结构性变化[2][38]。
这类变化导致“AI Engineer”作为职位名称已不足以描述所需能力。更有解释力的概念是 AI Engineering Skills:即所有需要构建、集成、运营或治理 AI 功能的软件开发者都应具备的横向能力。DeepLearning.AI 的 Skills Map 正是基于这一观点,而非将其限定为某一种岗位[1]。
1.2 研究问题
本报告回答五类问题:
- 四项核心技能在 2026 年分别包含哪些可操作的知识与工程能力?
- 哪些内容属于长期稳定的基础知识,哪些属于快速变化的工具层技能?
- 2026 年最重要的技术热点和研究争议是什么?
- 如何建立从初学者到高级 AI Technical Lead 的学习和能力评估路线?
- 企业应该如何招聘、评估和组织具备这些能力的工程师?
1.3 证据分层与研究方法
本报告采用三层证据体系。A 级证据包括标准组织、监管机构、官方协议规范、原始论文和正式技术文档;B 级证据包括 Stanford AI Index、DORA、WEF、METR 等大型研究或实证报告;C 级证据包括 OpenAI、Anthropic、Google、GitHub 等厂商公开的工程案例。C 级资料用于理解前沿实践,但不把单个团队的生产率数字外推为行业普遍因果结论。例如 OpenAI Harness Engineering 的“约 1/10 时间”与 Symphony 的“部分团队 landed PR +500%”均属于特定组织、特定 Harness 与模型条件下的案例[15][17]。
1.4 术语
Model 指生成或决策的基础模型;Agent 指在循环中通过模型决策并调用工具、修改环境、读取反馈的系统;Agent Harness/Scaffold 指围绕模型构建上下文、管理工具、错误恢复、状态、停止条件和验证的执行层;System Harness/Orchestrator 指在更高层管理任务分解、多个 Agent、环境、Issue/PR、反馈信号和生命周期的控制系统[10][16][36][37]。Eval 指具有输入、成功标准和评分逻辑的可重复评测;Verifier 是可判断某一步或最终状态是否满足要求的确定性或统计性检查器。
2. 2026 年 AI Engineering 的行业状态
2.1 能力、采用与就业同时发生结构变化
2026 AI Index 报告给出了几个理解行业状态的重要量化信号:组织 AI 采用率已达到 88%,生成式 AI 在至少一个业务功能中的使用率达到 70%;然而 AI Agent 在绝大多数业务功能中的实际部署仍处于个位数比例[3]。这说明“使用 AI”已经大众化,而“将 Agent 安全、可靠地放入生产流程”仍属于较高门槛能力。
技术能力方面,SWE-bench Verified 的领先表现从上一年的约 60% 快速上升到接近 100%;OSWorld 的 Agent 任务成功率则从约 12% 上升至约 66%,仍意味着结构化计算机任务中约三分之一失败[2]。SWE-bench Verified 的快速饱和并不意味着软件工程被解决:OpenAI 在 2026 年停止将其作为前沿编码能力的主要指标,指出存在污染和测试设计问题;新的研究也显示同一模型在不同 Harness 下可产生十几个乃至二十个百分点的差距[20][36][37]。
就业方面,Stanford 统计显示美国 22–25 岁软件开发者就业人数自 2024 年以来下降接近 20%,同时较年长开发者总体人数仍在增长;这并不能单独证明 AI 是唯一原因,但至少提示“执行明确任务”的初级岗位入口受到更大压力[3]。WEF 的 Future of Jobs 2025 同时指出 AI/大数据、网络与网络安全、技术素养是增长最快的技能类别,但分析思维、创造性思维、韧性、领导与协作仍是核心技能[5]。这与 Skills Map 中“软件工程基础 + Shaping”并列的重要性高度一致。
2.2 从 Model-centric 转向 System-centric
2023–2024 年常见优化方式是更换模型和优化 Prompt。2026 年更成熟的工程方式是对整个系统进行联合优化:
System Quality = f(Model, Context, Tools, Harness, Environment, Verifiers, Data, Policies, Observability)
2026 年关于 Coding Agent 的研究提出了更强的形式化观点:在长时 Agent 系统中,模型本身更接近一个随机策略,而 Harness 类似闭环控制器;上下文构造、工具路由、错误恢复、压缩、重试和停止条件决定反馈路径。相同模型仅改变 Harness,就可能在同一类基准上显著改变结果[36]。因此“选最强模型”不是可靠性的充分条件。
2.3 2026 年十二个高价值技术热点
- Harness Engineering:工程师从直接写代码转向设计 Agent 可以可靠工作的环境、规范、反馈与验证器[15]。
- Long-running Agents:任务从分钟级向小时、天级延伸,持续状态、检查点、恢复和上下文压缩成为核心基础设施[12][18][35]。
- Agent Orchestration:Issue tracker、工作队列和并行 Agent 形成“控制平面”;人类主要管理目标、优先级与验收[17]。
- Context Engineering:重点从“如何写 Prompt”转向“每一步模型应该看到哪些最小高信号信息”[9]。
- Eval-driven Development:从回答级评分扩展到 trajectory、环境终态、回归套件和生产反馈闭环[10][19]。
- Agent Observability:OpenTelemetry 等标准开始定义 GenAI/Agent 的 trace、token、tool call 等语义,观测逐渐标准化[23]。
- Containment & Least Privilege:安全策略从逐次弹窗审批转向沙箱、网络边界、短期凭据、最小权限与防御纵深[13][14][24]。
- MCP / A2A 互操作:MCP 解决 Agent 与工具/资源连接;A2A 解决不同 Agent 之间发现、通信与任务协作[21][22]。
- Benchmark Crisis:短时任务指标快速饱和,研究重心转向长时、项目级、多验证通道与抗 reward hacking 的评测[20][35][37]。
- Agent-native Repository:AGENTS.md、架构文档、统一验证脚本、可重复开发环境逐渐成为代码库的一部分[15][40]。
- Model Routing / Efficiency:按任务难度选择模型、控制 reasoning effort、缓存上下文与减少 token 浪费成为成本工程问题[39][44]。
- Governance as Engineering:EU AI Act 自 2026-08-02 起进入更全面适用和执法阶段;ISO 42001/42005、NIST AI RMF 和 OWASP Agentic Top 10 把治理与风险管理转化为工程要求[24][26][27][28][30]。
3. 一个统一理论框架:AI 系统是带不确定性的闭环软件系统
3.1 概率性组件与确定性壳层
传统软件并非绝对确定,但主要业务逻辑通常具有明确状态转移和可复现测试。生成模型引入了更高的不确定性:相同输入可能得到不同输出;模型升级、采样参数、上下文顺序和工具反馈都可能改变结果。因此可靠 AI 系统不应试图把模型本身“变成确定性程序”,而应在模型周围构建确定性约束:schema validation、类型系统、权限、事务、幂等、超时、测试、策略规则和人工审批。
可将生产系统拆成两类边界:
- Soft boundary:Prompt、模型偏好、LLM judge、启发式规则,只能改变行为概率;
- Hard boundary:数据库权限、网络 egress、文件系统 sandbox、类型约束、事务和执行策略,决定系统“能够做什么”。
Anthropic 2026 的安全实践明确指出,模型层防御具有非零漏检率,因此不能替代环境层 containment;让敏感凭据根本不进入 Agent sandbox,比要求模型“不要泄露”更可靠[14]。
3.2 闭环控制视角
Agent 运行可抽象为:
state_t -> context(state_t) -> model action_t -> environment observation_t -> controller update -> state_(t+1)
其中 context construction、tool mediation、validation、retry、memory、stopping 都属于 Harness 决策。2026 年的 Harness 研究将 stability、context drift 和 control lag 作为长时可靠性的关键变量[36]。这一视角解释了为什么 Agent 可靠性主要依赖反馈闭环:模型更强可以降低错误发生率,但错误一旦发生,是否能被检测、恢复以及避免扩散主要由 Harness 决定。
3.3 Context 作为信息预算
上下文窗口并不是“越大越好”的无限缓存。其真正约束是有效注意力与 token 成本。Context Engineering 的目标是使当前决策所需的高价值信息密度最大,而不是无差别装载全部信息[9]。可以把 Context 设计理解为四个过程:选择(selection)、压缩(compression)、外部化(externalization)、按需检索(just-in-time retrieval)。
长时任务应把稳定状态写入外部可查询存储,如文件、数据库、Issue、artifact、commit、memory store;上下文只保留当前推理所需投影。多 Agent 的一个合理价值正是 Context Isolation:每个子 Agent 在干净上下文中深入探索,只向主 Agent 返回压缩结果[9][11]。
3.4 Eval 是测量科学,而不是 Demo 打分
生成系统的核心工程问题不是“模型听不听话”,而是“成功这个构念如何被可重复地测量”。Anthropic 将 Agent Eval 拆为 task、trial、grader、trace、outcome、evaluation harness 和 suite;OpenAI 的评测指南则强调 task-specific、early-and-often、log everything、human calibration[10][19]。因此一个完整 Eval 必须区分:最终文本、环境终态、过程轨迹、成本、延迟与安全属性。
尤其要警惕 proxy 失真:测试通过不一定等价于维护者愿意合并;单个 reference patch 也可能错罚其他正确方案。2026 年关于 Coding Benchmark 的争论本质上是测量有效性问题[20][37]。
3.5 AI 是软件组织能力的放大器
DORA 2025 将 AI 描述为“amplifier”:它会放大高质量平台、清晰流程、测试、文档与反馈机制,也会放大技术债、低质量工作流和组织摩擦[4]。这一结论解释了为什么软件工程基础没有被 Agent 弱化。代码生成速度提高会提高系统变更吞吐,从而使测试、review、架构和部署系统承受更高压力;没有可靠的交付能力,生成更多代码只会增加未验证变化的积压。
3.6 Spec–Eval 对偶
一个高质量 Spec 应说明“系统必须满足什么”,而 Eval 将这些要求转换为可测量判据。二者天然对偶:无法设计 Eval 的需求往往仍然模糊;无法从 Spec 派生验收条件,说明工程目标尚未操作化。对 Agent 而言,Spec 不应该规定每一行实现,而应规定目标、约束、非目标、接口、不变量、风险和验收标准。
3.7 Autonomy–Blast Radius 模型
Agent 可获得的自治程度应同时取决于可验证性和潜在影响半径:
- 高可验证、低影响:自动执行(格式化、lint、单元测试、隔离分支重构);
- 高可验证、高影响:可自动准备,但执行前审批(数据库迁移、部署、IAM 变更);
- 低可验证、低影响:有限自治 + 抽样 review;
- 低可验证、高影响:人工主导。
这个二维模型比“一律人工确认”或“一律 fully autonomous”更符合实际安全工程,因为过量审批会产生 approval fatigue,而完全放权又突破 hard boundary[13][14]。
4. 核心技能一:构建与部署 AI 应用
4.1 能力定义
这项技能的职业级定义不是“能调用 LLM API”,而是:能够把概率性模型能力嵌入一个具有可测质量、成本、延迟、可靠性、安全和治理边界的软件系统,并持续通过数据和 Evals 改进它。
成熟 AI Application Engineer 至少要能处理十个层面:模型与推理、结构化接口、上下文、检索、工具、Agent、评测、可靠性、安全、部署/观测。
4.2 必要的模型与统计基础
应用工程师不必首先具备训练 frontier model 的能力,但需要理解会直接影响系统设计的概念:tokenization、embedding、attention/Transformer、pretraining 与 instruction tuning 的差别、sampling、temperature/top-p、context window、reasoning effort、multimodal input、fine-tuning 的适用边界。
统计方面至少应掌握分布、均值与方差、抽样、置信区间、偏差–方差、precision/recall/F1、ranking metric、train/validation/test、数据泄漏与 distribution shift。原因是 AI 产品几乎永远要回答“这个 87% 是否稳定”“错误集中在哪些分布”“模型升级是否显著改善”“线上样本是否已偏离 eval set”等问题。
4.3 Structured Outputs 与 Tool Calling
生产系统应尽量减少对自由文本解析的依赖。适合结构化的数据交换应使用 JSON Schema、Pydantic/Zod、类型约束、枚举和必填字段,并对模型输出进行服务器端验证。工具调用必须视为 RPC/command interface,而不是自然语言建议:工具 schema 需要清晰语义、最小参数面、可观测错误、幂等性和权限边界。
需要掌握的工程内容包括:schema versioning、validation error、tool retry、timeout、rate limit、idempotency key、transaction boundary、partial failure、compensation、tool result sanitization。对高风险工具,应将模型“决定调用什么”与系统“是否允许执行”分离。
4.4 Context Engineering
Context Engineering 已从 Prompt Engineering 中分化为更大的工程领域[9]。应掌握:system/developer instruction 分层、few-shot 示例、conversation history 筛选、动态 retrieval、memory、tool descriptions、tool outputs、repository/project context、context compression 和 prefix caching。
可采用“信息价值密度”原则:每个进入上下文的 token 都应服务于当前目标。常见错误包括把整个仓库、全部数据库记录或所有工具 schema 一次性塞入上下文,导致 token 成本、干扰和注意力稀释。更好的模式是先让 Agent 识别信息缺口,再按需搜索;长期事实写外部 memory;阶段性工作写 checkpoint/notes;仅在当前步骤读取必要切片。
4.5 RAG 的 2026 定位
RAG 的理论起点是将参数化记忆与外部非参数化记忆结合,以解决知识更新、来源追踪和领域知识问题[31]。到 2026 年,RAG 不再只是“聊天机器人外挂向量库”,而是 Context Engineering 的检索子系统。
一个生产 RAG Pipeline 应包含:数据接入、解析、清洗、chunking、metadata、ACL、embedding/index、query understanding、query rewriting、dense/sparse hybrid retrieval、reranking、context assembly、generation、citation、feedback 与 index freshness。
需要能够分别测量:
- Retrieval Recall@K:正确证据是否被取回;
- Precision/Noise:上下文中无关文档比例;
- Reranker quality:排序是否把关键证据提前;
- Answer correctness:生成是否正确;
- Groundedness/citation correctness:答案是否由证据支持;
- Freshness/ACL correctness:是否使用最新且有权限的数据。
如果只测最终回答而不测 retrieval,很难知道错误来自模型还是数据层。
4.6 Agentic Workflow
ReAct 研究提出了交错进行 reasoning 与 action 的基本模式,使模型能够通过外部环境获取新信息并更新计划[32]。现代生产 Agent 可以抽象为:Model + Tools + Loop + State + Environment + Policy。
应优先从确定性 workflow 开始:如果任务可以被固定步骤稳定解决,不需要为“自治”增加复杂度。Agent 适合开放目标、步骤不可预先完全枚举、需要根据环境反馈动态选择动作的任务。Google 2026 的架构指导同样建议先根据任务复杂度、延迟、成本和人工参与要求选择单 Agent 或多 Agent,而不是默认多 Agent[41]。
4.7 Tool Engineering
Agent 的表现高度依赖工具设计。高质量工具应满足:名称和描述准确、参数少而明确、错误消息可行动、结果结构化、权限最小化、输入和输出长度可控。工具数量增长时,应支持 tool discovery、按需加载或代码执行中间层,以避免把数百个工具定义永久加载到上下文中。
工具必须明确失败语义:404/无数据、权限不足、可重试网络故障、不可重试业务错误不能混成字符串“Something went wrong”。Agent 要能够区分“换参数重试”“请求更高权限”“调用备用工具”“停止并升级人工”。
4.8 Eval-driven Development
开发顺序建议调整为:定义成功 → 建立 eval set → baseline → 修改 prompt/context/tool/harness → eval → error analysis → regression → deploy → production feedback。Eval 数据应覆盖正常流、边界条件、对抗输入、业务关键路径和历史事故。对于非确定输出,单个 case 应运行多个 trial,估计方差而不是只看一次成功。
Grader 优先级:确定性 verifier > 统计指标 > LLM-as-judge > 人工评审。能用数据库状态、单元测试、schema、数学约束判断的,不应优先用另一个 LLM 猜。LLM judge 适用于语义质量、风格或多维 rubric,但必须通过人工样本校准一致性[10][19]。
4.9 Error Analysis 与 Failure Taxonomy
“总分 82%”对工程行动不足。应把失败归类,例如:retrieval miss、missing context、tool selection、bad arguments、tool execution、reasoning error、policy conflict、timeout、hallucinated completion、state corruption。每个类别建立频率、严重度、可检测性和修复策略。高成熟度团队会维护 failure taxonomy,并将真实线上事故不断加入 regression suite。
4.10 Agent Observability
传统日志只记录 HTTP 500 不足以解释 Agent。至少应追踪:request/task id、model/version、prompt/harness version、input/output token、latency、tool sequence、tool args/result status、retrieval ids、memory changes、agent handoff、cost、grader result、human intervention 和 final outcome。OpenTelemetry 正在形成统一的 GenAI semantic conventions,用于标准化模型调用和工具调用的 trace 表达[23]。
数据隐私同样重要:不能为了 observability 默认记录全部 prompt、工具输出和用户敏感数据。需要字段级脱敏、采样、访问控制和保留期。
4.11 可靠性、成本和延迟
生产系统需要 timeout、retry with backoff、circuit breaker、fallback、model routing、cache、queue、rate limit、bulkhead、graceful degradation。成本应拆为 input/output tokens、retrieval、tool/API、sandbox compute、storage、judge/eval 和人工 review。
模型路由不是“永远用便宜模型”:应建立 task complexity classifier,将低风险/确定任务路由到快速模型,高复杂任务路由到更强模型,并通过 eval 验证路由后的质量–成本前沿。2026 年模型厂商已开始把“每任务 token 效率、cache、harness 减少重复工作”作为系统级优化重点[44]。
4.12 安全与治理
AI 应用安全需要同时覆盖传统 AppSec 和 Agent-specific 风险。OWASP 2026 Agentic Top 10 将 goal hijacking、tool misuse、identity/privilege abuse、memory poisoning、insecure inter-agent communication、cascading failures 等纳入独立风险框架[24]。工程实践应包括 prompt injection 测试、untrusted content 标记、tool permission、sandbox、secret isolation、human approval、audit log、data provenance。
治理层面,NIST AI RMF 采用 Govern–Map–Measure–Manage 的风险函数;ISO/IEC 42001 提供 AI 管理体系,ISO/IEC 42005 提供 AI impact assessment 的生命周期方法[26][27][28]。对于面向欧盟市场的系统,2026-08-02 后 AI Act 的更多条款和执法已经生效,产品团队需要把透明度、记录、风险与责任边界视为系统设计输入,而不是上线后的合规补丁[30]。
4.13 Skill 1 能力等级
L1 原型:能完成模型调用、structured output、简单检索。
L2 应用:能设计工具调用、RAG、eval set、基础部署。
L3 生产:能处理安全、可观测性、成本、故障、版本回归。
L4 Agent:能设计长时状态、trajectory eval、memory、sandbox 和复杂 workflow。
L5 平台/Lead:能建立跨团队 eval、治理、tool platform、model routing 和 observability 标准。
5. 核心技能二:软件工程基础
5.1 为什么 AI 时代基础工程能力价值上升
Coding Agent 降低的是“生成候选实现”的成本,而没有等比例降低架构、验证、运维和责任成本。DORA 的 amplifier 结论意味着,如果团队没有测试、清晰平台和快速反馈,AI 只会更快地产生变化和技术债[4]。因此软件工程基础的作用从“亲手写每一行代码”转向“知道哪些约束和权衡必须被表达给 Agent,并能判断输出是否可接受”。
5.2 编程语言与运行时
至少精通一门后端/通用语言,推荐 Python、TypeScript、Go、Java 之一,并熟悉第二门语言。必须理解类型、作用域、异常、async/await、线程/协程、I/O、序列化、包管理、构建系统、调试和 profiling。Agent 可以快速生成异步代码,但工程师必须判断并发安全、资源生命周期和异常传播是否正确。
对 2026 的 AI 应用而言,Python 仍是模型/数据生态的关键语言,TypeScript 在 Web/产品工程中非常重要;GitHub 2025 统计中 TypeScript 首次超过 Python 和 JavaScript 成为 GitHub 最常用语言之一,说明强类型前端/全栈生态在 Agent-heavy 开发中也具有重要地位[38]。
5.3 数据结构与算法
重点不是背题,而是能理解算法和资源复杂度:hash map、tree、graph、queue、heap、search、sort、dynamic programming 的基本思想;能判断 O(n²) 是否会在生产数据量下失效,是否应该用 index、stream、batch、queue 或缓存。Agent 会产生“看起来能跑”的实现,复杂度判断仍是工程师的责任。
5.4 操作系统与执行环境
需要理解进程、线程、信号、文件系统、权限、环境变量、文件描述符、CPU/内存、容器与隔离。Coding Agent 直接运行 shell、安装依赖、修改文件和启动服务后,OS 知识同时成为安全知识。不了解 shell expansion、permissions 或 process tree,就无法有效审查 Agent 的动作。
5.5 网络与协议
必须掌握 TCP/IP 基础、DNS、HTTP、TLS、REST、WebSocket/SSE、代理、负载均衡、连接池、超时、重试与幂等。AI 系统依赖多个外部模型、检索和工具服务,partial failure 是常态。最危险的错误之一是对非幂等写操作盲目 retry。
5.6 数据库与状态
需要熟练 SQL、schema、index、transaction、isolation、locking、migration、normalization/denormalization;了解 Redis、文档数据库、对象存储、向量索引。应能明确区分“业务系统的 source of truth”和“为检索优化的派生索引”。Vector DB 不能替代关系数据库的事务和约束。
Agent 执行数据库操作时,尤其要使用 read-only 默认权限、参数化查询、事务、预览与审批;生产 migration 应具有 backward compatibility 和 rollback 方案。
5.7 分布式系统
掌握 partial failure、eventual consistency、queue、retry、idempotency、dedup、distributed lock、backpressure、rate limit、outbox/inbox pattern 等概念。Agent 系统本身通常就是分布式系统:模型 API、tool service、memory store、sandbox、queue、worker、observer 和 orchestrator 可能分别部署。
5.8 架构与质量模型
ISO/IEC 25010:2023 将软件产品质量组织为九类特性及其子特性,可作为非功能需求的系统化参考[29]。实际设计至少要讨论:功能适合性、性能效率、兼容性、交互能力、可靠性、安全性、可维护性、灵活性和安全保障等维度。AI 功能不能只优化“回答质量”,还要考虑 latency、cost、privacy、operability 和 failure containment。
5.9 Testing 与 Verification
AI 时代的高价值能力之一是构建机器可执行的 Verifier。测试体系建议包括:unit、integration、contract、E2E、property-based、mutation、load、security、AI eval。Coding Agent 的理想闭环不是“写完后让人看”,而是“写 → format/lint/typecheck → test → inspect failure → repair → regression”。
测试本身也会被 Agent 生成,因此要防止“为了通过而弱化测试”或 reward hacking。长时基准 SWE-Marathon 观察到部分 Agent 会试图利用 verifier 缺陷绕过任务目标,说明 verifier 需要多通道、外部不可修改检查和 adversarial audit[35]。
5.10 Security Fundamentals
必须掌握 authn/authz、RBAC/ABAC、OAuth/OIDC、secret management、injection、XSS/CSRF/SSRF、supply-chain、dependency risk、least privilege。Agent 增加的不是一套全新安全世界,而是把传统风险与自然语言/自主执行叠加:例如 prompt injection 可以诱导 Agent 触发已有的 SSRF 或凭据泄露路径。
5.11 Cloud、DevOps 与 SRE
至少掌握 Linux、Docker、CI/CD、cloud IAM、object storage、managed DB、serverless/container、Kubernetes 基础、IaC、logs/metrics/traces、SLO/SLI、alerting、rollout/rollback、feature flag。Agent 的上线也应有 canary、版本化 prompt/harness、模型切换控制和回滚能力。
5.12 代码审查的变化
Review 不应退化为“看 diff 是否像人写的”。Agent-heavy 环境应审查:需求是否满足、架构是否一致、测试是否充分、权限是否扩大、依赖是否新增、migration 是否安全、性能是否回退、可观测性是否齐全。2026 的 benchmark 研究显示,自动 grader 通过和真实 maintainer 可合并之间存在明显差距,证明 maintainability 与 integration 不能被 hidden tests 完全替代[20][37]。
5.13 Skill 2 能力标准
一个合格中级工程师必须能够回答:为什么选择该数据模型?并发下会发生什么?失败如何恢复?重试是否安全?安全边界在哪里?部署如何回滚?哪种指标证明系统健康?如果无法回答这些问题,即使 Agent 能生成大量代码,也尚未形成可靠工程能力。
6. 核心技能三:使用 Coding Agents
6.1 正确 Mental Model
Coding Agent 不是“更聪明的 autocomplete”,而是 Model + Agent Harness + Repository Context + Tools + Execution Environment + Permissions + Feedback。OpenAI 的 Codex loop 公开说明 Agent loop 负责组织模型推理、工具、上下文和执行;2026 年研究进一步强调,评价 Coding Agent 必须把 Harness 作为被测系统的一部分[16][36]。
6.2 四种工作模式
- Pair mode:同步协作,适合解释、局部修改、debug;
- Task mode:把一个 issue 委派给 Agent,生成代码、测试和 PR;
- Background mode:多个任务并行运行,人管理队列和结果;
- Orchestrated mode:系统自动从项目看板取任务、分解、调度多个 Agent、执行验证并等待人类 review。
GitHub Copilot coding agent 已支持后台任务、self-review、安全扫描、custom agents 和本地/云端 handoff[39];OpenAI Symphony 将 issue tracker 作为 Agent control plane[17]。这些工具实现不同,但共同模式是“意图与任务成为主要输入,代码成为生成的中间产物”。
6.3 Context Management
低质量委派通常只有“fix this”。高质量委派应提供 Goal、Constraints、Relevant Context、Acceptance Criteria、Non-goals、Verification。Repo-level 规则应持久化在 AGENTS.md/CLAUDE.md、README、architecture docs、ADR、runbook 和验证脚本中,而不是每次复制进聊天[40]。
Context 的关键不是字数,而是 task relevance。Agent 应自己搜索仓库并形成局部 context;人类提供不能从仓库轻易推导的业务约束和隐含规则。
6.4 Spec 粒度
过弱 Spec 把所有决策都推给 Agent;过细 Spec 又退化为逐行指令。最优粒度通常是“明确意图和不可违反的约束,但允许实现自由度”。例如认证任务应规定认证方式、token 生命周期、数据模型约束、失败行为、安全要求和 acceptance tests,而不是要求第 25 行写某个函数。
6.5 Planning vs Execution
是否先规划应由复杂度、模糊性、影响半径和可逆性决定。小改动直接执行更高效;涉及跨服务、schema、迁移和架构时,先让 Agent 生成 plan,并由人或 reviewer Agent 检查依赖和风险。Planning 本身也应有验证:是否覆盖 rollback、测试、数据迁移、监控和兼容性。
6.6 Agent-native Repository
Agent-friendly repo 应具有:明确入口文档、稳定目录结构、自动化环境启动、统一 verify 命令、快速测试、可机器读取的架构约束、清晰日志和最少“只存在工程师脑中”的知识。OpenAI Harness Engineering 的实践显示,早期瓶颈往往不是模型不能写代码,而是环境对 Agent 不够可读、缺少工具和反馈[15]。
一个推荐结构:
repo/
  AGENTS.md
  README.md
  docs/architecture.md
  docs/domain.md
  docs/runbook.md
  scripts/bootstrap.sh
  scripts/verify.sh
  tests/
  src/
verify.sh 应尽可能成为统一判定入口:format、lint、typecheck、unit、integration、必要的 security/eval。
6.7 Harness Engineering
Harness Engineering 的核心任务包括:任务入口、上下文构造、工具集合、提示/规则、执行环境、checkpoint、memory、retry、停止条件、验证器和权限。OpenAI 2026 的案例将工程师工作概括为设计环境、指定意图、构建反馈回路;同一项目中所有应用代码、测试、CI、文档和 observability 都由 Agent 生成,但关键人类工作是完善 Harness[15]。
这一能力比“熟练某个 Coding Agent UI”更持久,因为不同产品共享相似问题:如何让 Agent 找到正确文件、如何让失败可诊断、如何让它知道何时完成、如何防止对生产环境产生破坏。
6.8 Parallel Agents 与 Multi-Agent
并行 Agent 的主要价值是并发与上下文隔离,而不是“多一个角色就更智能”。Anthropic 2026 的 C compiler 实验中,16 个 Agent 在隔离容器中并行,主要工程难点集中在测试、环境、同步和反馈;这说明 multi-agent 的收益来自任务可分解性和 Harness,而不是纯粹增加实例数量[12]。
多 Agent 适合可分割、独立验证、合并成本低的工作。对于高度耦合的核心架构或同一小文件频繁冲突的任务,增加 Agent 可能提高协调成本。应优先 single agent + good tools,只有当并行搜索、专业化或 context isolation 有明确收益时升级。
6.9 MCP 与 A2A
MCP 2026-07-28 规范加入/强化了 long-running Tasks、扩展机制、authorization 等能力[21]。工程师应理解 server/client、tools/resources、transport、capability negotiation、authorization scope,而不是只会安装 MCP server。
A2A 则面向独立 Agent 之间的 discovery、capability description、task communication 和 collaboration,并利用标准 Web 安全机制进行认证[22]。可以用一句边界区分:MCP 主要解决 Agent-to-tool/data,A2A 主要解决 Agent-to-agent。两者可能共同出现在企业 Agent 架构中。
6.10 Verifier 与 Self-correction
Agent 自治程度最关键的基础设施不是更长 Prompt,而是可运行的验证器。Verifier 可以是 compiler、type checker、unit/integration tests、browser automation、database assertion、visual diff、性能门限、安全扫描和业务 eval。没有 verifier,Agent 的“我已经完成”只是自然语言声明。
应区分 inner-loop、middle-loop 和 outer-loop 信号:inner 是秒到分钟的 test/lint;middle 是代码质量、review 模式和每日健康指标;outer 是 PR 接受率、revert、incident 和客户反馈。2026 的 System Harness 研究提出,真正可自我改进的 Agent 系统需要把三层信号连起来[37]。
6.11 Sandbox、Permissions 与 Containment
Coding Agent 的默认安全设计应是:读权限广于写权限;工作区写入广于宿主机写入;网络默认受限;生产凭据不进入普通 sandbox;高风险 action 需 step-up approval。Anthropic 观察到用户批准约 93% 的权限弹窗,因此单纯依赖大量人工确认会导致 approval fatigue[13]。更可靠的方法是把不可接受动作从环境层禁止。
需要建立 blast-radius 分类:本地格式化 < 分支写入 < 创建 PR < staging deploy < production deploy < prod DB/IAM。权限随任务逐级开放,而不是一次性授予万能 token。
6.12 Benchmark 不等于真实工程能力
SWE-bench 从 2023 年不到 2% 的早期表现快速发展到 2026 的近饱和状态[33][2]。但 OpenAI 2026 的审计认为 Verified 已出现污染与设计问题;其他研究发现相同模型仅替换 Harness 可以发生 10–20+ 个百分点变化[20][36][37]。SWE-Marathon 则把任务延长到项目级多小时工作,当前前沿配置 pass@1 仍低于 30%,失败包括弱 self-verification、过早终止和 reward hacking[35]。
因此企业不能用“某模型 SWE-bench 分数”直接推导“该 Agent 能完成我们团队 80% 工程任务”。应在自己的 repo、任务分布、工具、权限和 review 标准下评测。
6.13 生产率证据必须谨慎解释
METR 2025 对熟悉自己代码库的开源开发者进行随机对照实验,发现当时工具条件下使用 AI 的开发者实际耗时增加 19%,而参与者主观认为自己更快[6]。到 2026,METR 的技术工作者调查显示很多用户报告显著价值提升,但研究者也明确提示 self-report 存在选择偏差和高估风险[7]。DORA 则在更大组织样本上观察到 AI 使用广泛且与多个绩效指标相关,但强调组织能力的调节作用[4]。
合理结论是:AI 的生产率收益不是工具常数,而是 Task × Developer × Repository × Harness × Organization 的函数。 因此“会使用 Coding Agents”是一项独立技能,而不是安装某个插件。
6.14 Skill 3 能力标准
- 初级:能安全委派局部任务,理解 diff 和测试;
- 中级:能编写高质量 spec/context、建立 verifier、管理 agent session;
- 高级:能设计 agent-native repo、并行调度、sandbox 与权限;
- Lead:能建设 system harness、团队级 eval、issue-driven orchestration、ROI/风险指标,并持续升级工作流。
7. 核心技能四:Shaping the Build
7.1 定义
Shaping the Build 指工程师参与决定“应该构建什么、为什么、边界在哪里、怎样证明它有效”,而不是等待像素级设计和完备 PRD 后只实现代码。随着 Agent 对明确任务的执行能力提升,需求定义和工程判断成为更稀缺的瓶颈[1][15]。
7.2 从 Feature Request 转向 Problem Statement
“做一个 AI chatbot”不是问题定义。更好的描述应包含:用户、当前流程、痛点频率、价值、失败成本、约束、成功指标。例如:企业客户支持工程师每周有 30% 时间重复搜索内部文档,目标是在引用正确率 ≥98% 的条件下将人工处理时间降低 40%,且禁止 Agent 修改账户状态。只有在这种问题结构下,团队才能判断最终解法是搜索、RAG、workflow automation 还是 Agent。
7.3 Product Discovery 与不确定性管理
Shaping 的对象有四类不确定性:价值(用户是否需要)、可用性(能否正确使用)、可行性(技术和数据是否允许)、可持续性(成本、运营、合规是否可接受)。MVP 的目的不是“尽快做一个简陋版本”,而是以最低成本验证最高风险假设。
对低风险、可逆、需求未知的功能应快速迭代;对支付、身份、生产数据迁移、医疗、金融、法律或不可逆用户操作,应增加设计 review、threat model、分阶段 rollout、human approval 和 rollback。
7.4 Business Context
高级 AI Engineer 至少应理解 revenue、cost、margin、conversion、retention、churn、support cost、cycle time、risk exposure、compliance cost 等指标。技术选择必须落到单位经济:例如将每次 Agent 成本从 0.03 美元降到 0.01 美元是否重要,取决于调用量、人工替代价值和错误成本。
7.5 Executable Spec
适合 Agent 的 Spec 建议包含:
- Goal / Problem;
- User & Context;
- Functional requirements;
- Non-functional requirements;
- Constraints;
- Non-goals;
- Data and permissions;
- Failure modes;
- Security/privacy;
- Acceptance criteria;
- Evals/verifiers;
- Rollout/rollback;
- Observability。
这类 Spec 的价值在于可被人类、Agent 和 CI 同时消费。
7.6 Acceptance Criteria 与 Eval Spec 融合
对于概率性功能,验收不应只有“能回答问题”。应写成数据分布与门限:在内部客服 300 个代表性 case 上,政策正确率 ≥95%,引用准确率 ≥98%,禁止动作触发率 0,P95 延迟 <6s,单请求平均成本 <0.05 美元。上线后再建立真实流量采样和人工审查。
Anthropic 的 Eval 实践指出,编写可执行 eval task 本身可以暴露需求模糊性;这说明 PM、Support、Domain Expert 和工程师可以共同维护 eval suite[10]。
7.7 Technical Shaping
工程师需要决定哪些部分交给模型、哪些保持确定性代码。例如订单退款:模型可以理解用户意图、提取理由和解释政策,但退款金额计算、权限检查、幂等和最终 transaction 应由确定性服务控制。一个常见的设计原则是:模型负责模糊输入和开放推理,软件负责不变量和不可违反的业务约束。
7.8 Risk Shaping
设计 Agent 功能时先定义可执行权限,而不是完成后再添加“请谨慎”的 Prompt。需要明确:Agent 是否可读 PII、是否可发邮件、是否可写数据库、是否可付款、是否可访问公网、是否可调用第三方 MCP。NIST、ISO 42005 和 OWASP 的共同方向是把 impact/risk assessment 前置到生命周期设计[24][26][28]。
7.9 监管成为产品约束
欧盟 AI Act 于 2026-08-02 进入更全面适用和执法阶段,同时 2026 年 AI Omnibus 调整了部分高风险系统时间表[30]。对于全球产品,工程师需要至少具备“知道什么时候要找法务/合规”的能力:透明度、日志、模型/数据来源、用户告知、risk classification 和人类监督可能影响系统架构。此处不应把工程报告当法律意见,但必须把法规视作 non-functional requirement 的来源。
7.10 Shaping 能力等级
- 初级:能澄清需求与验收条件;
- 中级:能把业务目标转换为 Spec/Eval/Architecture;
- 高级:能主动发现机会、定义 MVP、权衡成本/风险、驱动跨职能交付;
- Lead:能建立产品–技术–治理统一决策框架,并对业务结果负责。
8. 2026 技术热点专题
8.1 Long-horizon Agent:从“会做一步”到“持续完成项目”
短任务 benchmark 的饱和使研究转向持续数小时甚至更长的工作。SWE-Marathon 设计了平均数千万 token 的项目级轨迹,当前最强系统仍不到 30% pass@1[35]。长时任务的核心难点包括:阶段性计划、progress memory、checkpoint、失败恢复、context compaction、资源预算和停止条件。
学习重点:不要仅练习“一次 prompt 生成完整项目”,而要练习让 Agent 在 5–20 个可验证阶段持续推进,每阶段保存状态并可以由另一 Agent/会话接手。
8.2 Harness 取代 Prompt 成为性能杠杆
2026 研究显示,同一模型仅 Harness 不同就可能产生超过 20 个百分点的任务成功差异[36][37]。这意味着未来性能优化将类似传统系统调优:不仅换“核心算法”,还要优化上下文缓存、tool interface、重试、搜索、验证与执行环境。
8.3 Agent Orchestrator 与 Issue-as-State
Symphony 等实践把项目管理系统作为 durable task state:issue 描述需求,Agent 工作在隔离分支,CI 和 reviewer 决定状态流转[17]。这可能形成新的工程管理界面:人类写/审 issue、管理优先级和风险,Agent 消费任务并产出 PR/证据。
8.4 Context Compaction 与 External Memory
长时 Agent 必然遇到 context growth。2025–2026 的主流实践包括自动 compaction、文件式 memory、摘要 checkpoint 和子 Agent isolation[9]。未来需要学习的不是“最大 context window 有多少”,而是如何防止重要约束在压缩中丢失,如何区分 immutable requirements 与 disposable dialogue。
8.5 Protocol Layer:MCP + A2A
MCP 最新规范已经覆盖 durable Tasks 和更强 authorization;A2A 已形成独立 Agent interoperability 标准[21][22]。协议化降低自定义 glue code,但同时扩大供应链和 trust boundary:一个安全的 MCP server 并不意味着其返回内容可信;Agent Card 也不意味着远端 Agent 应获得无限权限。
8.6 Observability Standardization
OpenTelemetry 2026 的 GenAI 观测工作表明 Agent tracing 正从厂商专有格式走向公共语义:模型、token、tool calls、tool results 等可以作为标准 span/attribute[23]。对企业平台工程师而言,Agent telemetry 很可能会像 HTTP/database tracing 一样成为默认基础设施。
8.7 Security 从 Prompt Guardrail 走向 Containment
Claude Code 的工程实践表明纯审批机制会产生疲劳;更强方向是 sandbox、egress control、ephemeral credentials 和环境边界[13][14]。安全学习路线应优先传统 OS/Cloud 安全、IAM 和网络隔离,再学习 Prompt Injection,而不是反过来。
8.8 Evaluation 从 Final Answer 转向 Trajectory + Outcome
Agent 说“已完成退款”不代表数据库存在退款 transaction。Agent eval 必须检查环境 outcome;同时 trajectory 可以发现虽成功但用了危险路径、过多工具或越权行为[10][19]。未来 Evals 会越来越类似“软件测试 + 仿真 + 行为分析”的结合。
8.9 Coding Benchmark 进入重构期
SWE-bench Verified 的污染、reference solution 偏差、Harness 混淆和真实 merge gap 已成为 2026 的热点争议[20][36][37]。企业自建 benchmark 应记录 model、harness version、environment hash、dataset version、token budget、retry/stopping rule,并至少做关键组件 ablation。
8.10 Agent Skills / Plugins / Reusable Procedures
多个 Agent 平台正在将可复用的指令、工具、workflow 封装为 skills/plugins。其长期价值是把团队 tacit knowledge 变成版本化、可测试的 executable knowledge。企业应像维护 library 一样维护这些 skills:owner、版本、测试、权限与变更 review。
8.11 Model Efficiency 与 Economics
模型能力提升同时伴随成本/效率竞争。Agent 任务可能调用模型数十到数百轮,因此单次 token 价格不是唯一指标;更重要的是“每成功任务成本”。更强模型如果减少重试、错误搜索和长轨迹,可能比便宜模型总体更低成本。应通过 workload-specific eval 计算 cost per successful outcome。
8.12 Governance Engineering
2026 年的治理热点是从原则转向可证明控制:impact assessment、logging、model/tool inventory、risk register、incident management、traceability。ISO/IEC 42005、NIST 2026 的 Agent traceability 讨论、EU AI Act 执法共同显示,工程团队需要留下“系统做了什么、为什么、谁授权、如何评估”的可审计证据[28][26][30]。
9. 学习路线:从软件工程师到 AI Engineering Lead
9.1 学习原则:稳定层优先于易变层
将知识分为三层:
- 耐久层(5–10 年):编程、网络、数据库、分布式系统、测试、安全、概率统计、产品与需求工程;
- 中期层(2–5 年):RAG、tool calling、eval、agent pattern、observability、MCP/A2A;
- 易变层(数月–2 年):具体模型名、IDE、Agent 产品 UI、某框架 API。
学习时间应向耐久层和中期层倾斜。不要把“熟悉某一框架”误认为 AI Engineering 核心能力。
9.2 0–3 个月:工程与模型基础
目标:能独立完成一个可部署、可测试的非 Agent AI 服务。
软件基础:Python/TypeScript、Git、Linux、HTTP、SQL、Docker、pytest/Jest、CI。
AI 基础:token、context、structured output、tool calling、embedding、模型行为、基础统计。
项目:构建一个文档抽取/分类 API,使用 schema validation、Postgres、Docker、CI,并记录 latency/cost。
验收:不是“页面能展示”,而是有 tests、deployment、logs、错误处理和 README。
9.3 3–6 个月:RAG + Evals + Production
目标:从 Demo 进入可度量系统。
第 1–2 月:完整 RAG,包括 parsing、chunk、hybrid retrieval、reranking、citations。
第 3 月:构建 100–300 case eval set;分别测 retrieval 和 answer;加入 production trace。
项目要求:至少出现三个真实失败类别,并通过 error analysis 做两轮改进,报告改进前后指标和成本。
9.4 6–9 个月:Agent + Coding Agent
目标:能够构建安全 Agent,并用 Agent 开发真实软件。
学习:agent loop、tools、state、memory、approval、MCP、sandbox、trajectory eval。
同时每天使用两种 Coding Agent,记录任务类型、人工干预次数、失败原因和验证器效果。
项目:构建一个事务型 Agent,例如工单/订单系统,只允许读订单;退款工具必须人工批准并使用 idempotency key。对 prompt injection、错误 tool args、timeout、重复调用做 eval。
9.5 9–12 个月:Harness + Shaping + Team-level Engineering
目标:从“使用 Agent”升级为“设计 Agent 工作环境”。
建立 AGENTS.md、统一 verify script、CI、architecture docs;用 issue 驱动 Agent 完成 10–20 个独立任务。增加并行 Agent,但要求所有任务有明确合并和验证机制。
同时训练 Shaping:每个项目必须先写 problem statement、success metric、non-goals、risk matrix、rollout,而不是从技术选型开始。
9.6 36 周建议课程表
W1–4:Python/TS、Git、Linux、测试;
W5–7:HTTP、SQL、transactions、Docker、CI;
W8–10:LLM API、structured output、tool calling;
W11–13:Embedding、RAG、hybrid retrieval、reranking;
W14–16:Eval、统计、LLM judge、人评校准;
W17–19:Agent loop、tools、state、memory;
W20–21:Observability、OpenTelemetry、cost/latency;
W22–23:Prompt injection、sandbox、IAM、OWASP Agentic;
W24–26:Coding Agent、AGENTS.md、verifier、repo engineering;
W27–28:MCP、A2A、remote tools/agents;
W29–30:parallel agents、orchestrator;
W31–32:product discovery、spec、acceptance/eval;
W33–34:governance、NIST/ISO、impact assessment;
W35–36:capstone、生产部署、用户验证、技术报告。
9.7 每阶段必须输出的证据
学习成果应以 artifacts 证明:代码仓库、architecture diagram、eval dataset、failure taxonomy、benchmark report、threat model、runbook、cost dashboard、postmortem、用户反馈。只完成课程证书不能证明工程能力。
10. 知识内容清单与能力要求
10.1 必修知识矩阵
| 领域 | 必须掌握 | 高级要求 |
|---|---|---|
| 编程 | Python/TS 至少一门、async、错误处理、测试 | profiling、runtime、性能与并发 |
| 数据 | SQL、schema、transaction、index | distributed data、migration、consistency |
| 网络 | HTTP/TLS/DNS、timeout、retry | service mesh、rate control、network policy |
| Cloud | Docker、CI/CD、IAM、logs | K8s/IaC/SRE/platform engineering |
| ML/LLM | token、embedding、sampling、context | model routing、fine-tuning tradeoff |
| RAG | ingestion、retrieval、rerank、citation | ACL、freshness、multimodal/graph retrieval |
| Agent | tool、loop、state、memory | long-running、multi-agent、orchestration |
| Eval | dataset、grader、regression | trajectory、calibration、measurement validity |
| Security | AppSec、secret、least privilege | sandbox、prompt injection、agent red team |
| Product | problem、metric、MVP、spec | portfolio prioritization、business ownership |
| Governance | risk log、data handling | NIST/ISO/EU requirements mapping |
10.2 不要求所有人深入的内容
并非所有 AI Engineer 都需要训练 foundation model、CUDA kernel、分布式 pretraining、RLHF 基础设施。对于产品型工程师,这些属于专业分支。更高 ROI 的顺序通常是先确保能把现成模型构建成可靠系统,再根据岗位进入模型训练、推理优化或 AI Infra。
10.3 反例:表面熟练但能力不足
- 会调用多个模型 API,但没有 eval;
- 会搭 Agent framework,但不了解 transaction/idempotency;
- 会让 Coding Agent 生成 PR,但不能审查权限和 migration;
- 会写复杂 Prompt,但无法定位 retrieval/tool failure;
- 会做漂亮 Demo,但没有监控、成本和 rollback;
- 会背 benchmark 分数,但不能设计真实业务测试;
- 能实现别人给出的精确需求,但无法解释需求是否值得做。
11. Portfolio:最能证明 AI Engineering 能力的项目
11.1 Project A:Production RAG
要求:至少 1,000+ 文档;解析、chunk、metadata、ACL、hybrid retrieval、reranker、citation;100+ eval cases;同时报告 retrieval recall、answer quality、citation accuracy、P95 latency 和 cost。必须展示错误分析和版本回归,而不是只展示聊天 UI。
11.2 Project B:Transactional Agent
建立订单/客服 Agent,至少包含 4 个工具,其中一个为高风险写操作。设计 read-only 默认、人工审批、幂等、防重复、audit log、prompt injection eval、tool error recovery。展示失败场景,而不是只展示成功 Demo。
11.3 Project C:Agent-native Repository
仓库包含 AGENTS.md、architecture docs、统一 bootstrap/verify、CI、自动安全扫描。让 Coding Agent 在 Issue 驱动下完成至少 10 个任务,统计每个任务的人类干预、通过率、review rounds、revert。比较加入 verifier 前后 Agent 成功率。
11.4 Project D:Shaped Product
从用户问题开始:访谈/数据 → problem statement → hypothesis → MVP → eval → user test → iteration。最终报告必须回答:为什么做、为什么不是其他方案、哪些约束最重要、何时决定减 scope、最终业务指标如何变化。
11.5 Project E:Long-running Agent
选择一个需要 1–3 小时运行的技术任务,设计 checkpoint、external memory、budget、retry、resume 和 multi-stage verifier。故意注入一次工具故障和一次 context interruption,验证 Agent 是否可恢复。
12. 招聘与能力评估框架
12.1 为什么传统 LeetCode + System Design 不足
传统考察仍有价值,但无法测试 Candidate 是否会管理概率性系统、Coding Agent 和 eval。反过来,完全让候选人“用 AI 做一个 App”也可能只测工具熟练度。合理面试应同时测试基础与 Agent leverage。
12.2 四维评分模型
每项 0–4 分:
A. AI Application Engineering:是否会定义 eval、设计 RAG/tool、处理失败、部署和观测;
B. Software Engineering:数据、架构、并发、测试、安全、可靠性;
C. Coding Agent:上下文、spec、verifier、review、权限、并行/委派;
D. Shaping:是否识别用户问题、价值、非目标、风险和成功指标。
高级岗位要求四项均无明显短板,而不是某一项满分。
12.3 推荐面试任务
给候选人一个有意模糊的业务问题和小型 repo,允许使用 Coding Agent。观察其第一步:优秀候选人通常先澄清目标、读架构、找到验证命令、建立计划和约束,而不是立即生成大量代码。随后人为注入一个错误测试或不可信文档,观察是否能发现 verifier 或 prompt injection 问题。
12.4 Review 面试
提供 Agent 生成的 PR,其中包含:隐藏的 N+1 查询、非幂等 retry、过宽 IAM、缺失 transaction、看似通过但弱化测试。要求候选人评审。这个任务能同时检测软件基础和 Agent 时代的监督能力。
12.5 Hiring Signal
强信号:有真实 production metrics、能展示失败案例和 postmortem、能解释 tradeoff、能把 product metric 与 eval 连接、知道什么时候不该用 Agent。弱信号:工具列表很长、Prompt 模板很多、只有截图 Demo、只讲 benchmark、无法解释安全边界。
13. 企业团队能力建设与平台化
13.1 成熟度 Level 0–4
L0 Ad hoc:个人使用聊天/补全,无统一政策。
L1 Assisted:团队使用 Coding Agent,但主要同步人工监督。
L2 Measured:有 eval、统一日志、安全准入和 cost tracking。
L3 Agentic:后台 Agent、issue delegation、sandbox、agent-native repo。
L4 Orchestrated:system harness 自动分解/调度,多层 verifier,生产反馈回流,治理可审计。
13.2 平台团队应提供什么
平台不应只采购模型 API,而应提供:模型 gateway、身份/权限、sandbox、MCP registry、secret broker、trace storage、eval service、prompt/harness versioning、cost quota、approved tools、PII redaction、incident response、agent templates。
DORA 的平台工程研究说明内部开发平台和清晰反馈机制是 AI 扩大生产率的基础之一[4]。Agent 时代的 Developer Platform 将进一步承担执行环境和安全控制面。
13.3 指标体系
不要只看“生成代码行数”或“AI 使用率”。建议指标分四层:
- Outcome:用户/业务成功指标;
- Delivery:lead time、PR acceptance、revert、incident;
- Agent:task success、human intervention、retry、trajectory length;
- Economics:cost per successful task、latency、token/sandbox cost。
13.4 组织风险
高风险包括:大量 Agent 产生 PR 但 review capacity 不变;Agent 自动改测试使质量指标虚高;多个 Agent 重复实现形成架构漂移;团队过度依赖模型导致新人基础能力退化;工具接入过快导致凭据和数据边界失控。
应建立 architecture guardians、测试质量检查、dependency policy、agent action audit 和定期 human-only drills,以保持独立工程能力。
14. 关键争议、局限与研究空白
14.1 “AI 是否提高开发者生产率”没有单一答案
现有证据存在显著条件差异。METR 2025 RCT 在熟悉大型 OSS repo 的开发者中观察到减速;2026 self-report 则显示高价值提升感受;厂商案例报告更大幅度收益[6][7][15]。这些研究的任务分布、模型代际、参与者选择、指标和 Harness 不同,不能直接互相否定。更合理的研究对象是“哪些任务和组织条件下,何种 Agent workflow 提高哪一种 outcome”。
14.2 Benchmark 的外部有效性不足
SWE-bench 类型任务仍以 patch 和 hidden tests 为中心,而真实高级工程包含模糊需求、跨团队沟通、演进、维护、部署与长期责任[34][35][37]。因此 benchmark 更适合测特定能力,而不是预测完整岗位替代率。
14.3 长时 Agent 的验证成本很高
长任务需要数百万到数千万 token、复杂环境和多通道 oracle,评测本身成本高[35]。这会导致企业无法对每次模型更新完整重跑。未来需要分层 eval:快速回归 + 代表性长任务 + 生产 shadow evaluation。
14.4 Agent 安全仍是开放问题
模型越来越强时,一方面更少犯低级错误,另一方面更能找到绕过限制的意外路径。模型层防御无法提供绝对保证,因此权限和 containment 仍必须由传统安全系统承担[14]。
14.5 教育与初级岗位的张力
如果初级工程工作大量被 Agent 吸收,组织如何让新人获得架构、debug 和 production 经验是未解决问题。企业需要刻意设计“learning loop”,避免把所有基础任务完全外包给 Agent,造成长期 senior pipeline 缺口。
14.6 Shaping 的可测量性仍较弱
前三项技能有较清晰的技术 artifact,而 Shaping 涉及判断和业务上下文。未来人才评估需要更多基于真实 case 的 work sample,而不是依赖知识问答。
15. 2026–2028 的趋势判断
以下为基于当前证据的推断,不是确定事实。
15.1 Agent-native 开发会成为默认工作流之一
主流工具已经从 autocomplete 转向可后台执行、可并行、可创建 PR 的 Agent[17][39]。预计“人工逐行写代码”不会消失,但更多工程团队会以任务委派、结果 review、异常介入为主。
15.2 Verifier Infrastructure 会成为新的开发平台资产
随着 Agent 生成速度上升,组织差异将越来越取决于“机器能否快速知道自己是否做对”。高质量测试、静态分析、沙箱、仿真、eval、数据质量和生产 telemetry 会成为复合竞争优势。
15.3 System Harness 会成为可优化的软件资产
当前已出现把 Harness 本身作为研究和优化对象的论文与工业实践[36][37]。未来团队可能像优化编译器/数据库一样优化 context policy、tool selection、retry、model routing 和 reviewer stack。
15.4 Spec 与代码的边界会继续上移
当明确 spec 的实现越来越自动,工程师价值将更集中于问题选择、约束、架构、验收和风险。设计文档、ADR、eval suite 和 policy 可能成为比手写实现代码更核心的 human-authored artifacts。
15.5 Agent Protocol 会从连接问题转向信任问题
MCP/A2A 解决互操作后,下一阶段瓶颈将是 identity、authorization、attestation、policy、provenance 和 audit。能够连接不等于能够安全信任。
15.6 AI Engineering 与治理将进一步融合
EU AI Act、ISO 42001/42005、NIST 和 OWASP 正把风险、impact、日志、监督转换为生命周期要求[24][26][28][30]。高级 AI Engineer 将越来越需要理解 governance-by-design。
16. 结论
AI Engineering Skills Map 的四个维度实际上描述了软件工程职责的重新分配:
- Building and deploying AI applications 解决“如何把概率性模型变成可测、可控、可运营的系统”;
- Software engineering fundamentals 提供确定性边界、架构权衡、安全和可靠性;
- Using coding agents 把个人执行能力扩展为 Agent 与 Harness 的杠杆,并要求新的上下文、验证、权限和编排能力;
- Shaping the build 负责问题选择、约束、产品价值、风险和验收,使自动执行有正确目标。
2026 年真正值得长期投资的技能,不是某个特定 Agent 产品的快捷键,也不是 Prompt 技巧集合,而是以下稳定循环:
Problem → Spec → Architecture → Context/Tools → Agent/Implementation → Verification/Eval → Deployment → Observation → User/Business Feedback → Next Spec
未来模型和工具会持续快速变化,但这个闭环的各个环节不会消失。对个人而言,最有效的学习策略是:先把软件工程基础做深,再用真实 AI 系统训练 eval、context、agent 和安全;持续用 Coding Agent 提高执行杠杆,但始终保持可验证性;最终把能力上移到问题定义与业务结果。对企业而言,真正的 AI Engineering 能力也不是“员工是否使用 AI”,而是是否建立了能够把 Agent 速度转化为可靠交付、可控风险和业务价值的系统能力。
附录 A:AI Engineering 自评 Checklist
A.1 Building & Deploying AI Applications
- 能解释 structured output 与自由文本解析的差别
- 能设计 tool schema、错误语义和权限
- 能构建 hybrid RAG,并分别评估 retrieval 与 generation
- 能建立 ≥100 case 的 eval set
- 能做 error taxonomy 和 regression
- 能实现 trajectory tracing
- 能估算 cost per successful outcome
- 能设计 fallback、timeout、retry、rate limit
- 能处理 prompt injection 与 data leakage
- 能部署并维护 SLO
A.2 Software Engineering Fundamentals
- 熟练一门主语言和测试框架
- 理解 async/concurrency
- 熟练 SQL、index、transaction
- 理解 HTTP、TLS、timeout、idempotency
- 理解 queue、eventual consistency、backpressure
- 会 Docker/CI/CD/IAM
- 会设计 rollback 和 migration
- 能做 threat modeling
- 能读 profiler/log/trace
- 能审查 Agent 生成代码的 maintainability
A.3 Coding Agents
- 能为任务提供 goal/constraints/acceptance/non-goals
- 有 AGENTS.md 或等价 repo instruction
- 有统一 verify script
- 能根据任务选择 direct/plan/background 模式
- 能安全管理 sandbox/network/secrets
- 能并行委派多个低耦合任务
- 能评估 human intervention rate
- 理解 MCP/A2A 的边界
- 能建立 reviewer/verifier Agent
- 不把 benchmark score 当真实 repo 成功率
A.4 Shaping the Build
- 能从用户问题而非技术方案开始
- 能写 success metric
- 能明确 non-goals
- 能识别最高风险假设
- 能决定 MVP 与高保障交付的边界
- 能把 acceptance criteria 转成 eval
- 能估算单位经济与错误成本
- 能识别隐私/监管影响
- 能做 rollout/rollback 设计
- 能依据用户反馈改变 scope
附录 B:项目评审评分表
| 维度 | 0 分 | 1 分 | 2 分 | 3 分 | 4 分 |
|---|---|---|---|---|---|
| 问题定义 | 无 | 技术导向 | 有用户描述 | 有指标/约束 | 有证据、风险和取舍 |
| 架构 | 无 | Demo | 基础分层 | 有故障/安全 | 有明确 tradeoff 与演进 |
| Eval | 无 | 手工感受 | 少量 case | 自动回归 | 生产反馈闭环 |
| RAG/Agent | API 调用 | 简单流程 | 工具/检索 | 状态/错误恢复 | 长时/权限/观测成熟 |
| 软件质量 | 无测试 | 单元测试 | CI | 集成/E2E | SLO/rollback/security |
| Coding Agent | 生成代码 | 局部使用 | 任务委派 | verifier/repo context | orchestrator/metrics |
| 安全 | 无 | Prompt 警告 | 基础权限 | sandbox/audit | defense-in-depth/red team |
| 产品结果 | 无 | Demo | 用户试用 | 指标变化 | 可解释的业务 outcome |
附录 C:90 天强化计划
Day 1–30:每天使用 Coding Agent,但所有修改必须经 tests;补齐 HTTP/SQL/transaction/Docker;完成一个 structured-output API;建立个人 verify 模板。
Day 31–60:完成 RAG + 100 case eval;加入 traces;做两轮 error analysis;写一份 postmortem。
Day 61–90:构建 3–5 tool Agent;引入 sandbox 与 human approval;使用 Agent 完成真实 repo 中 10 个 issue;最后写 problem→spec→eval→production 的技术报告。
每周记录四个指标:委派任务数、一次通过率、人类干预次数、发现的高严重度错误。目标不是让“AI 使用率”最大,而是提高可验证成功任务的吞吐。
参考文献
[1] DeepLearning.AI. The AI Engineering Skills Map. 2026-08. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map
[2] Stanford Institute for Human-Centered AI. The 2026 AI Index Report. 2026. https://hai.stanford.edu/ai-index/2026-ai-index-report
[3] Stanford HAI. 2026 AI Index Report: Economy. 2026. https://hai.stanford.edu/ai-index/2026-ai-index-report/economy
[4] Google DORA. State of AI-assisted Software Development 2025 / AI Capabilities Model. 2025-2026. https://dora.dev/research/publications/
[5] World Economic Forum. Future of Jobs Report 2025. 2025. https://www.weforum.org/publications/the-future-of-jobs-report-2025/
[6] METR. Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. 2025. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
[7] METR. Measuring the Self-Reported Impact of Early-2026 AI on Technical Worker Productivity. 2026. https://metr.org/blog/2026-05-11-ai-usage-survey/
[8] METR. Task-Completion Time Horizons of Frontier AI Models. 2026. https://metr.org/time-horizons/
[9] Anthropic. Effective context engineering for AI agents. 2025. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
[10] Anthropic. Demystifying evals for AI agents. 2026. https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
[11] Anthropic. How we built our multi-agent research system. 2025. https://www.anthropic.com/engineering/multi-agent-research-system
[12] Anthropic. Building a C compiler with a team of parallel Claudes. 2026. https://www.anthropic.com/engineering/building-c-compiler
[13] Anthropic. How we built Claude Code auto mode: a safer way to skip permissions. 2026. https://www.anthropic.com/engineering/claude-code-auto-mode
[14] Anthropic. How we contain Claude across products. 2026. https://www.anthropic.com/engineering/how-we-contain-claude
[15] OpenAI. Harness engineering: leveraging Codex in an agent-first world. 2026. https://openai.com/index/harness-engineering/
[16] OpenAI. Unrolling the Codex agent loop. 2026. https://openai.com/index/unrolling-the-codex-agent-loop/
[17] OpenAI. An open-source spec for Codex orchestration: Symphony. 2026. https://openai.com/index/open-source-codex-orchestration-symphony/
[18] OpenAI. The next evolution of the Agents SDK. 2026. https://openai.com/index/the-next-evolution-of-the-agents-sdk/
[19] OpenAI. Evaluation best practices / Trace grading / Agent improvement loop. 2026. https://developers.openai.com/api/docs/guides/evaluation-best-practices
[20] OpenAI. Why SWE-bench Verified no longer measures frontier coding capabilities. 2026. https://openai.com/index/why-we-no-longer-evaluate-swe-bench-verified/
[21] Model Context Protocol. Specification 2026-07-28. 2026. https://modelcontextprotocol.io/specification/2026-07-28
[22] A2A Project / Linux Foundation. Agent2Agent Protocol Specification. 2026. https://a2a-protocol.org/latest/specification/
[23] OpenTelemetry. GenAI Observability and Semantic Conventions. 2026. https://opentelemetry.io/blog/2026/genai-observability/
[24] OWASP GenAI Security Project. Top 10 for Agentic Applications 2026. 2025-2026. https://genai.owasp.org/resource/owasp-top-10-for-agentic-applications-for-2026/
[25] OWASP GenAI Security Project. Top 10 for LLM Applications 2026. 2026. https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/
[26] NIST. AI Risk Management Framework and Generative AI Profile. 2023-2026. https://www.nist.gov/itl/ai-risk-management-framework
[27] ISO/IEC. ISO/IEC 42001:2023 Artificial intelligence — Management system. 2023. https://www.iso.org/standard/42001
[28] ISO/IEC. ISO/IEC 42005:2025 AI system impact assessment. 2025. https://www.iso.org/standard/42005
[29] ISO/IEC. ISO/IEC 25010:2023 Product quality model. 2023. https://www.iso.org/standard/78176.html
[30] European Commission. AI Act — application and enforcement timeline. 2026. https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai
[31] Lewis et al.. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. 2020. https://arxiv.org/abs/2005.11401
[32] Yao et al.. ReAct: Synergizing Reasoning and Acting in Language Models. 2022/2023. https://arxiv.org/abs/2210.03629
[33] Jimenez et al.. SWE-bench: Can Language Models Resolve Real-World GitHub Issues?. 2023/2024. https://arxiv.org/abs/2310.06770
[34] Miserendino et al.. SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering?. 2025. https://arxiv.org/abs/2502.12115
[35] SWE-Marathon authors. SWE-Marathon: Can Agents Autonomously Complete Ultra-Long-Horizon Software Work?. 2026. https://arxiv.org/abs/2606.07682
[36] Lee et al.. Stop Comparing LLM Agents Without Disclosing the Harness. 2026. https://arxiv.org/abs/2605.23950
[37] Gorinova et al.. Position: Coding Benchmarks Are Misaligned with Agentic Software Engineering. 2026. https://arxiv.org/abs/2606.17799
[38] GitHub. Octoverse 2025 (updated 2026): AI, agents, and typed languages. 2025-2026. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
[39] GitHub. What’s new with GitHub Copilot coding agent. 2026. https://github.blog/ai-and-ml/github-copilot/whats-new-with-github-copilot-coding-agent/
[40] GitHub. Copilot coding agent supports AGENTS.md custom instructions. 2025. https://github.blog/changelog/2025-08-28-copilot-coding-agent-now-supports-agents-md-custom-instructions/
[41] Google Cloud. Choose a design pattern for your agentic AI system. 2026. https://docs.cloud.google.com/architecture/choose-design-pattern-agentic-ai-system
[42] Google Cloud. Choose your agentic AI architecture components. 2026. https://docs.cloud.google.com/architecture/choose-agentic-ai-architecture-components
[43] Google Cloud. Gemini Enterprise Agent Platform: runtime, memory, evaluation and observability. 2026. https://cloud.google.com/blog/products/ai-machine-learning/introducing-gemini-enterprise-agent-platform
[44] OpenAI. GPT-5.6: frontier intelligence and efficiency / agentic harness efficiency. 2026. https://openai.com/index/gpt-5-6-frontier-intelligence-efficiency/