22580:从 GPT2 到 Kimi3 的演进
原文作者:ali (@waterloointern) · 原文发布时间:Jul 27, 2026 · 查看 X 原文
原文作者:ali (@waterloo_intern) · 原文发布时间:Jul 27, 2026 · 查看 X 原文
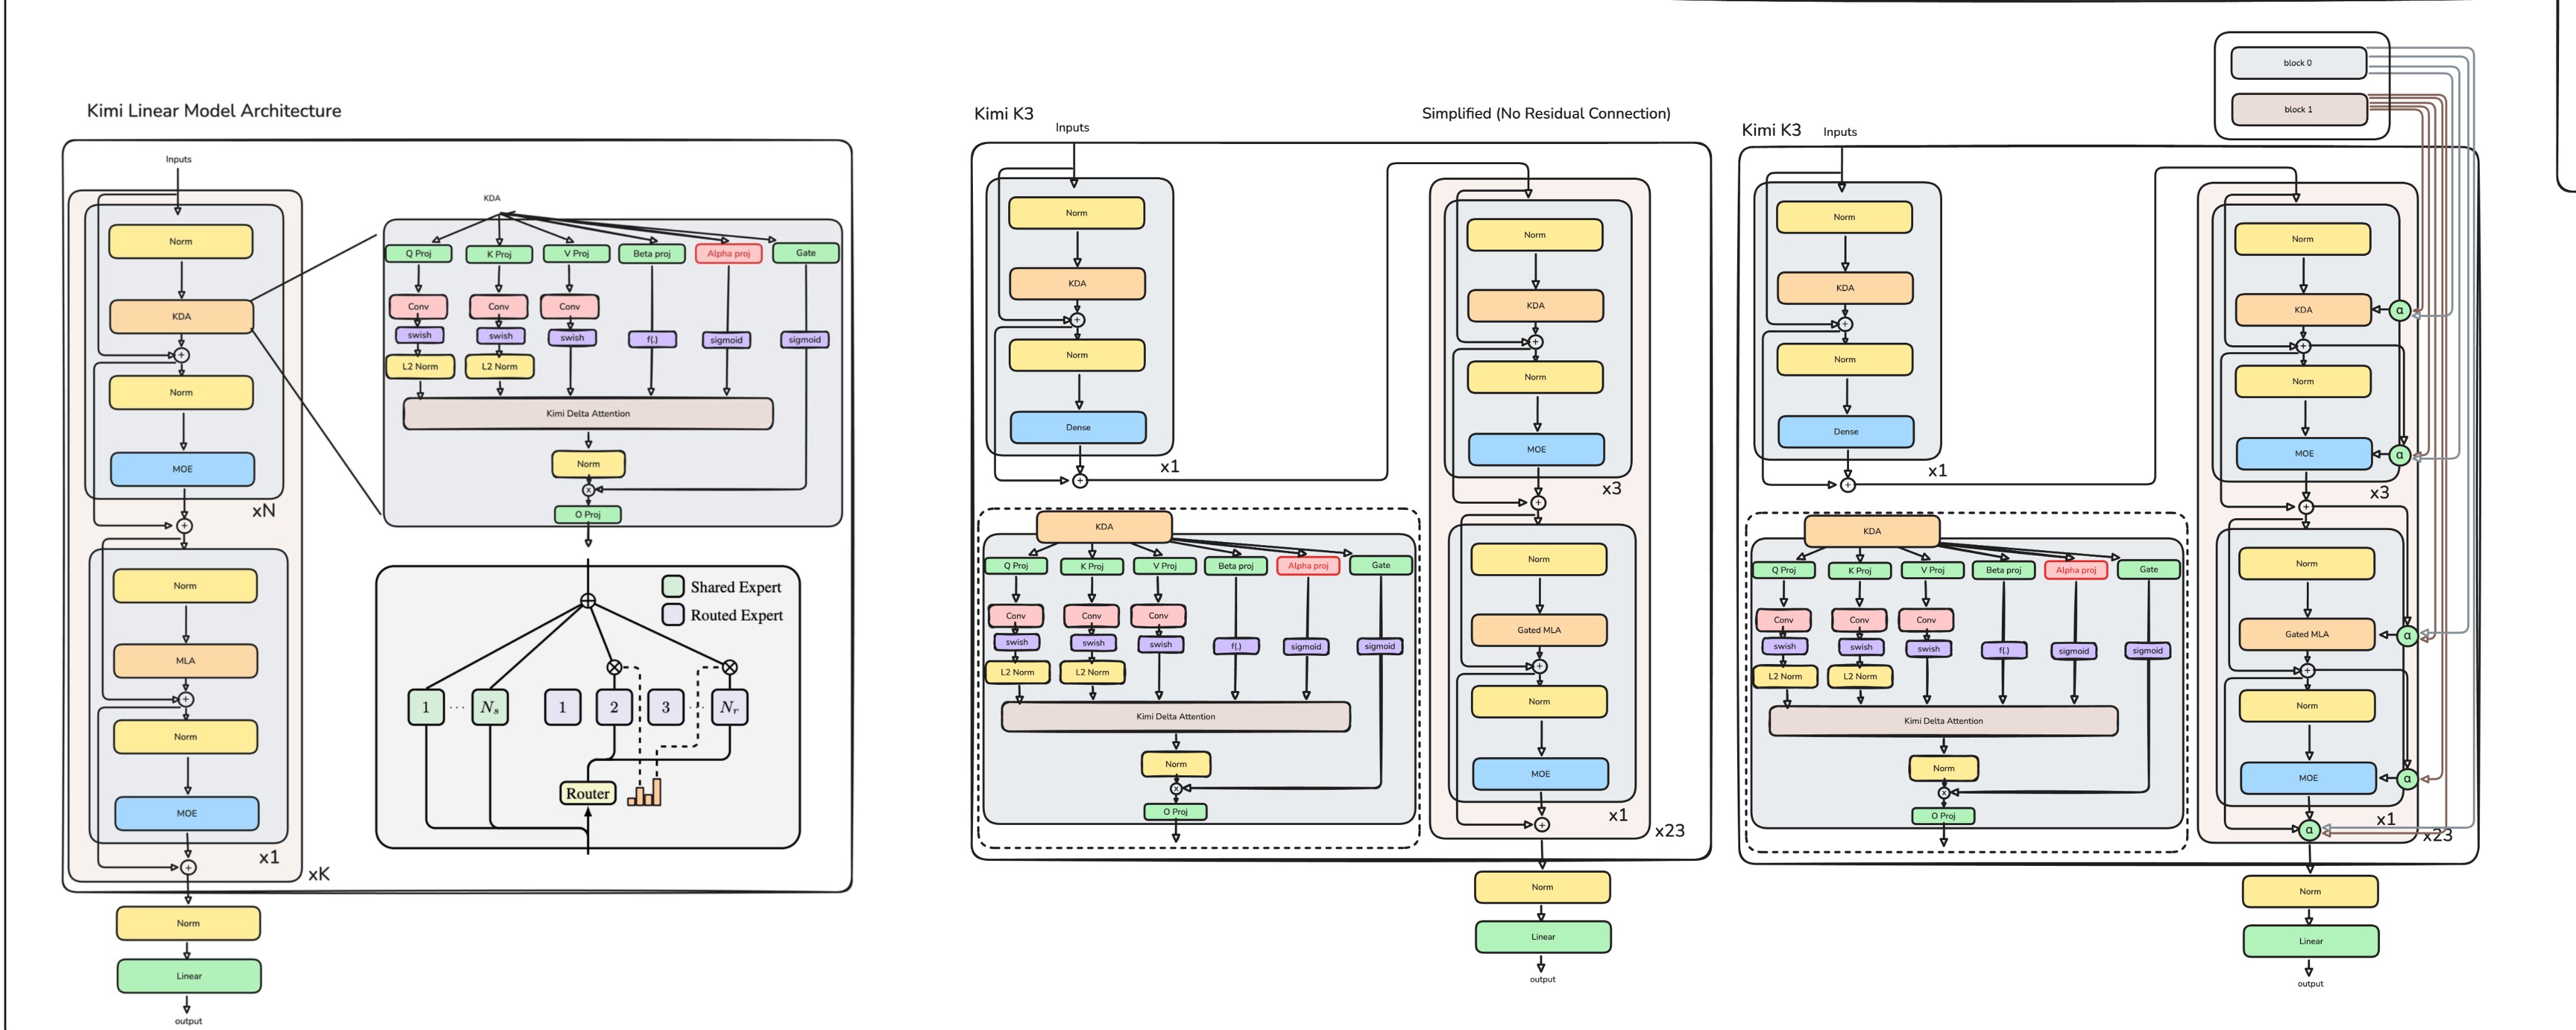
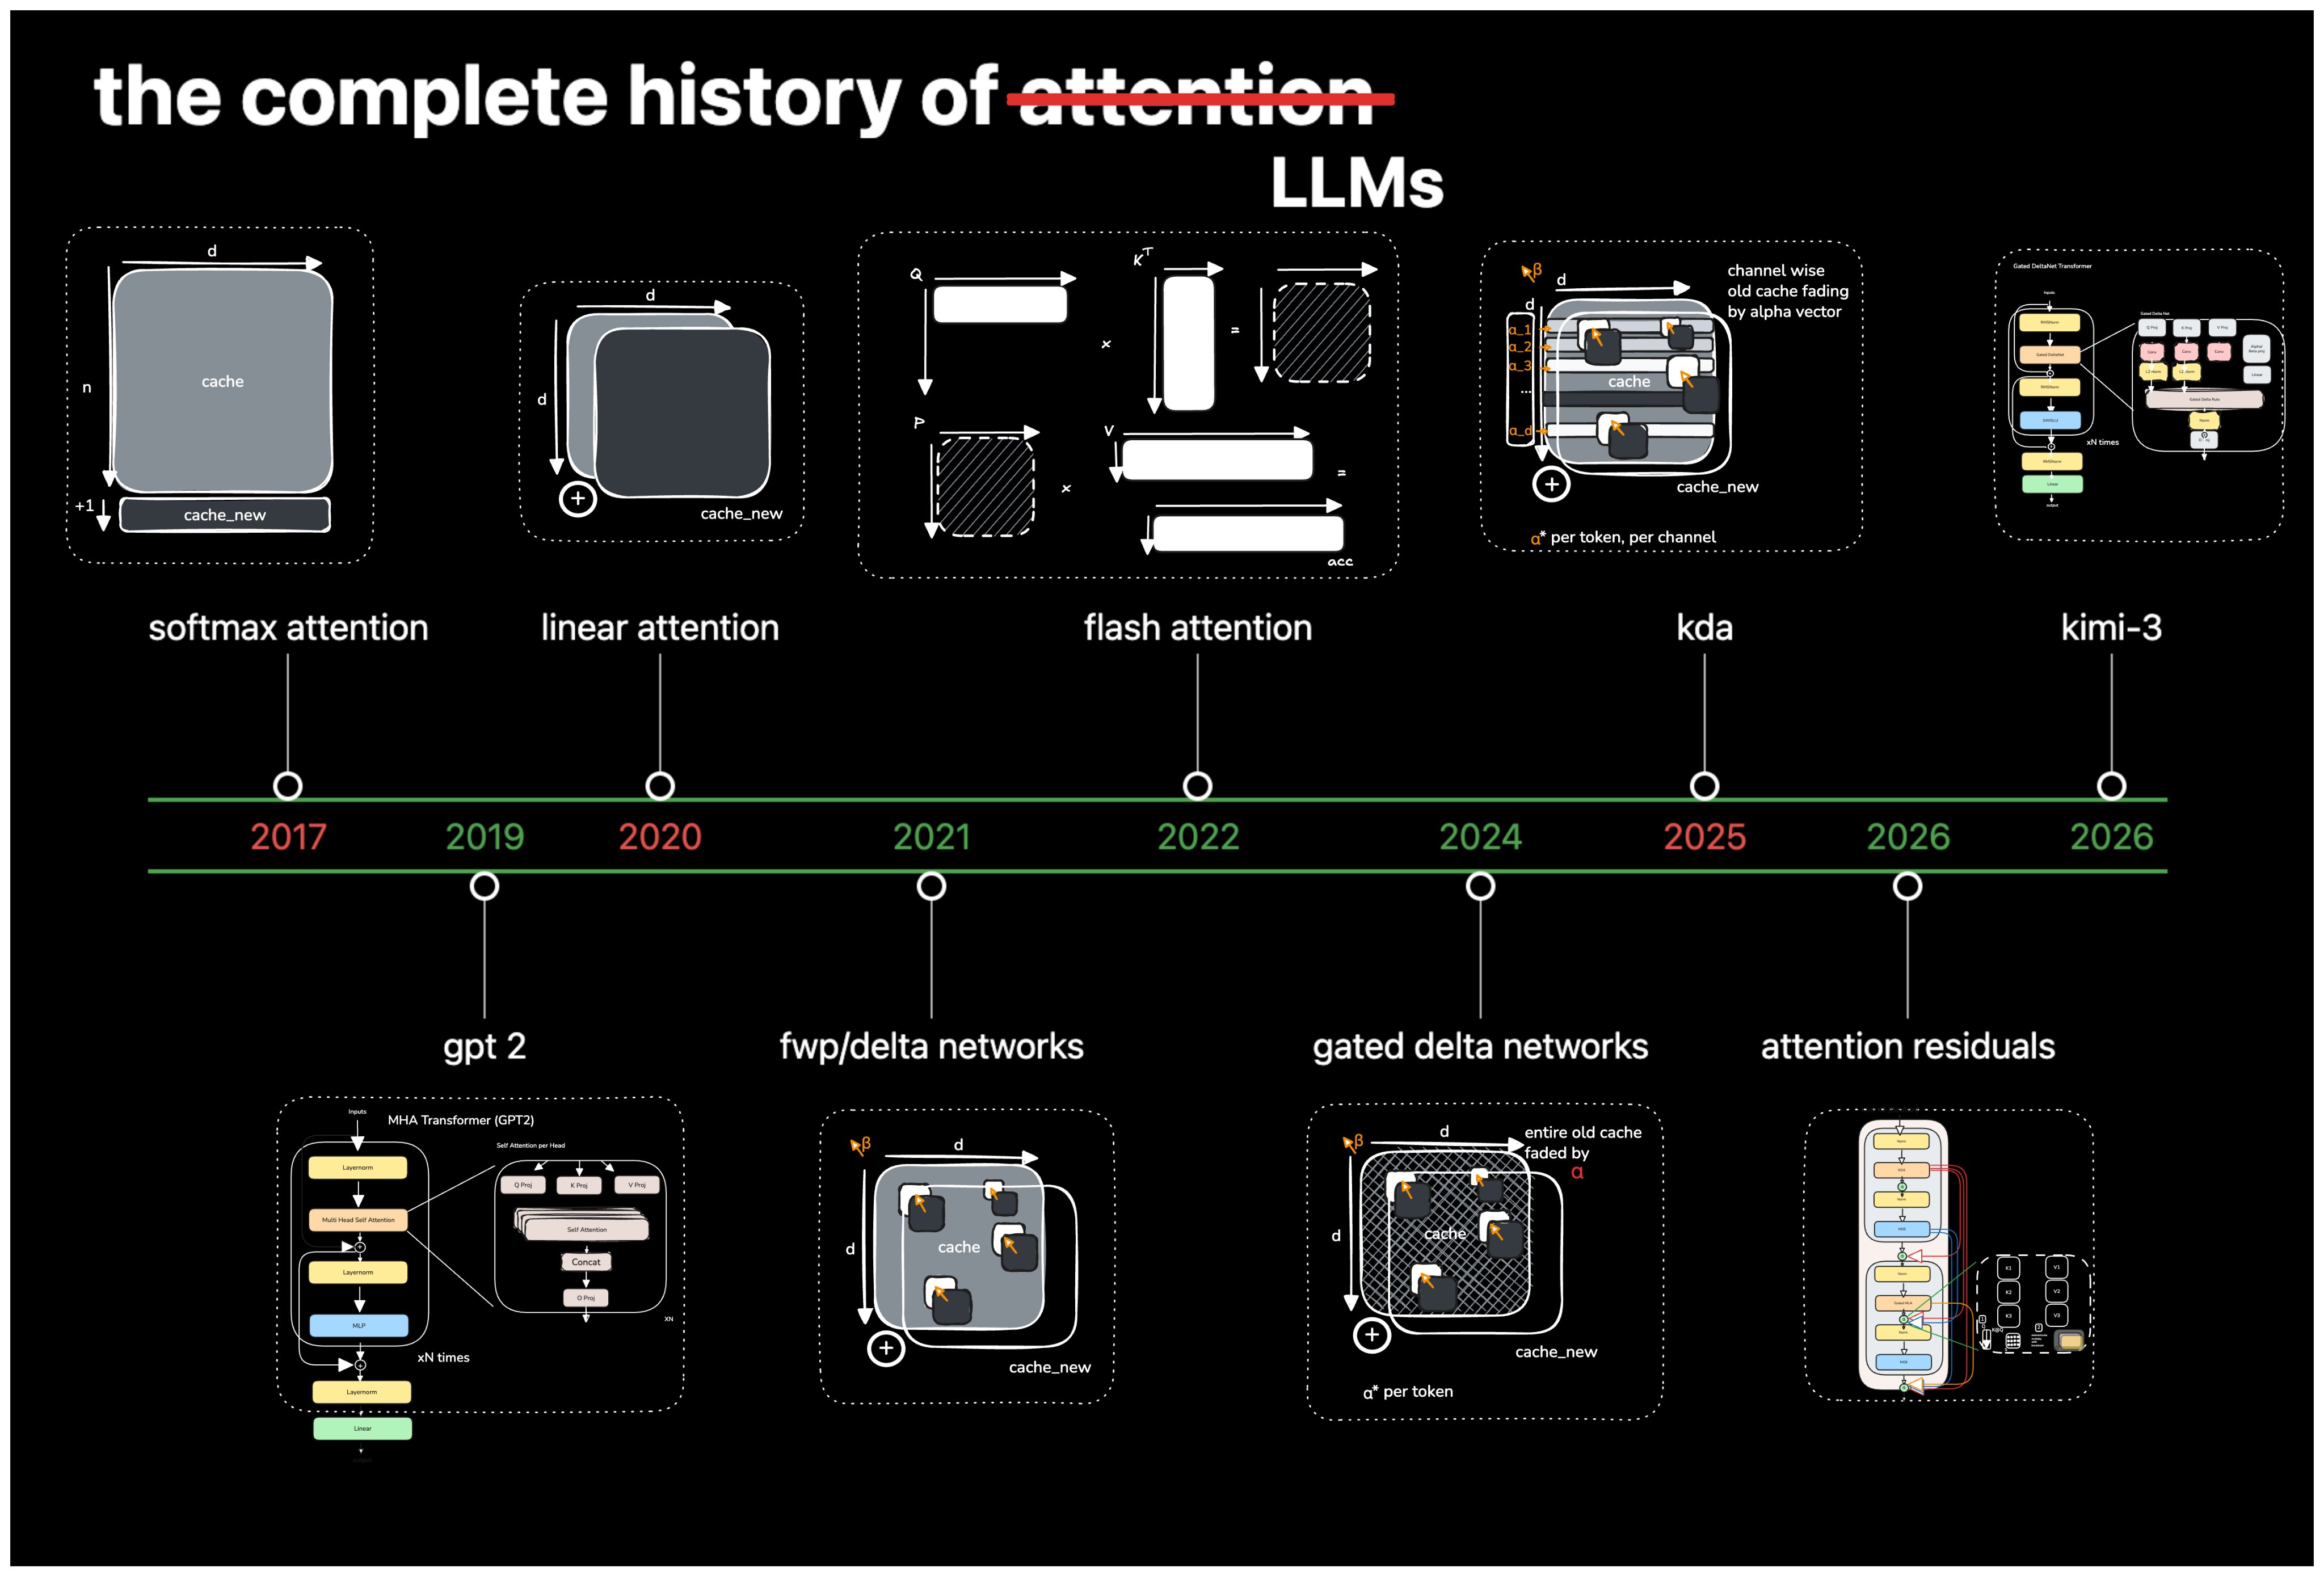
22580。这个数字代表 2026 年的 KimiK3 中,可以装下多少个 2019 年的 GPT-2 模型。七年间,我们把规模扩大了 22,580 倍。但这真的只是规模吗?
在这篇工作记录中,我会带你走过这条路,看看从那时到现在究竟发生了多少变化,又有多少东西其实没有变。我们将追踪最终通向 KimiK3 的主要架构演进。
GPT-2
GPT-2 是一种仅含解码器的架构:
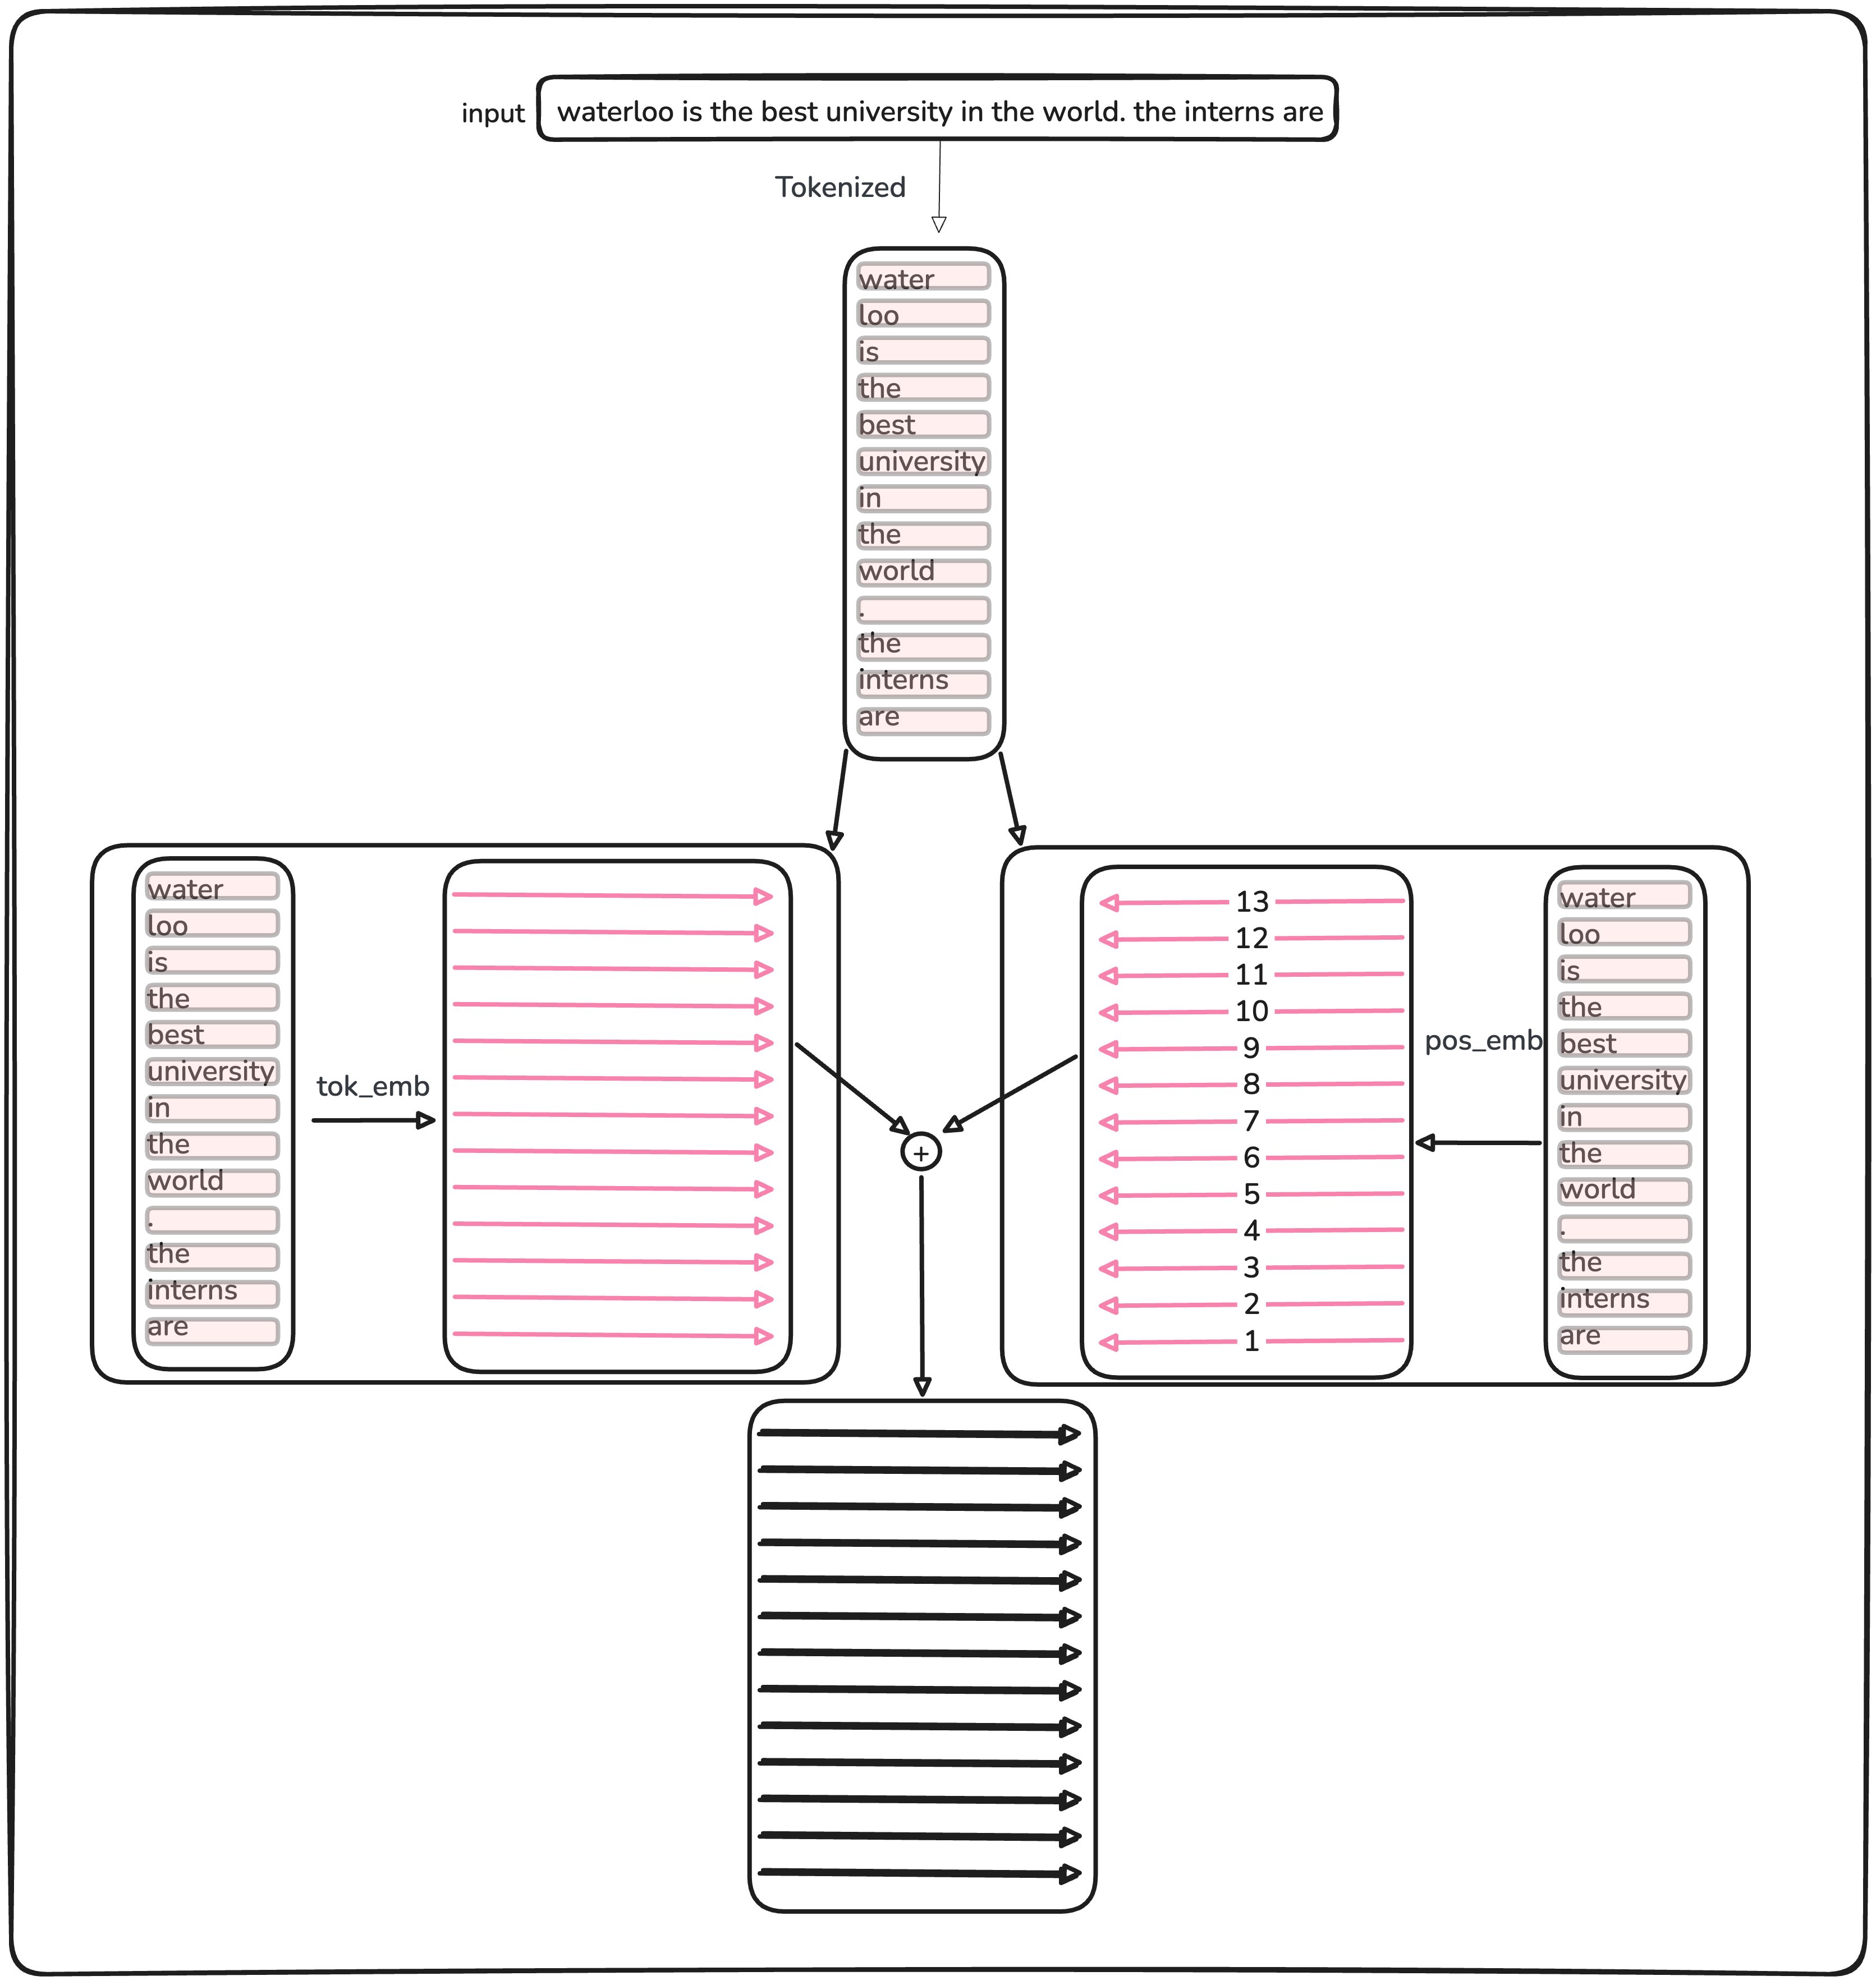
tok_emb = self.transformer.wte(idx) # token embeddings of shape (b, t, n_embd)
pos_emb = self.transformer.wpe(pos) # position embeddings of shape (t, n_embd)
x = self.transformer.drop(tok_emb + pos_emb)
for block in self.transformer.h:
x = block(x)
x = self.transformer.ln_f(x)
logits = self.lm_head(x)
return logits
输入会接收 token embedding 和位置 embedding:
把每个 Transformer block 放大来看,它是这样的:
class Block(nn.Module):
def __init__(self, config):
super().__init__()
self.ln_1 = LayerNorm(config.n_embd, bias=config.bias)
self.attn = CausalSelfAttention(config)
self.ln_2 = LayerNorm(config.n_embd, bias=config.bias)
self.mlp = MLP(config)

def forward(self, x):
x = x + self.attn(self.ln_1(x))
x = x + self.mlp(self.ln_2(x))
return x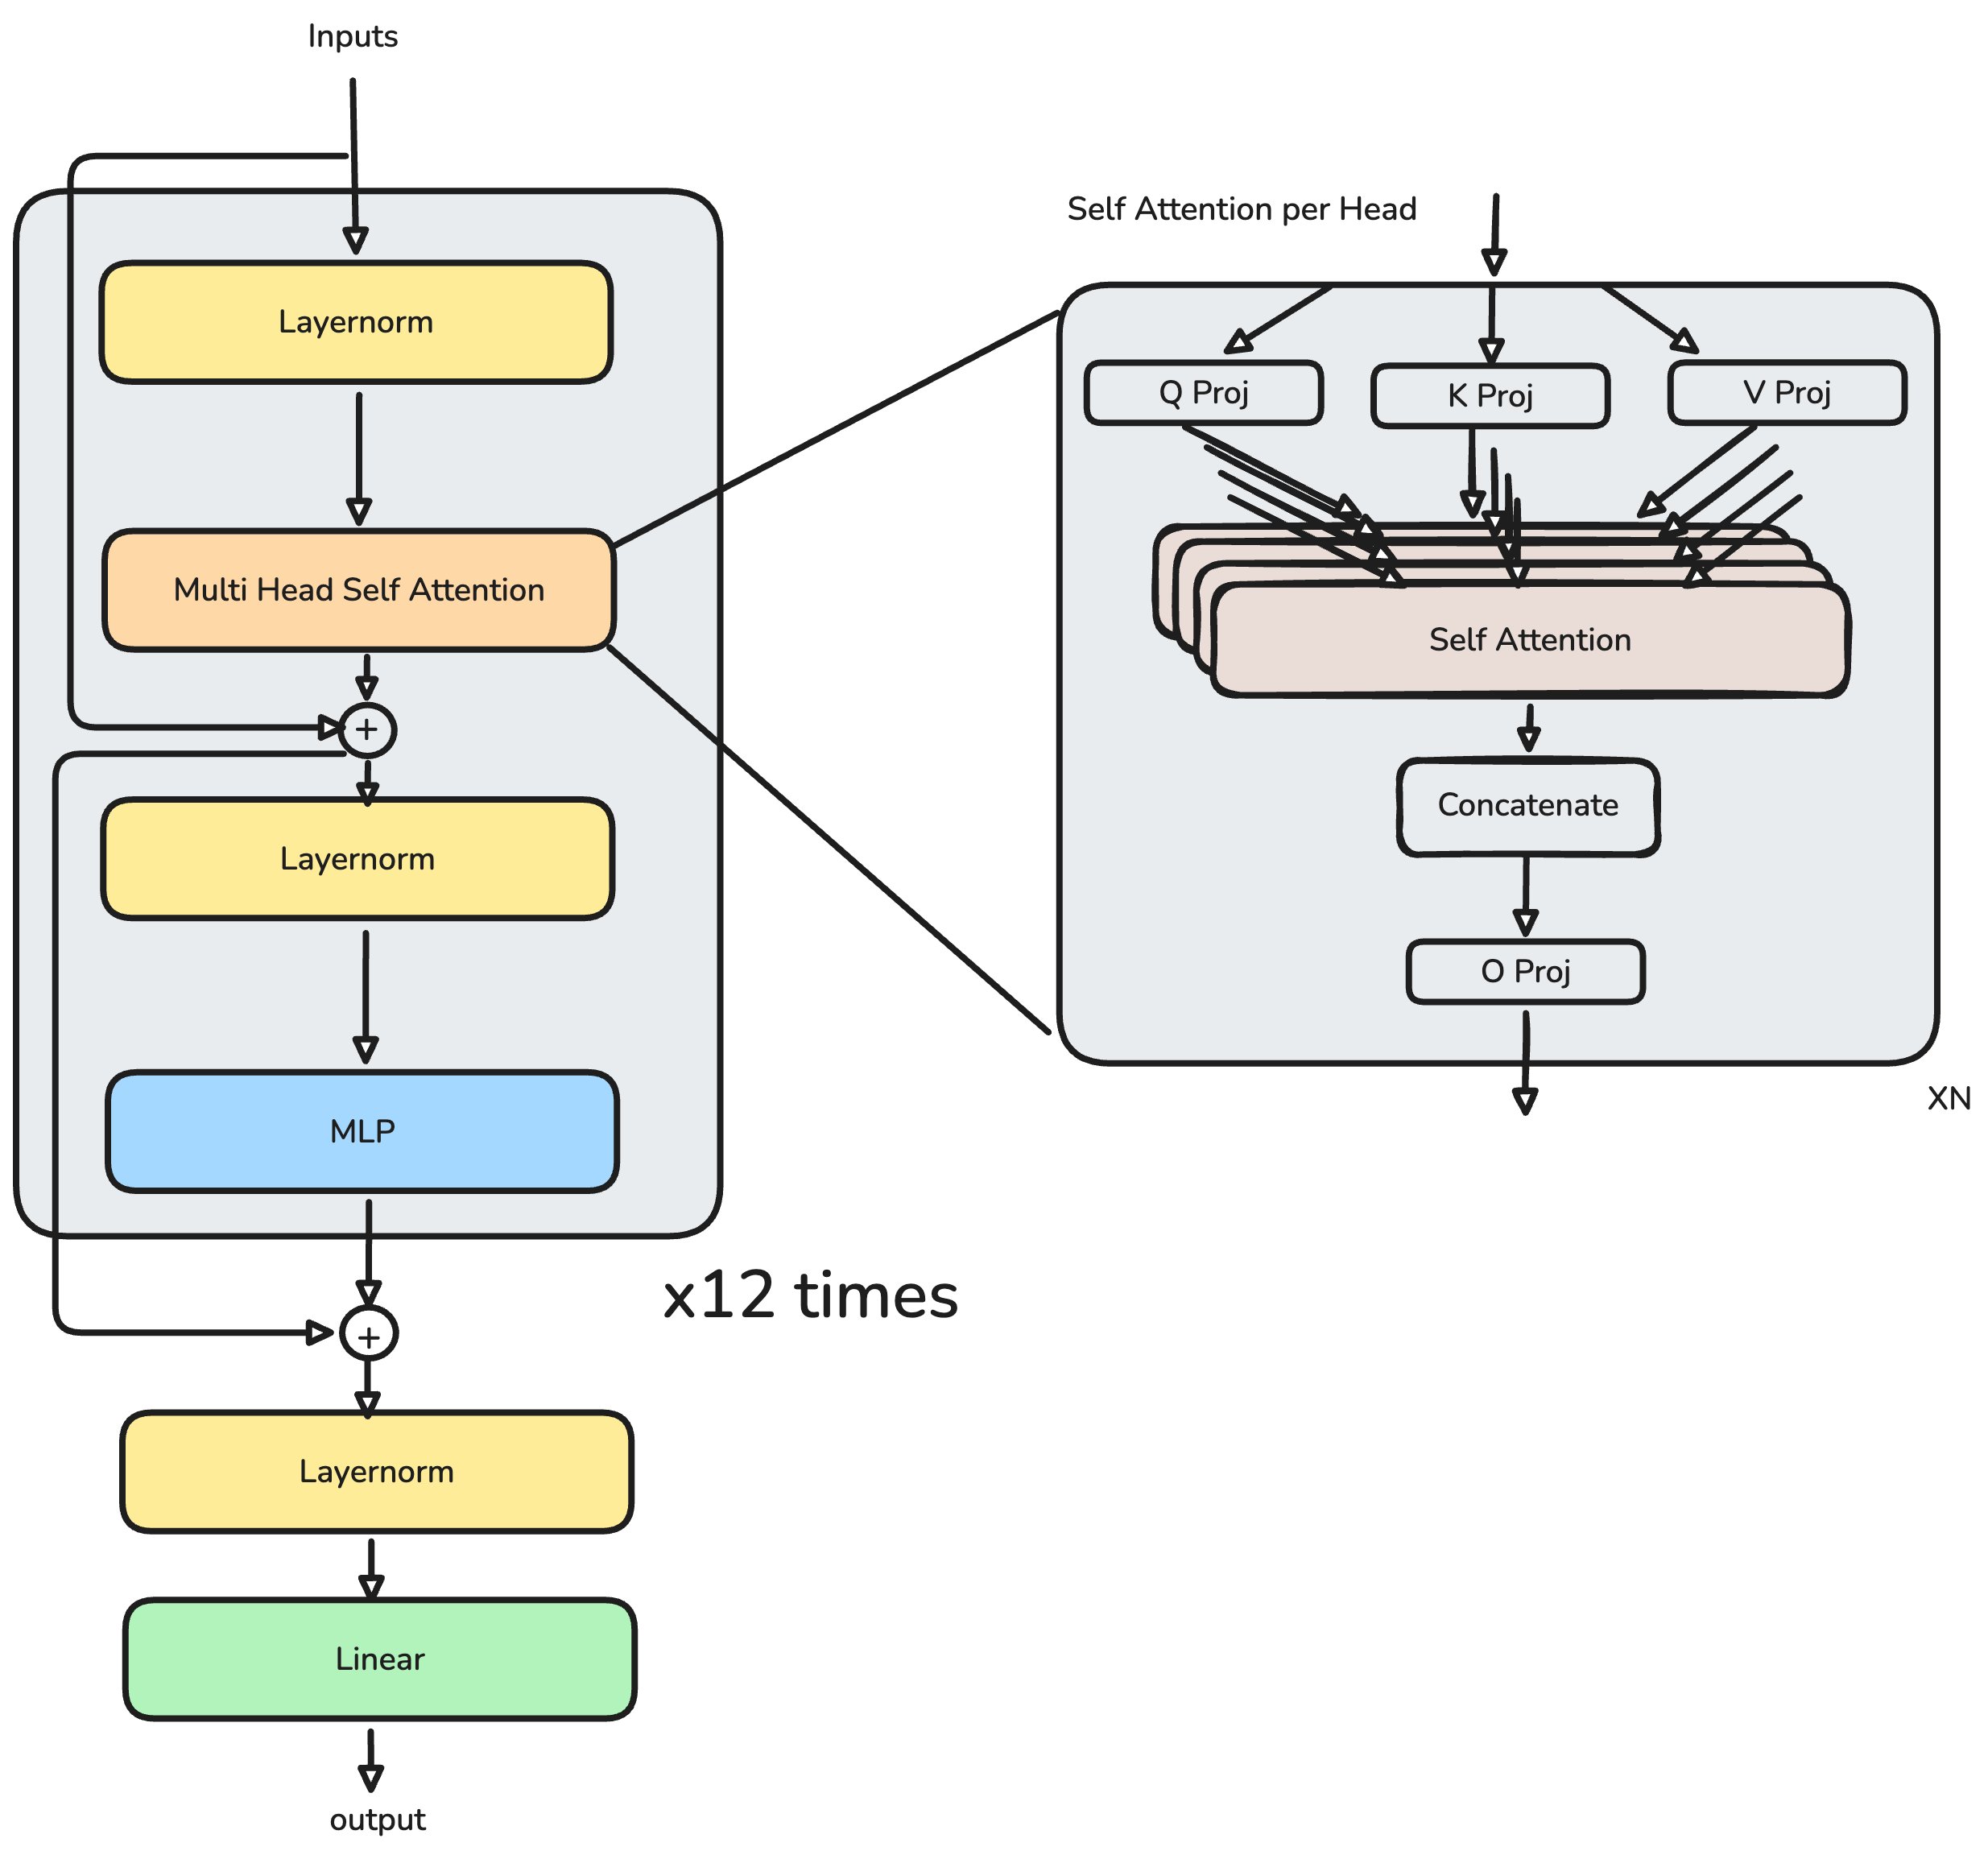
注意力过程:
B, T, C = x.size() # batch size, sequence length, embedding dimensionality (n_embd)

# calculate query, key, values for all heads in batch and move head forward to be the batch dim
q, k, v  = self.c_attn(x).split(self.n_embd, dim=2)
k = k.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) # (B, nh, T, hs)
q = q.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) # (B, nh, T, hs)
v = v.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) # (B, nh, T, hs)

# manual implementation of attention
att = (q @ k.transpose(-2, -1)) * (1.0 / math.sqrt(k.size(-1)))
att = att.masked_fill(self.bias[:,:,:T,:T] == 0, float('-inf'))
att = F.softmax(att, dim=-1)
att = self.attn_dropout(att)
y = att @ v # (B, nh, T, T) x (B, nh, T, hs) -> (B, nh, T, hs)
y = y.transpose(1, 2).contiguous().view(B, T, C) # re-assemble all head outputs side by side

# output projection
y = self.resid_dropout(self.c_proj(y))
return y
得到最终的 hidden-state 矩阵后,语言模型头会把它映射为词表 logits。在自回归解码时,我们只需要最后一个位置的 logits 来选择下一个 token。
这正是仅含解码器的生成方式低效之处:模型会为每个输入位置计算表示,但每一步解码只会用到最后一个位置的 logits。如果没有缓存,下一次生成时其中大量计算都会被重复执行。
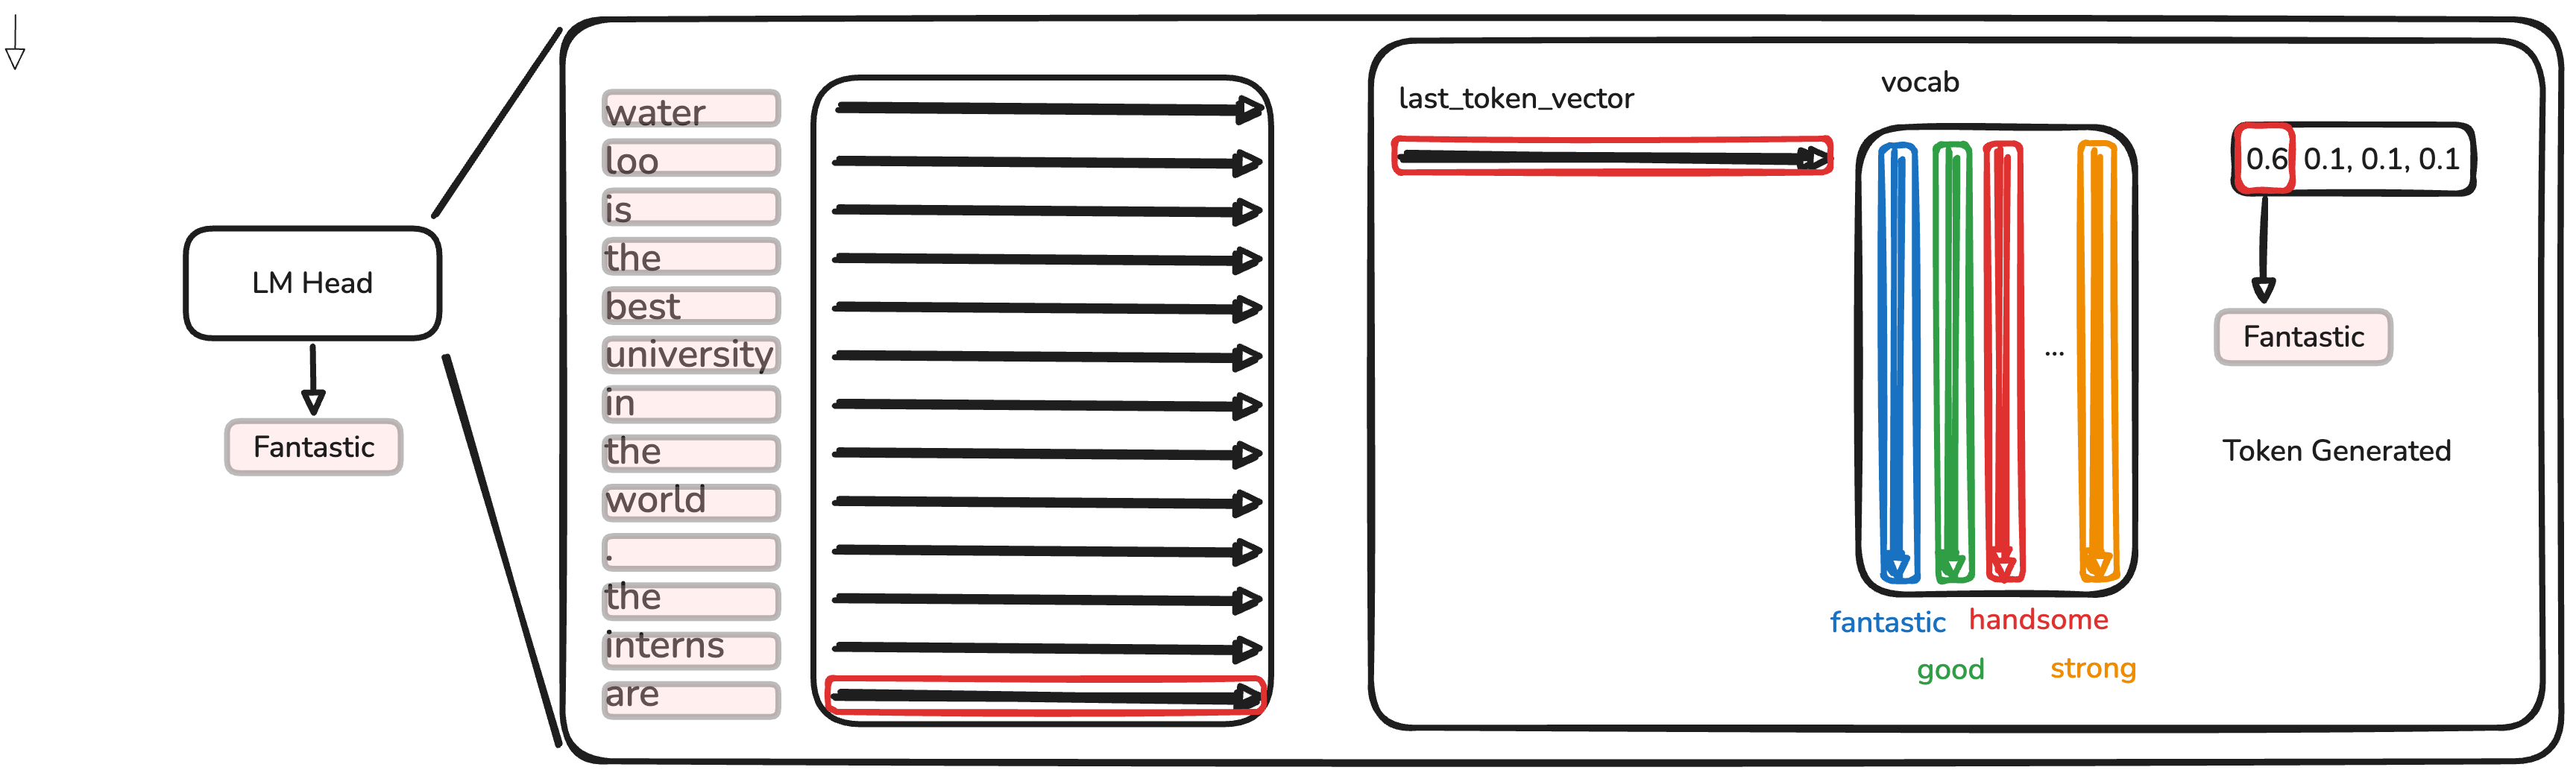
KV cache 来自一个直接的观察:把生成出的 token 接到输入后面时,如果没有缓存,模型就必须重新计算此前所有 token 的投影。保存它们的 key 和 value 向量,可以避免这部分重复工作。
这个存储结构就是 KV cache。它保存前 N-1 个 token 的向量,规模足够大时会成为内存带宽瓶颈。
以大约 50k 个候选 token、12 个 block、12 个 head 和 768 的 embedding dimension 计算,我们的基线模型约有 1.24 亿个参数。
vocab_size: int = 50304 # GPT-2 vocab_size of 50257, padded up to nearest multiple of 64 for efficiency
n_layer: int = 12
n_head: int = 12
n_embd: int = 768
一个拥有 2.8 万亿参数的 KimiK3,包含的参数量大致相当于 22,580 个 GPT-2。
线性注意力
Softmax attention 在 q·k 乘积之后施加非线性,把每个 query 与每个 key 耦合起来。线性注意力则分别对 q 和 k 应用 feature map(例如 ELU+1)。这样乘法可以重新结合,持续增长的 K、V 向量集合就能折叠成固定大小的 D×D 状态。
论文中关于 O(N²) 的说法一度让我困惑。所谓“Transformer 的每个时间步成本随当前序列长度的平方增长”并不准确——FlashAttention 解决的正是这件事……然后我发现它直到 2020 年才发布。
当时的训练通常会把完整的 N×N 注意力矩阵物化出来,FlashAttention 还不存在;而参考实现中的自回归生成往往也会在没有 KV cache 的情况下重新计算 token 历史。
def forward(self, x, mask=None, past_kv=None):
# x is b,t,d
b,t,d=x.shape
d_head=d//self.num_heads
h=self.num_heads
qkv=self.qkv_proj(x)

q=qkv[:, :, :d].view(b,t,h,d_head).transpose(1,2)
k=qkv[:, :, d:2*d].view(b,t,h,d_head).transpose(1,2)
v=qkv[:, :, 2*d:].view(b,t,h,d_head).transpose(1,2)

# at prefill, q,k,v have shapes b,h,t,d
# at decode, shape is b, h, 1, d
# so i cat at the t dimension, dim(2)

if past_kv is not None:
k_past=past_kv[0]
v_past=past_kv[1]
k=torch.cat((k_past, k), dim=2)
v=torch.cat((v_past, v), dim=2)

scores=(q@k.transpose(-1,-2))/math.sqrt(d_head)
if past_kv is None: #we're in prefill and need to mask
causal_mask=torch.ones(t,t,dtype=bool, device=q.device)
causal_mask=torch.triu(causal_mask, diagonal=1)
scores=scores.masked_fill(causal_mask, float('-inf'))

if mask is not None:
scores=scores.masked_fill(~mask, float('-inf'))

#get attn (bhtt x bhtd)
attn=scores.softmax(-1)#bhtt
o=attn@v #bhtd
o=o.transpose(1,2).contiguous().view(b,t,d)  #b,t,d

# use x to get qkv
o_proj=self.o_proj(o)
past_kv=(k, v)
return o_proj, past_kv
同一个过程用图来观察更直观。每个解码步骤都会从 HBM 读取两次 ND 数据并写入两次 1D 数据,而 KV cache 会随序列长度线性增长,即 O(N)。
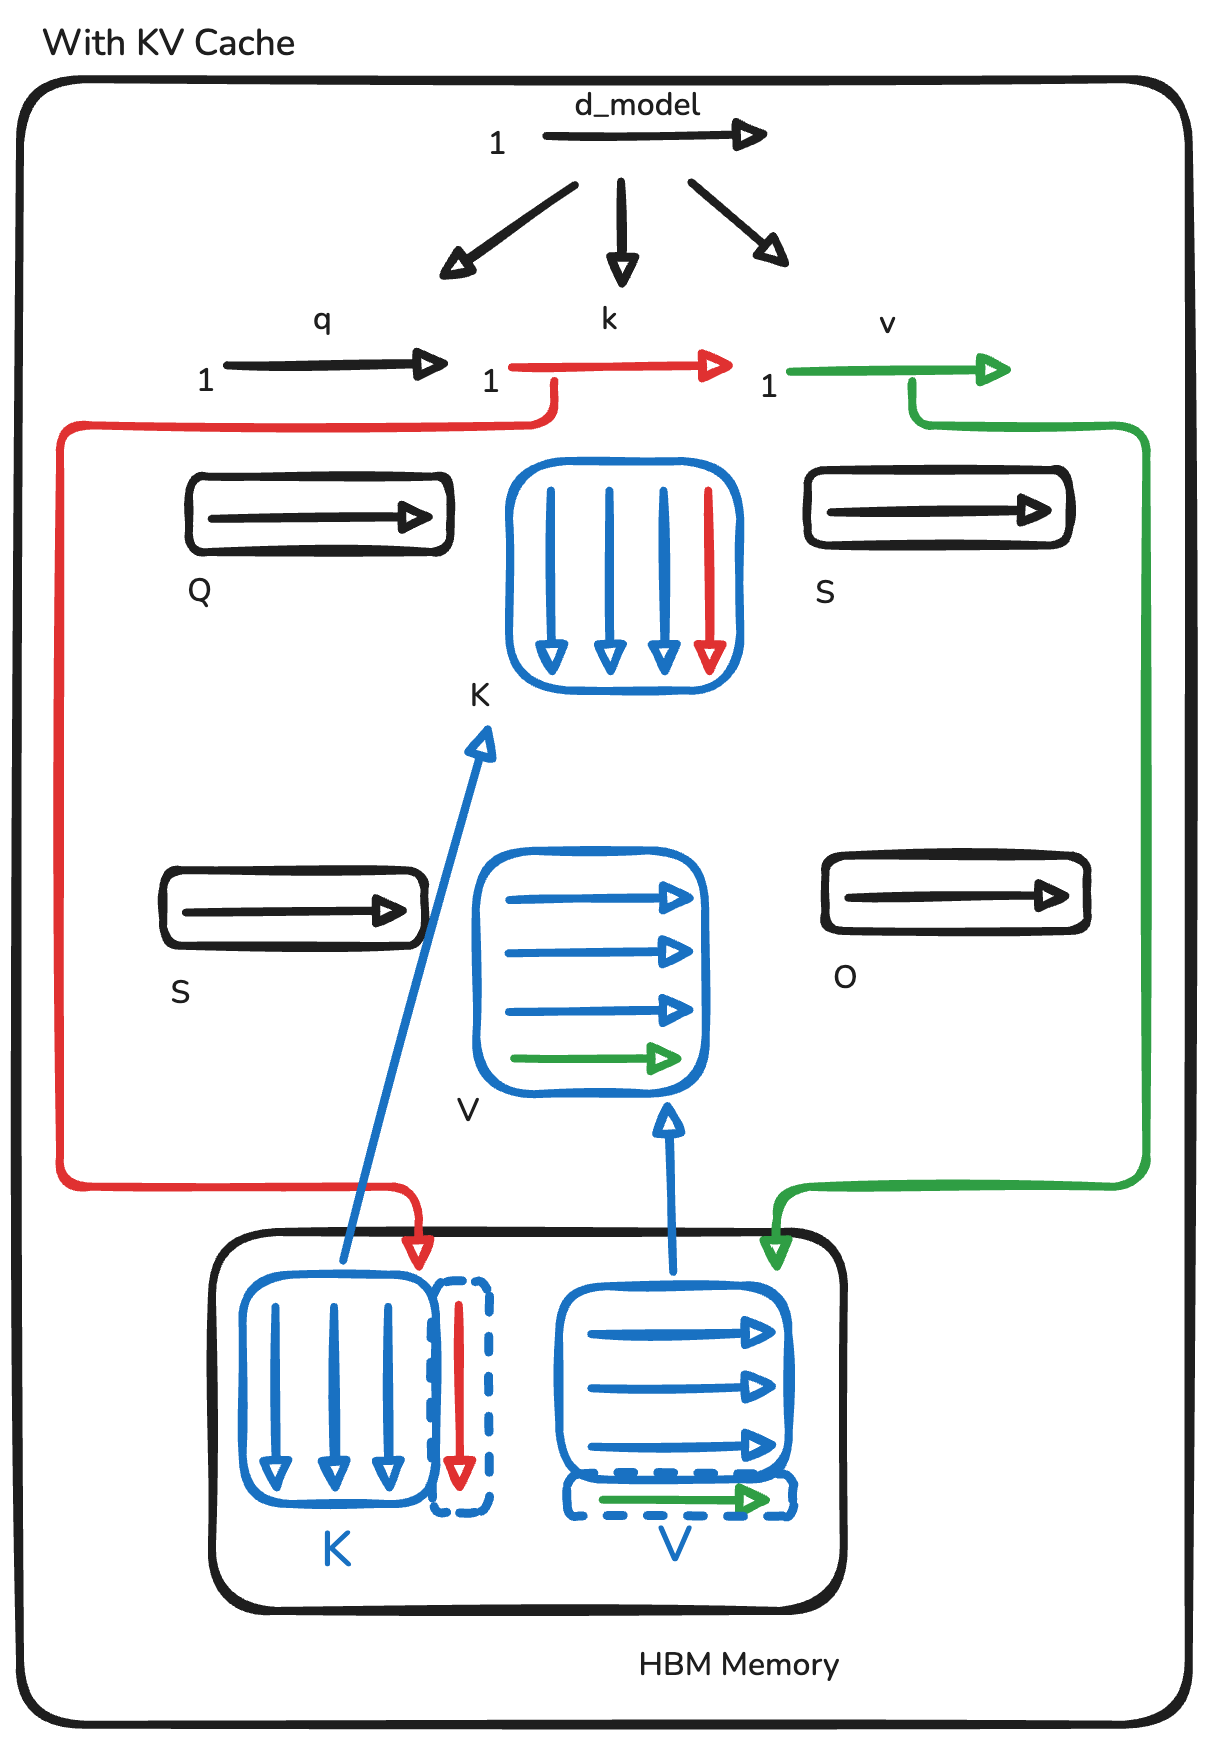
注意这里过多的读写,这正是论文试图替换掉的部分:
def forward(self, x, mask=None, cache=None):
# x is b,t,d
b,t,d=x.shape
d_head=d//self.num_heads
h=self.num_heads
qkv=self.qkv_proj(x)

q=qkv[:, :, :d].view(b,t,h,d_head).transpose(1,2)
k=qkv[:, :, d:2*d].view(b,t,h,d_head).transpose(1,2)
v=qkv[:, :, 2*d:].view(b,t,h,d_head).transpose(1,2)

k=F.elu(k)+1
k=k.transpose(-1,-2)
q=F.elu(q)+1

S,z=cache if cache is not None else (0.0, 0.0)
S=S+k@v
z=z+k

o=q@S #bhtd
denom=q@z
o_scaled=o/denom
o_scaled=o_scaled.transpose(1,2).contiguous().view(b,t,d)
o_proj=self.o_proj(o_scaled)
cache=(S,z)

return o_proj, cache
这里存在一个取舍。
我们把 softmax 使用的指数函数替换为分别作用于 q、k 的 ELU+1。两种方法都会对结果分数做归一化,但线性注意力使用的 feature map 是 softmax kernel 的一种表达力更弱的近似。这种近似可能降低保真度,不过实际精度损失取决于架构和工作负载。
注意,我们仍然会除以 qk 之和,只是为了简化图示而省略了这一步。从高层看,注意力包含三个步骤:
- 让 qk 分数变为非负。线性注意力使用 ELU+1,而 softmax 使用指数函数。
- 除以总和。
- 计算 value 的加权平均。
这保留了注意力的基本契约,但使用表达力较弱的 feature map,使 QK 分数变为非负。
DeltaNet(快速权重程序)
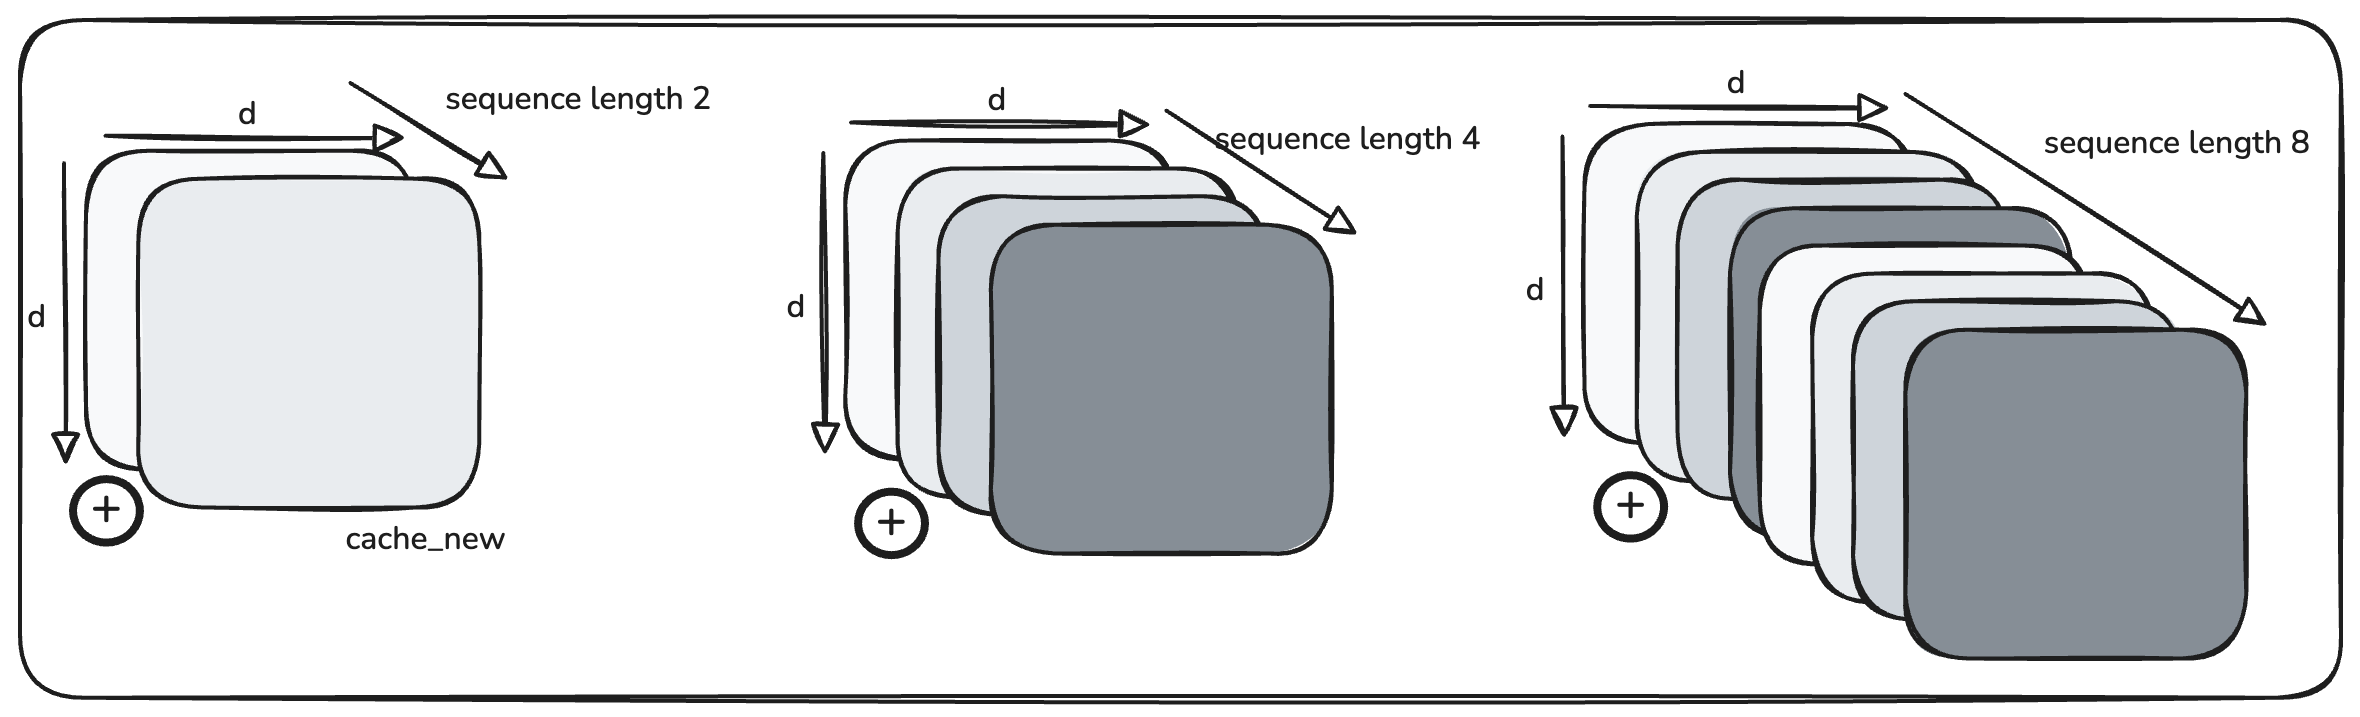
有限缓存必须覆盖或合并已经存储的信息。token i-1 的状态不会得到一个独立槽位;它会被加到同一个 D×D 矩阵中。因此,新的 query 再也无法取回每个早期 token 完全隔离的表示。
这种相加也正是效率提升的来源。用加法更新缓存,而不是拼接缓存,可以阻止它按 O(N) 增长;但同一操作也会造成信息干扰。DeltaNet 正是为了解决这种可恢复性损失。
Schlag 在《Fast Weight Programmers》论文中有一句很贴切的话:“当序列长度超过存储容量时,模型可能进入超容量状态。要在这种状态下正常工作,模型应当学会动态地与记忆内容交互,有选择地决定保留哪些 key-value 关联、删除哪些关联。纯粹的加法指令可能并不适合这个目的……在有限容量的记忆中不断添加新的关联,如公式 17 所示,最终必然会触及上限。”
线性注意力之所以有吸引力,恰恰是因为 N 远大于 D;但这也暴露了它的主要局限。一旦状态超过有效容量,关联就会开始互相干扰,因为更新是加法式的,而且没有任何内容离开缓存。
def forward(self, x, mask=None, cache=None):
# x is b,t,d
b,t,d=x.shape
d_head=d//self.num_heads
h=self.num_heads
qkv=self.qkv_proj(x)

q=qkv[:, :, :d].view(b,t,h,d_head).transpose(1,2)
k=qkv[:, :, d:2*d].view(b,t,h,d_head).transpose(1,2)
v=qkv[:, :, 2*d:].view(b,t,h,d_head).transpose(1,2)

q = F.normalize(F.silu(q), dim=-1)
k = F.normalize(F.silu(k), dim=-1)
beta = torch.sigmoid(self.w_beta(x)).view(b, 1, t, 1)
# new: per-token write strength

S = cache if cache is not None else 0.0

v_old = k @ S # read the board at this key
u = beta * (v - v_old) # the delta: only what's actually new
S = S + k.transpose(-1, -2) @ u # same outer-product write as before

o = q @ S # read, no denominator
o = o.transpose(1, 2).contiguous().view(b, t, d)
return self.o_proj(o), S
看一个视觉示例会更容易理解。
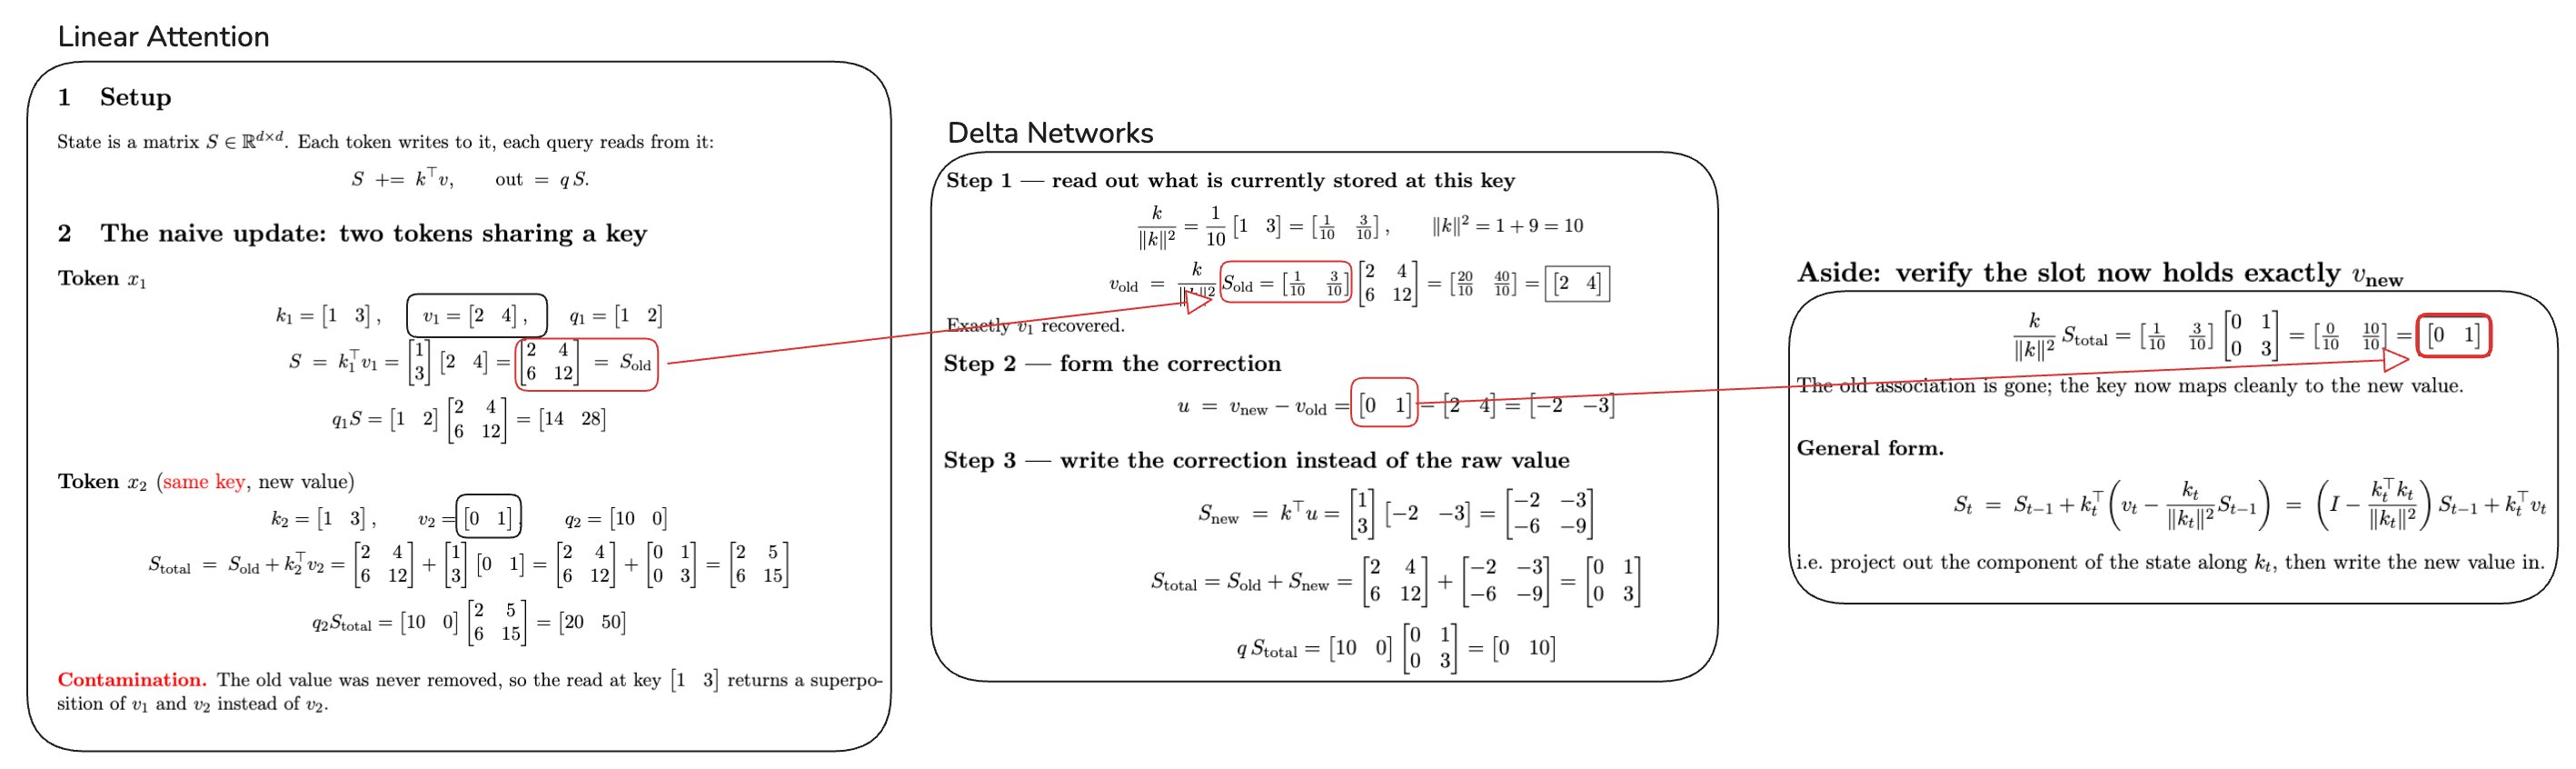
假设写入了一个关联 S = k.T @ v。如果用同一个 key 读取,就会得到 k @ (k.T @ v),也就是 (k @ k.T) v,即 k 的平方范数乘以 v。因此读取结果会按 key 的平方范数缩放;如果把 k 归一化为单位长度,或者除以它的范数,就能准确得到 v。
Q 也可以看作一个学习到的指针。Wq 和 Wk 从同一个 residual stream 中读取信息,而某个事实对应的 query 会指向写入该事实时使用的 key 方向。更新时,模型先询问当前 key 从缓存中取回了什么信息,再从希望写入的 value 中减去已有信息,用差值乘以 key,最后把结果加回去。旧信息被移除,新信息被写入原来的位置。
DeltaNet(使用 Delta Rule 并行化线性 Transformer)
这是本文最难的一节。我花了大约七个小时才建立起可工作的理解,所以会从实现出发构建解释。简而言之,DeltaNet 用带广义 Householder 转移矩阵的一阶线性递推,实现了面向硬件高效线性训练的分块并行前向计算。它把输入和输出拆成多个大小为 C 的 chunk,每个 chunk 的输出由前一个 chunk 的最终状态,以及当前 chunk 的 query、key、value block 共同计算。
实际问题在于 prefill。对长度为 T 的 token 序列直接应用 Delta rule,大致会是这样:
S = torch.zeros(b, h, dh, dh) if cache is None else cache
outs = []
for i in range(t):
k_i = k[:, :, i:i+1]
v_i = v[:, :, i:i+1]
b_i = beta[:, :, i:i+1]
v_old = k_i @ S
u_i  = b_i * (v_i - v_old)
S = S + k_i.transpose(-1, -2) @ u_i # write
outs.append(q[:, :, i:i+1] @ S)
o = torch.cat(outs, dim=2)
与标准注意力不同,这个公式要求在每个 key 向量处进行修正,因此想要直接变成并行矩阵乘法并不明显。即使不使用 Delta rule,直接的线性注意力 prefill 仍然是串行的:
S = torch.zeros(b, h, dh, dh) if cache is None else cache
outs = []
for i in range(t):
q = q[:, :, i:i+1]
k = k[:, :, i:i+1]
v = v[:, :, i:i+1]

S=S_old+k@v
o=q@S #bhtd
o=self.norm(o)
o=o.transpose(1, 2).contiguous().view(b, t, d)

out=self.o_proj(o)
cache=S
outs.append(out)

o = torch.cat(outs, dim=2)
分块公式提供了一种更高效的方法。通过一个例子可以更容易看清其中机制:
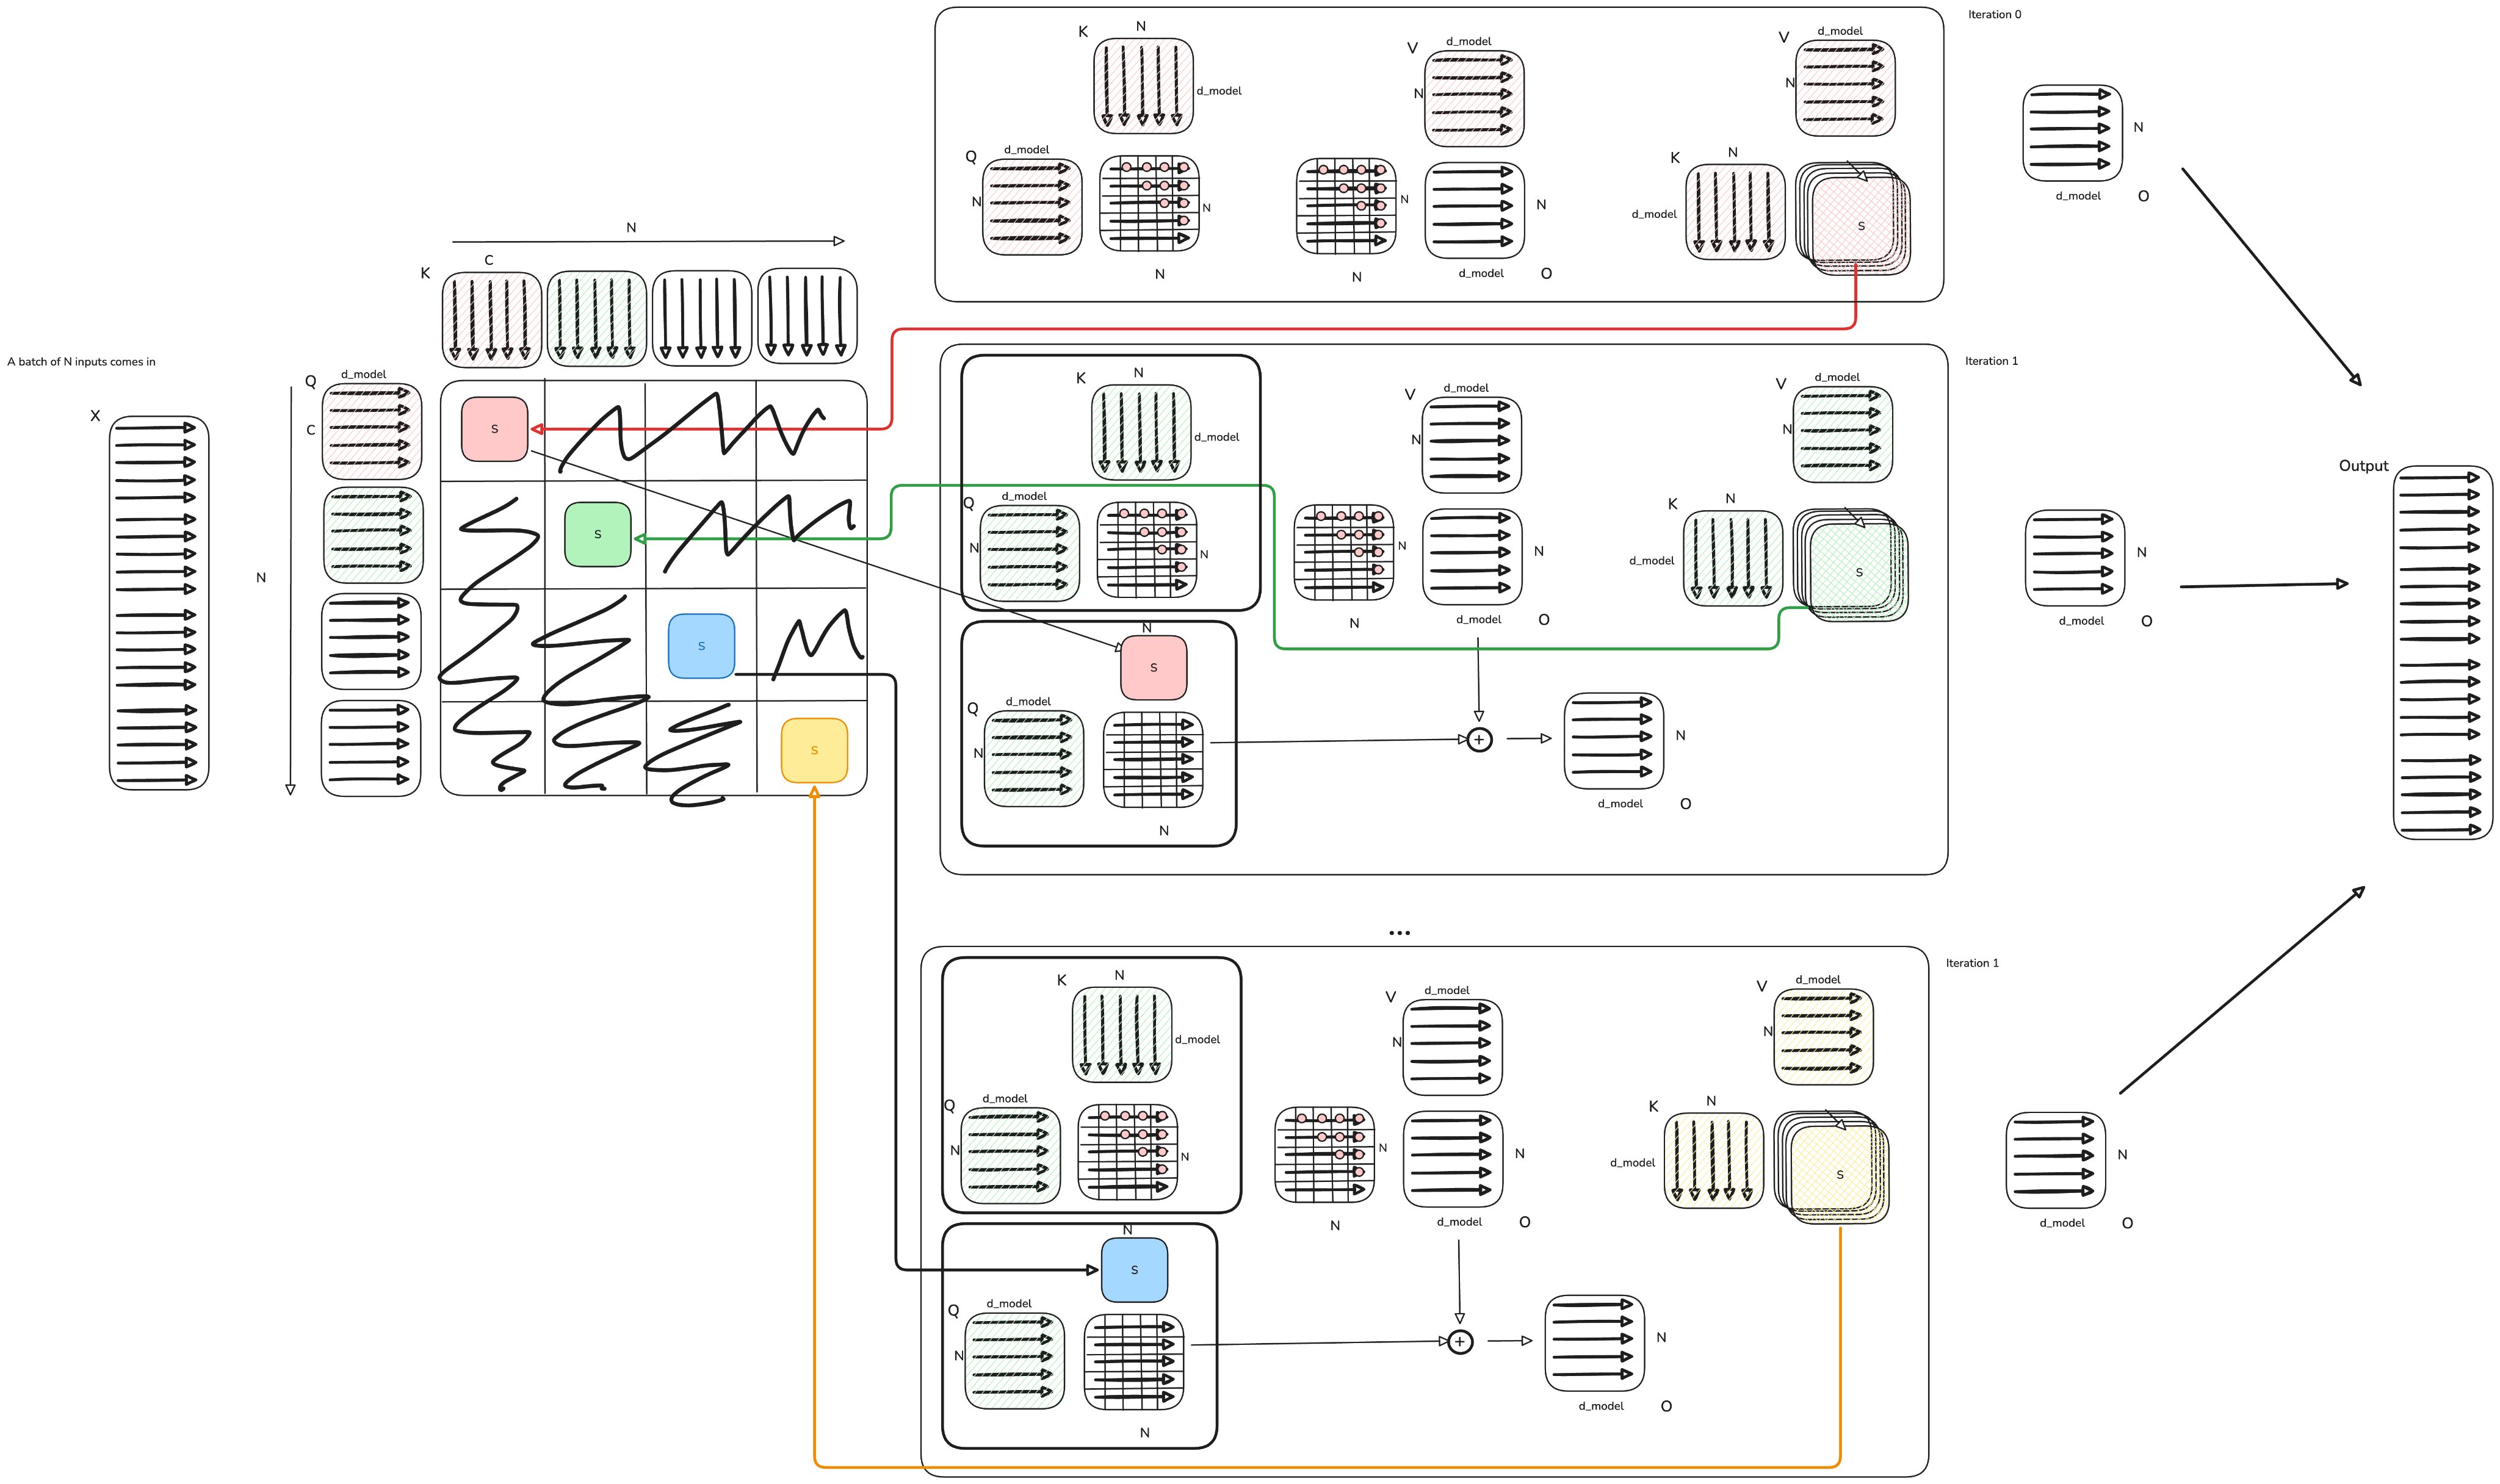
当 C=N 时,能够恢复标准的 O(N²) 注意力;当 C=1 时,则得到普通线性注意力。中间取值是在 chunk 内增加工作量和获得更好的硬件利用率之间进行折中。实际中 C 常取 64 或 128,因为 tensor core 指令在这种粒度上运行得很高效;UMMA 就是一个例子。
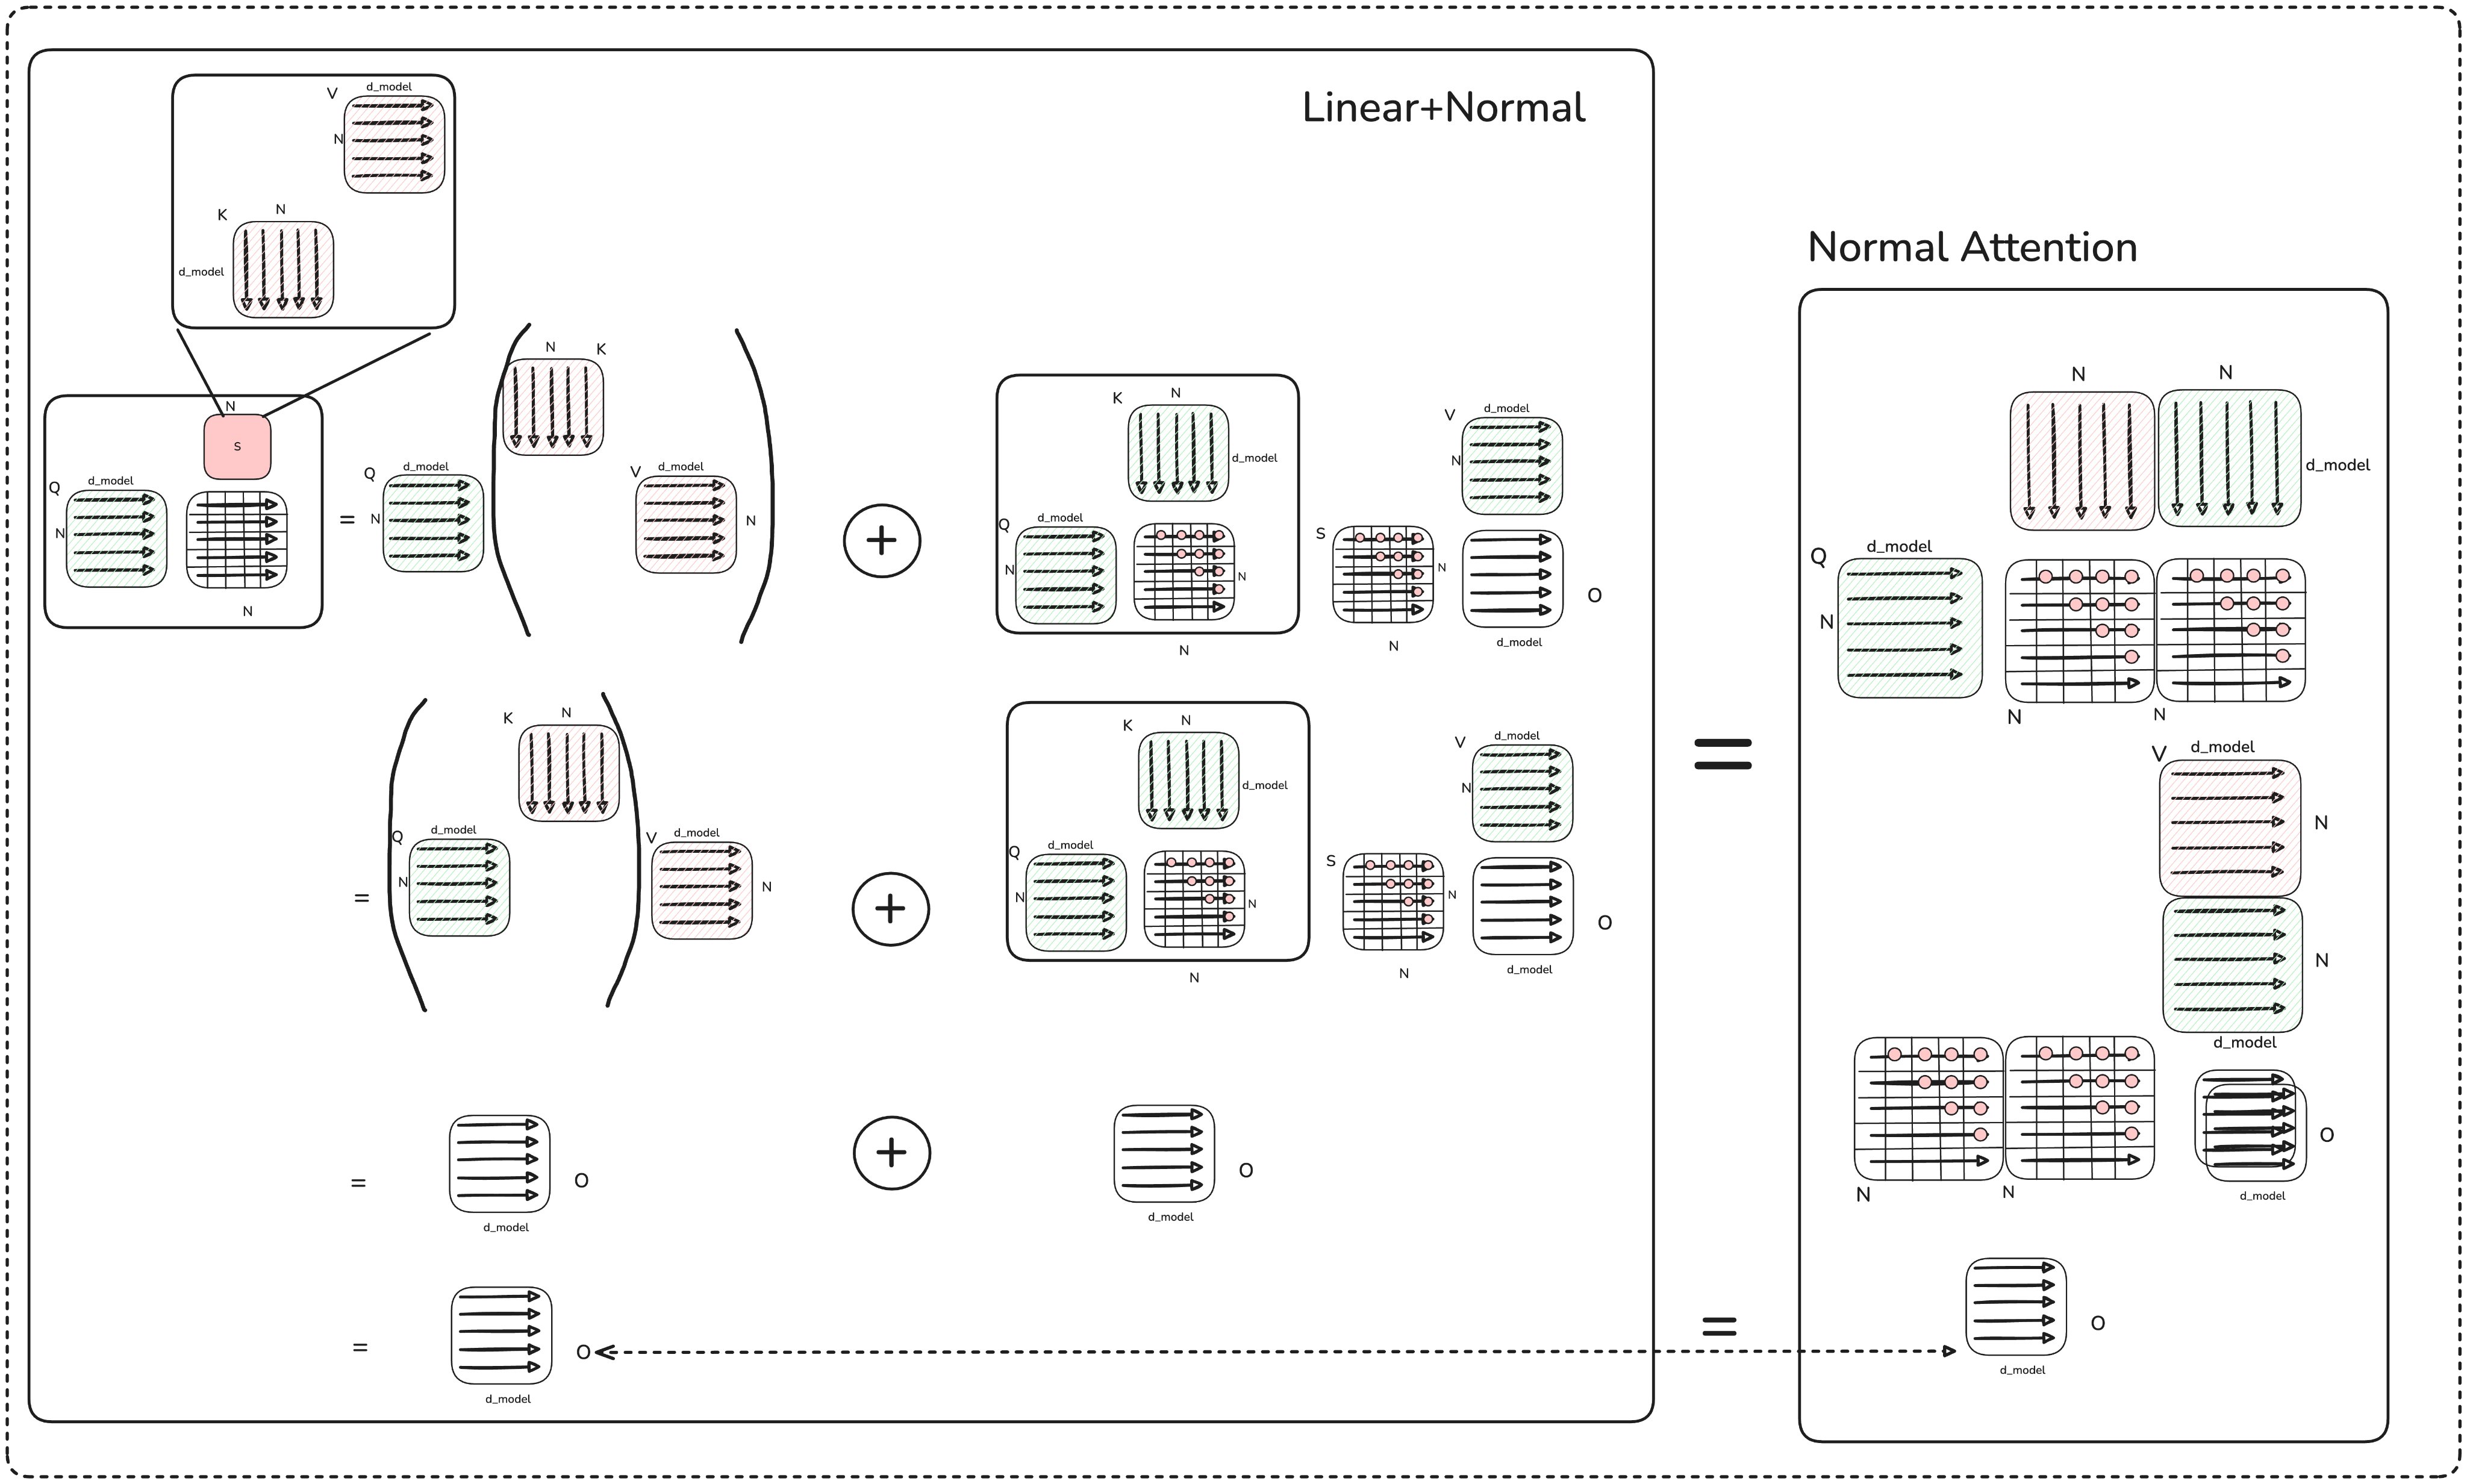
中间 tile 会作为状态更新的一部分折叠进 S:
S = torch.zeros(b, h, dh, dh) if cache is None else cache
outs = []
for i in range(t//C):
q_c = q[:, :, i*C:(i+1)*C]
k_c = k[:, :, i*C:(i+1)*C]
v_c = v[:, :, i*C:(i+1)*C]

o_prev=q_c@S #this is everything up to this block

attn=(q_c@k_c.transpose(-1,-2)).tril() #masked attention
o_curr=attn@v_c

o=o_prev+o_curr

S_new=k_c.transpose(-1,-2)@v_c #recurrent attention
S=S+S_new
outs.append(o)

o = torch.cat(outs, dim=2)
在一个 block 内部,我们计算 q(kᵀv):先算分数,这是带 mask 的标准注意力顺序。在 block 之间,我们计算 (kᵀv)q:先处理状态,这是递归顺序。注意力的增长是 O(N²),而这里不是。在 block 内部,我做真正的注意力(带 mask 的 QKᵀ 乘 V);在 block 之间,我把所有内容折叠进状态,再用一次矩阵乘法读回。因此成本分成两部分:固定部分 2Ld² 是状态计算,与 C 无关;增长部分 2LCd 是对角线上那些 score matrix。完整注意力就是 C=L 的情况,这时第二项变成 2L²d,也就是二次复杂度。所以 C 越小,FLOPs 越少。
从纯 FLOP 数来看,C=1 最便宜,但不一定具有最短的实际运行时间。当计算能够高效映射到矩阵乘硬件时,GPU 可以更快地完成更多算术运算。
下一步是把同样的方法扩展到 DeltaNet。
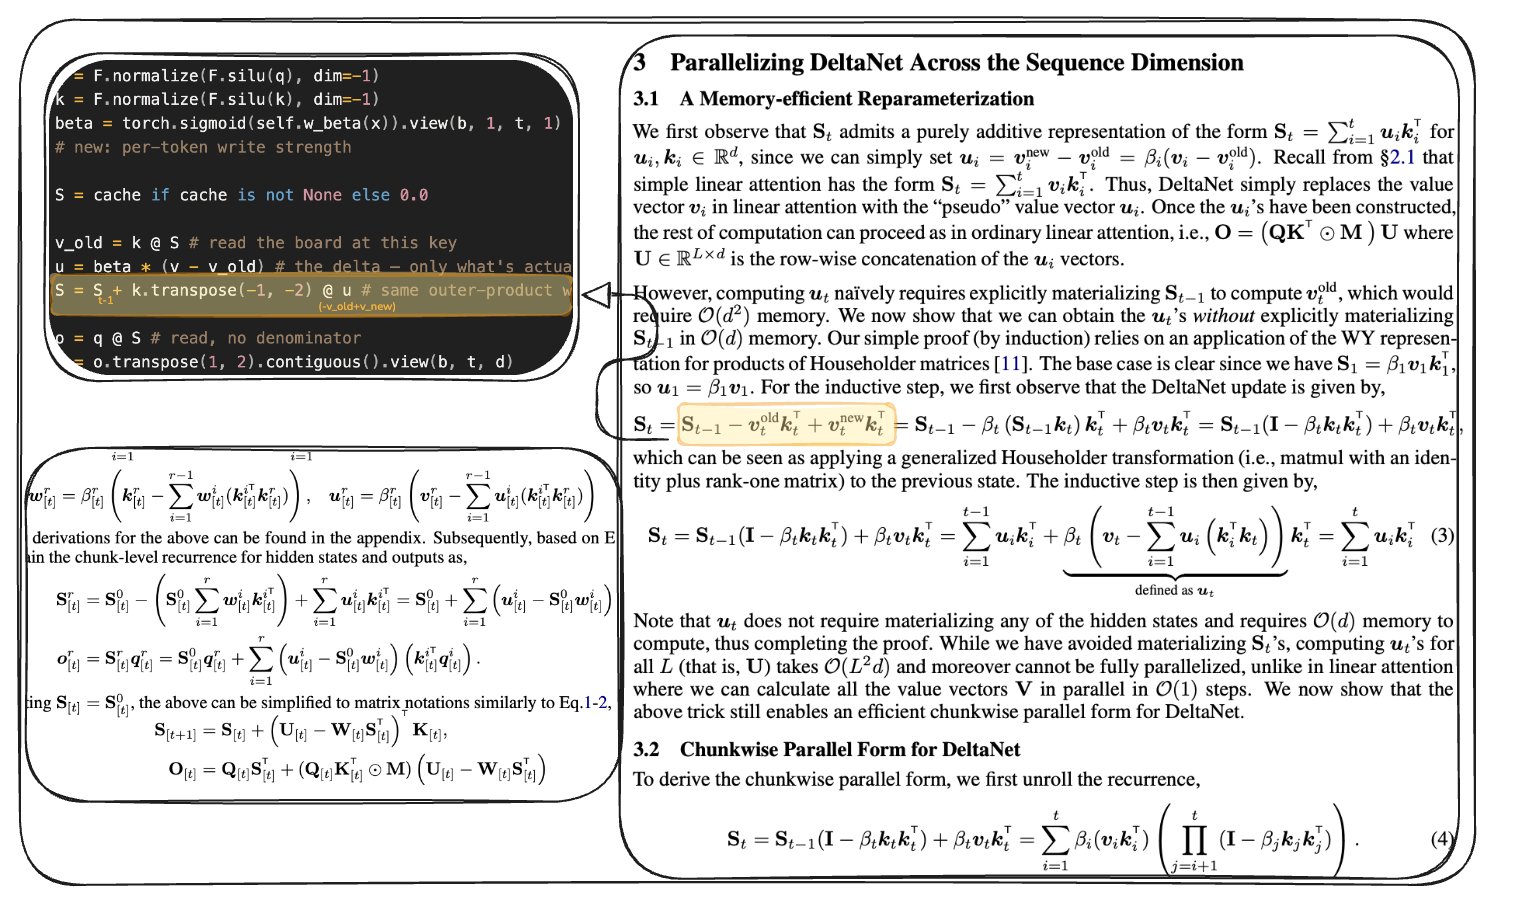
底层问题很简单:纯加法注意力使用的分块方法不能直接应用于 delta 更新:
v_old = k_i @ S
u_i  = b_i * (v_i - v_old)
我们需要每一个状态,才能计算出需要被减掉的信息。没有某种数学上的重新参数化,就不能以同样的方式并行化。因此作者把 delta 更新从下面的形式:
u=v_new-v_old
S_t= S_(t-1)+K.T@u
o=q@S_T
这里的串行循环每次计算一个 delta。重新参数化后的形式是:
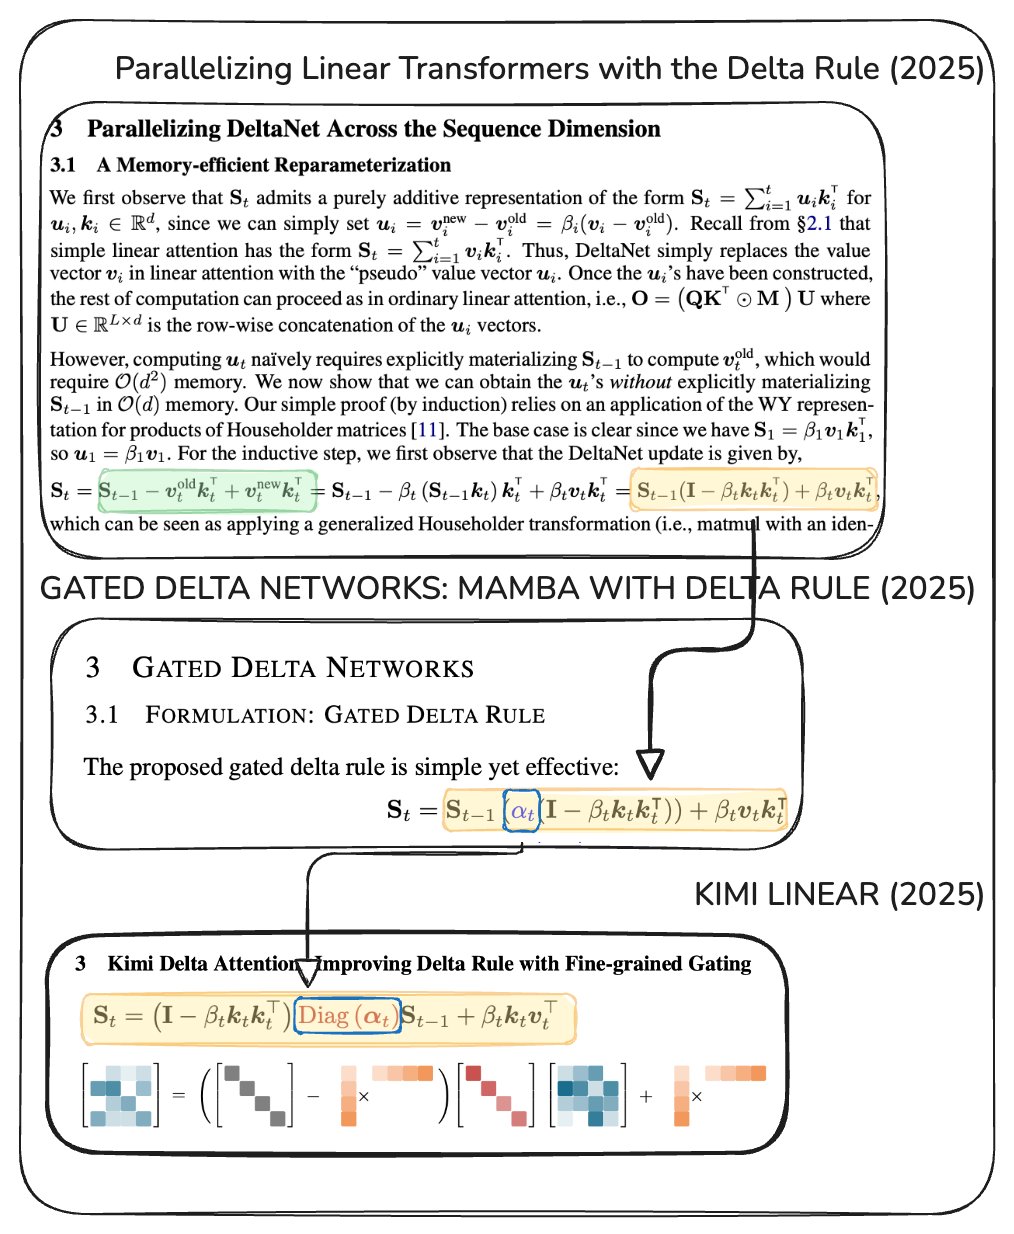
S_t = S_{t-1}(I − β_t k_t k_tᵀ)  +  β_t v_t k_tᵀ
o_t = S_t q_t
这种形式允许 chunked code 一次计算全部 C 个 delta:
def chunk_delta_rule_forward(Q, K, V, beta, C):
# L: sequence length, d: head dimension
L, d = Q.shape
# chunking
Q, K, V = map(lambda x: x.reshape(-1,C,d), [Q, K, V])
beta = beta.reshape(-1, C)
K_beta = K * beta.unsqueeze(-1)
V_beta = V * beta.unsqueeze(-1)

# compute eq. 10 with vectorized forward substitution for fast inverse
T = -(K_beta @ K.t()).tril(-1)
for i in range(1, C):
T[i, :i] = T[i, :i] + (T[i, :, None] * T[:, :i]).sum(-2)

T += torch.eye(C)
W = T @ K_beta
U = T @ V_beta

# chunkwise parallel. Eq. 8-9
S = torch.zeros(d, d)
O = torch.empty_like(V)

for i in range(L//C):
q_i, k_i, w_i = Q[i], K[i], W[i]
u_i = U[i] - w_i @ S # the corrections, all of one chunk
o_inter = q_i @ S
A_i = (q_i @ k_i.t()).tril() #qk.t
o_intra = A_i @ u_i # attention @ v (with corrections, so u)
S += k_i.t() @ u_i # update state with addition
O[i] = o_intra + o_inter #update output with flash + recurrent
return O.reshape(L, d)
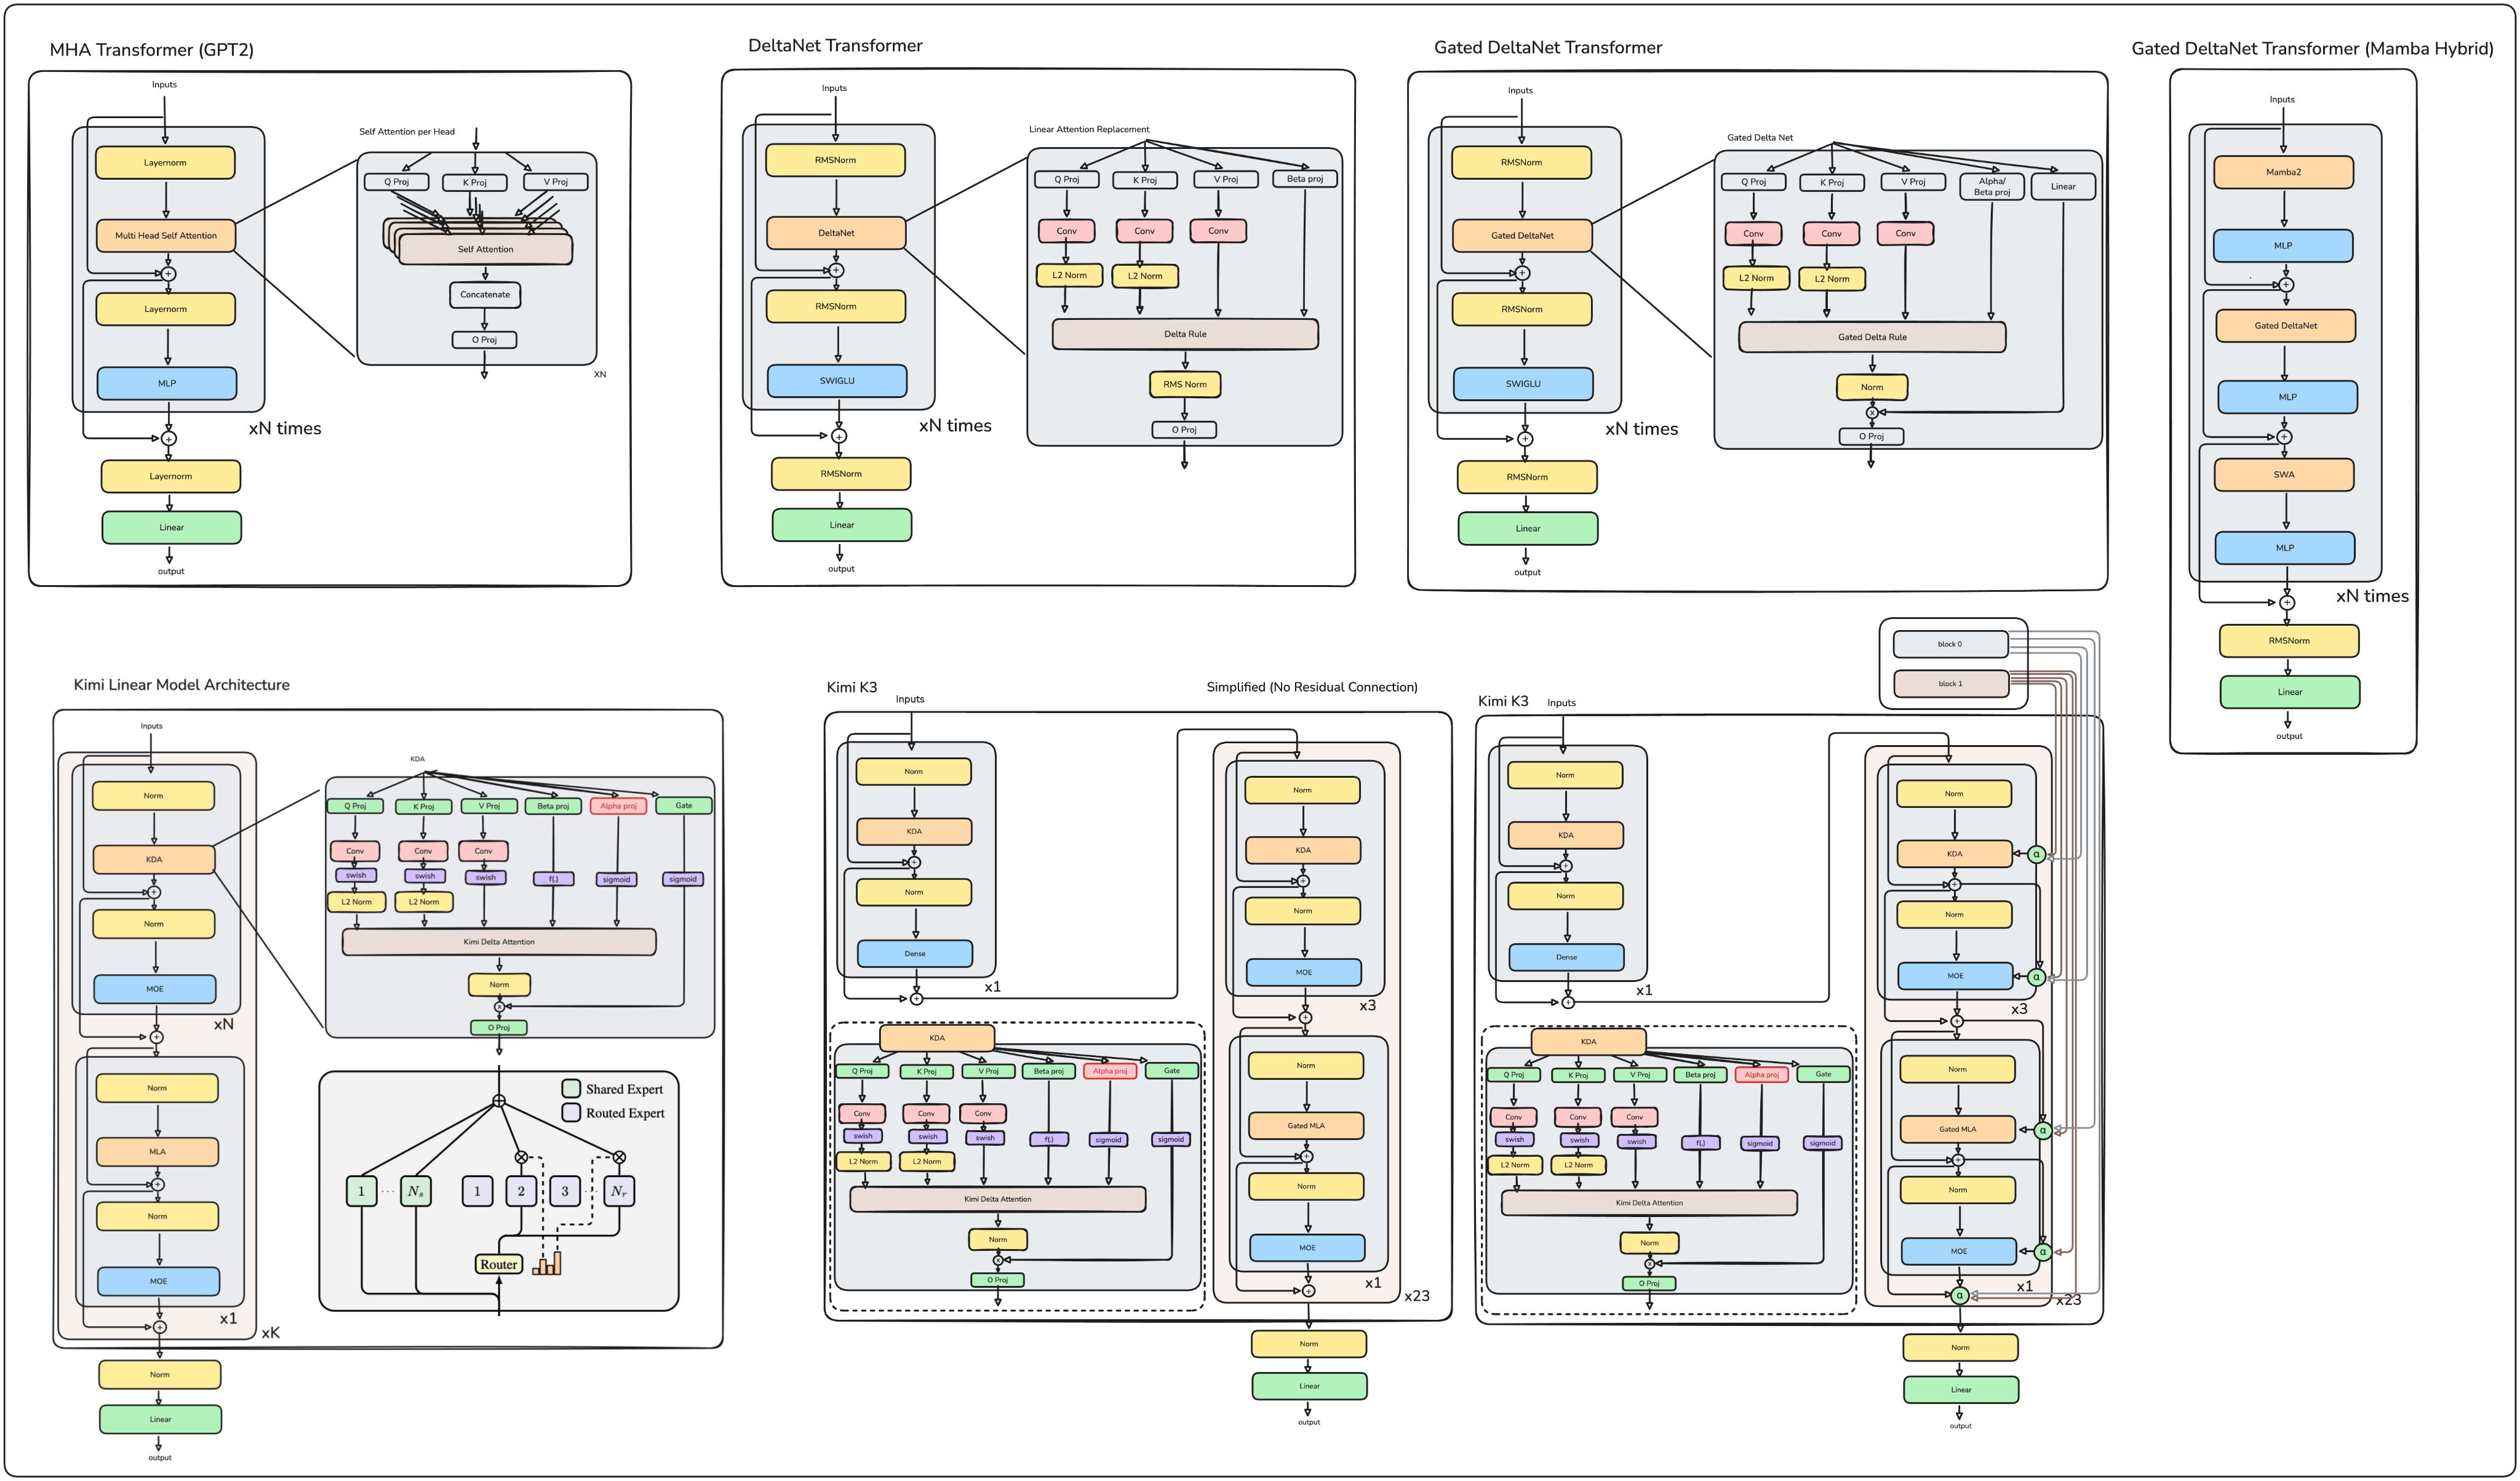
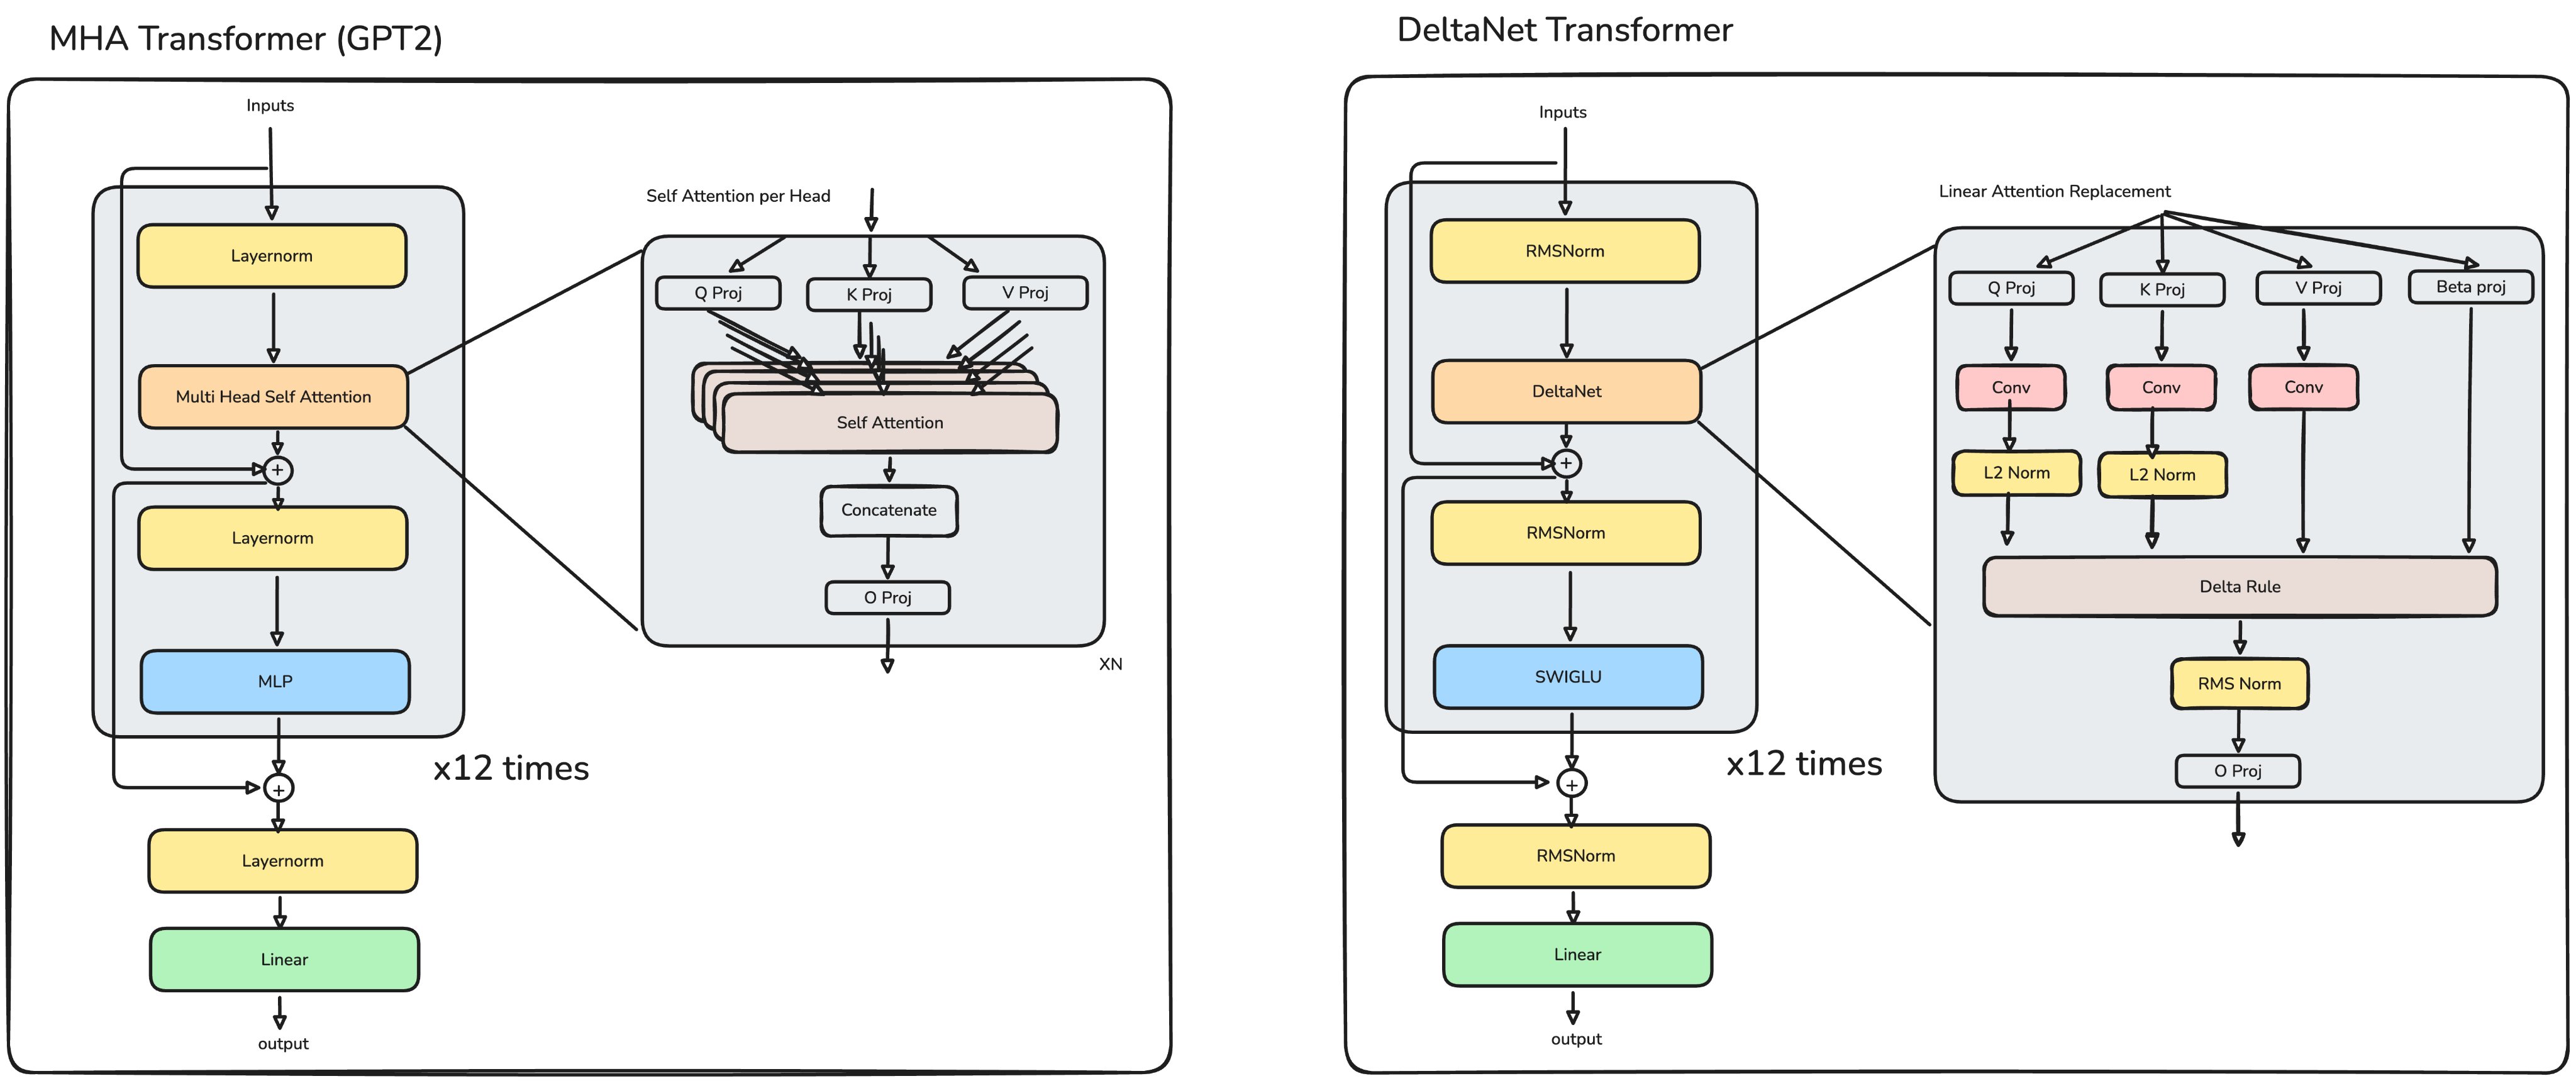
这就得到我们的第一个比较点:MHA 与 DeltaNet Transformer:
门控 Delta Net
现在我们有了一种精确修改缓存的方法。每出现一个新事实(也就是一个新的 key 向量),我们都可以准确查看此处缓存中的旧信息,并用希望模型关注的新信息替换它。
不过,这种机制只能忘掉那些有明确替代内容的关联。它无法在上下文切换时高效清除多个关联,也无法普遍地衰减记忆来释放容量。
如果使用纯加法的线性注意力:
加入遗忘能力很简单,只需要一个控制遗忘状态的参数:
S_old=cache
S_new=k@v
# cache=S_old+S_new
cache=alpha * S_old + S_new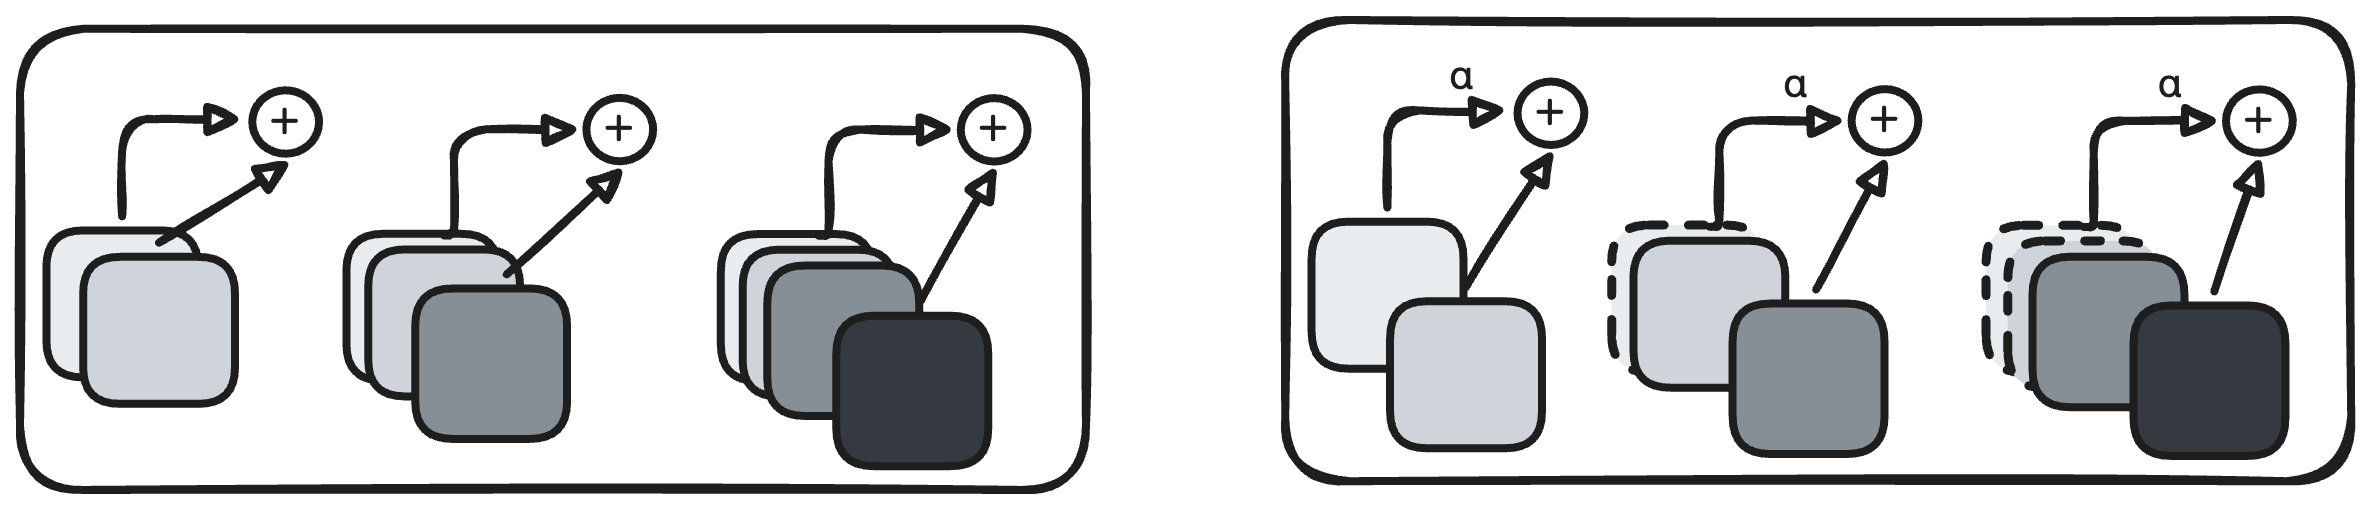
这就是 Mamba-2 的贡献。我们先衰减旧缓存,再以完整强度加入新缓存,避免状态无界增长。
在每个时间步用动态比例统一衰减所有 key-value 关联是一种可行方法,Mamba 就是这么做的。但它没有考虑不同 key-value 关联的重要程度。
也如果模型需要忘掉某一个具体关联,所有关联都会被同样遗忘。相反,Delta rule 可以更新一个事实,却没有办法让其余事实逐渐衰减。
因此,Gated Delta rule 把 Mamba 的门控更新规则与 Delta rule 结合起来。它加入了一个参数 alpha:alpha 为 1 时切换到纯 Delta rule,alpha 为 0 时清空记忆。挑战在于,如何用同样的并行分块方法实现它。
实现仍然使用上一节描述的 DeltaNet 重新参数化。数学形式几乎相同,只增加了一个介于 0 和 1 之间、依赖数据的标量,用来控制旧状态的衰减。这把有效的 key-value 关联学习与自适应的记忆管理结合起来。
相应的代码变化如下:
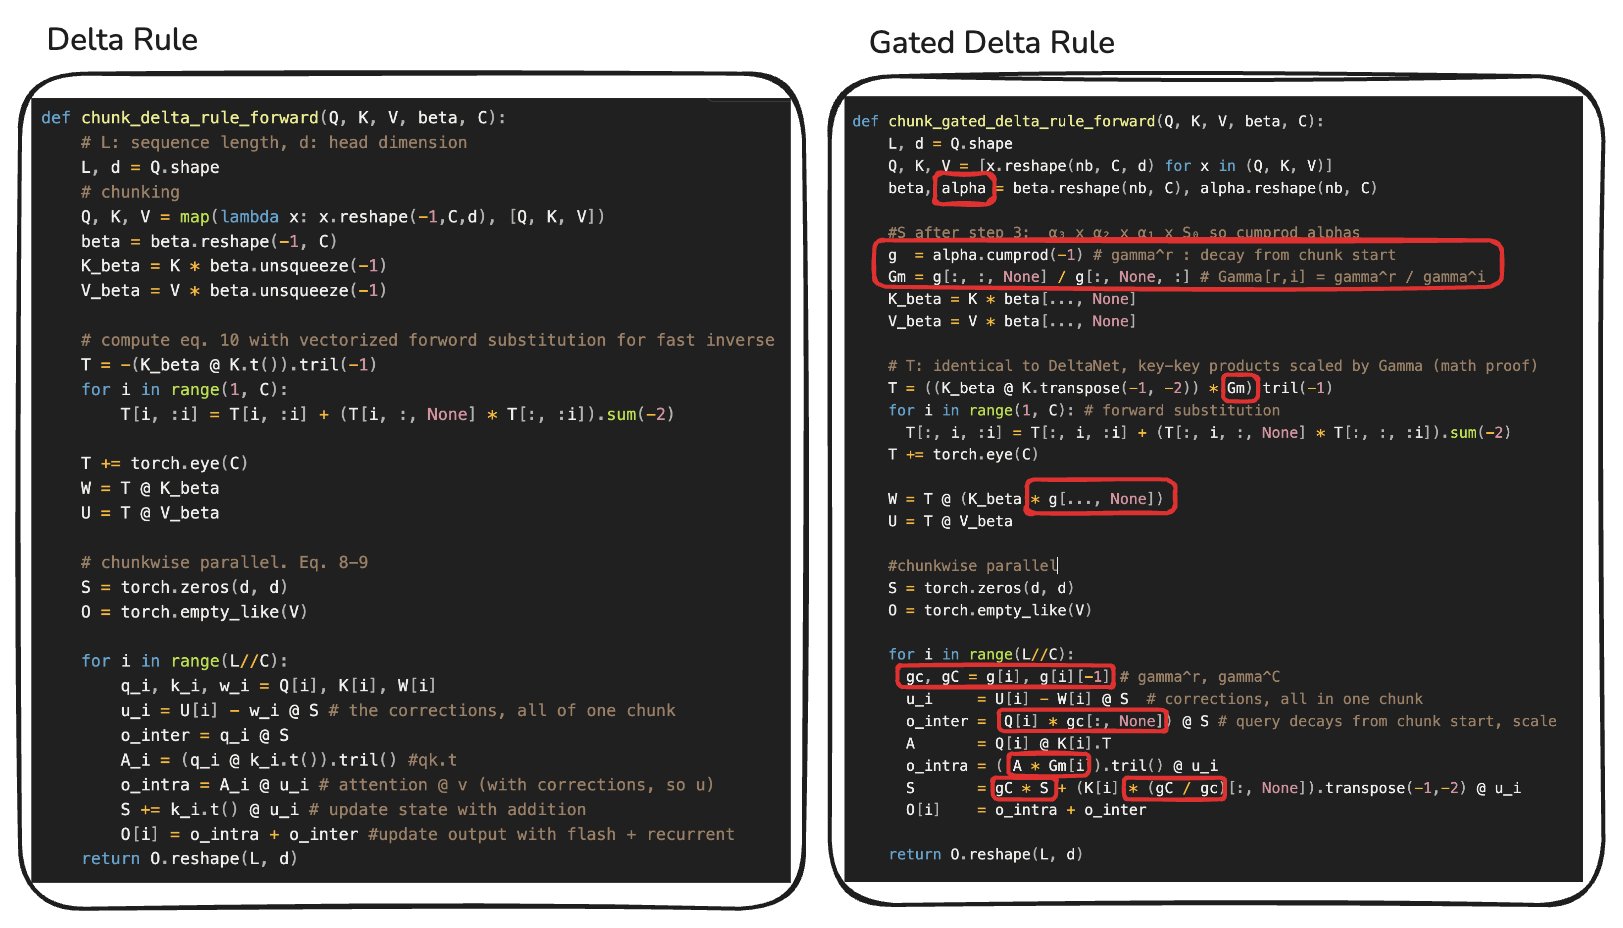
γʳ/γⁱ 项表示累积衰减。一个在时间步 x 写入、在 x+t 读取的 token,会乘上 αₓαₓ₊₁αₓ₊₂…αₓ₊ₜ。这是 prefix-sum 计算的乘法对应物。
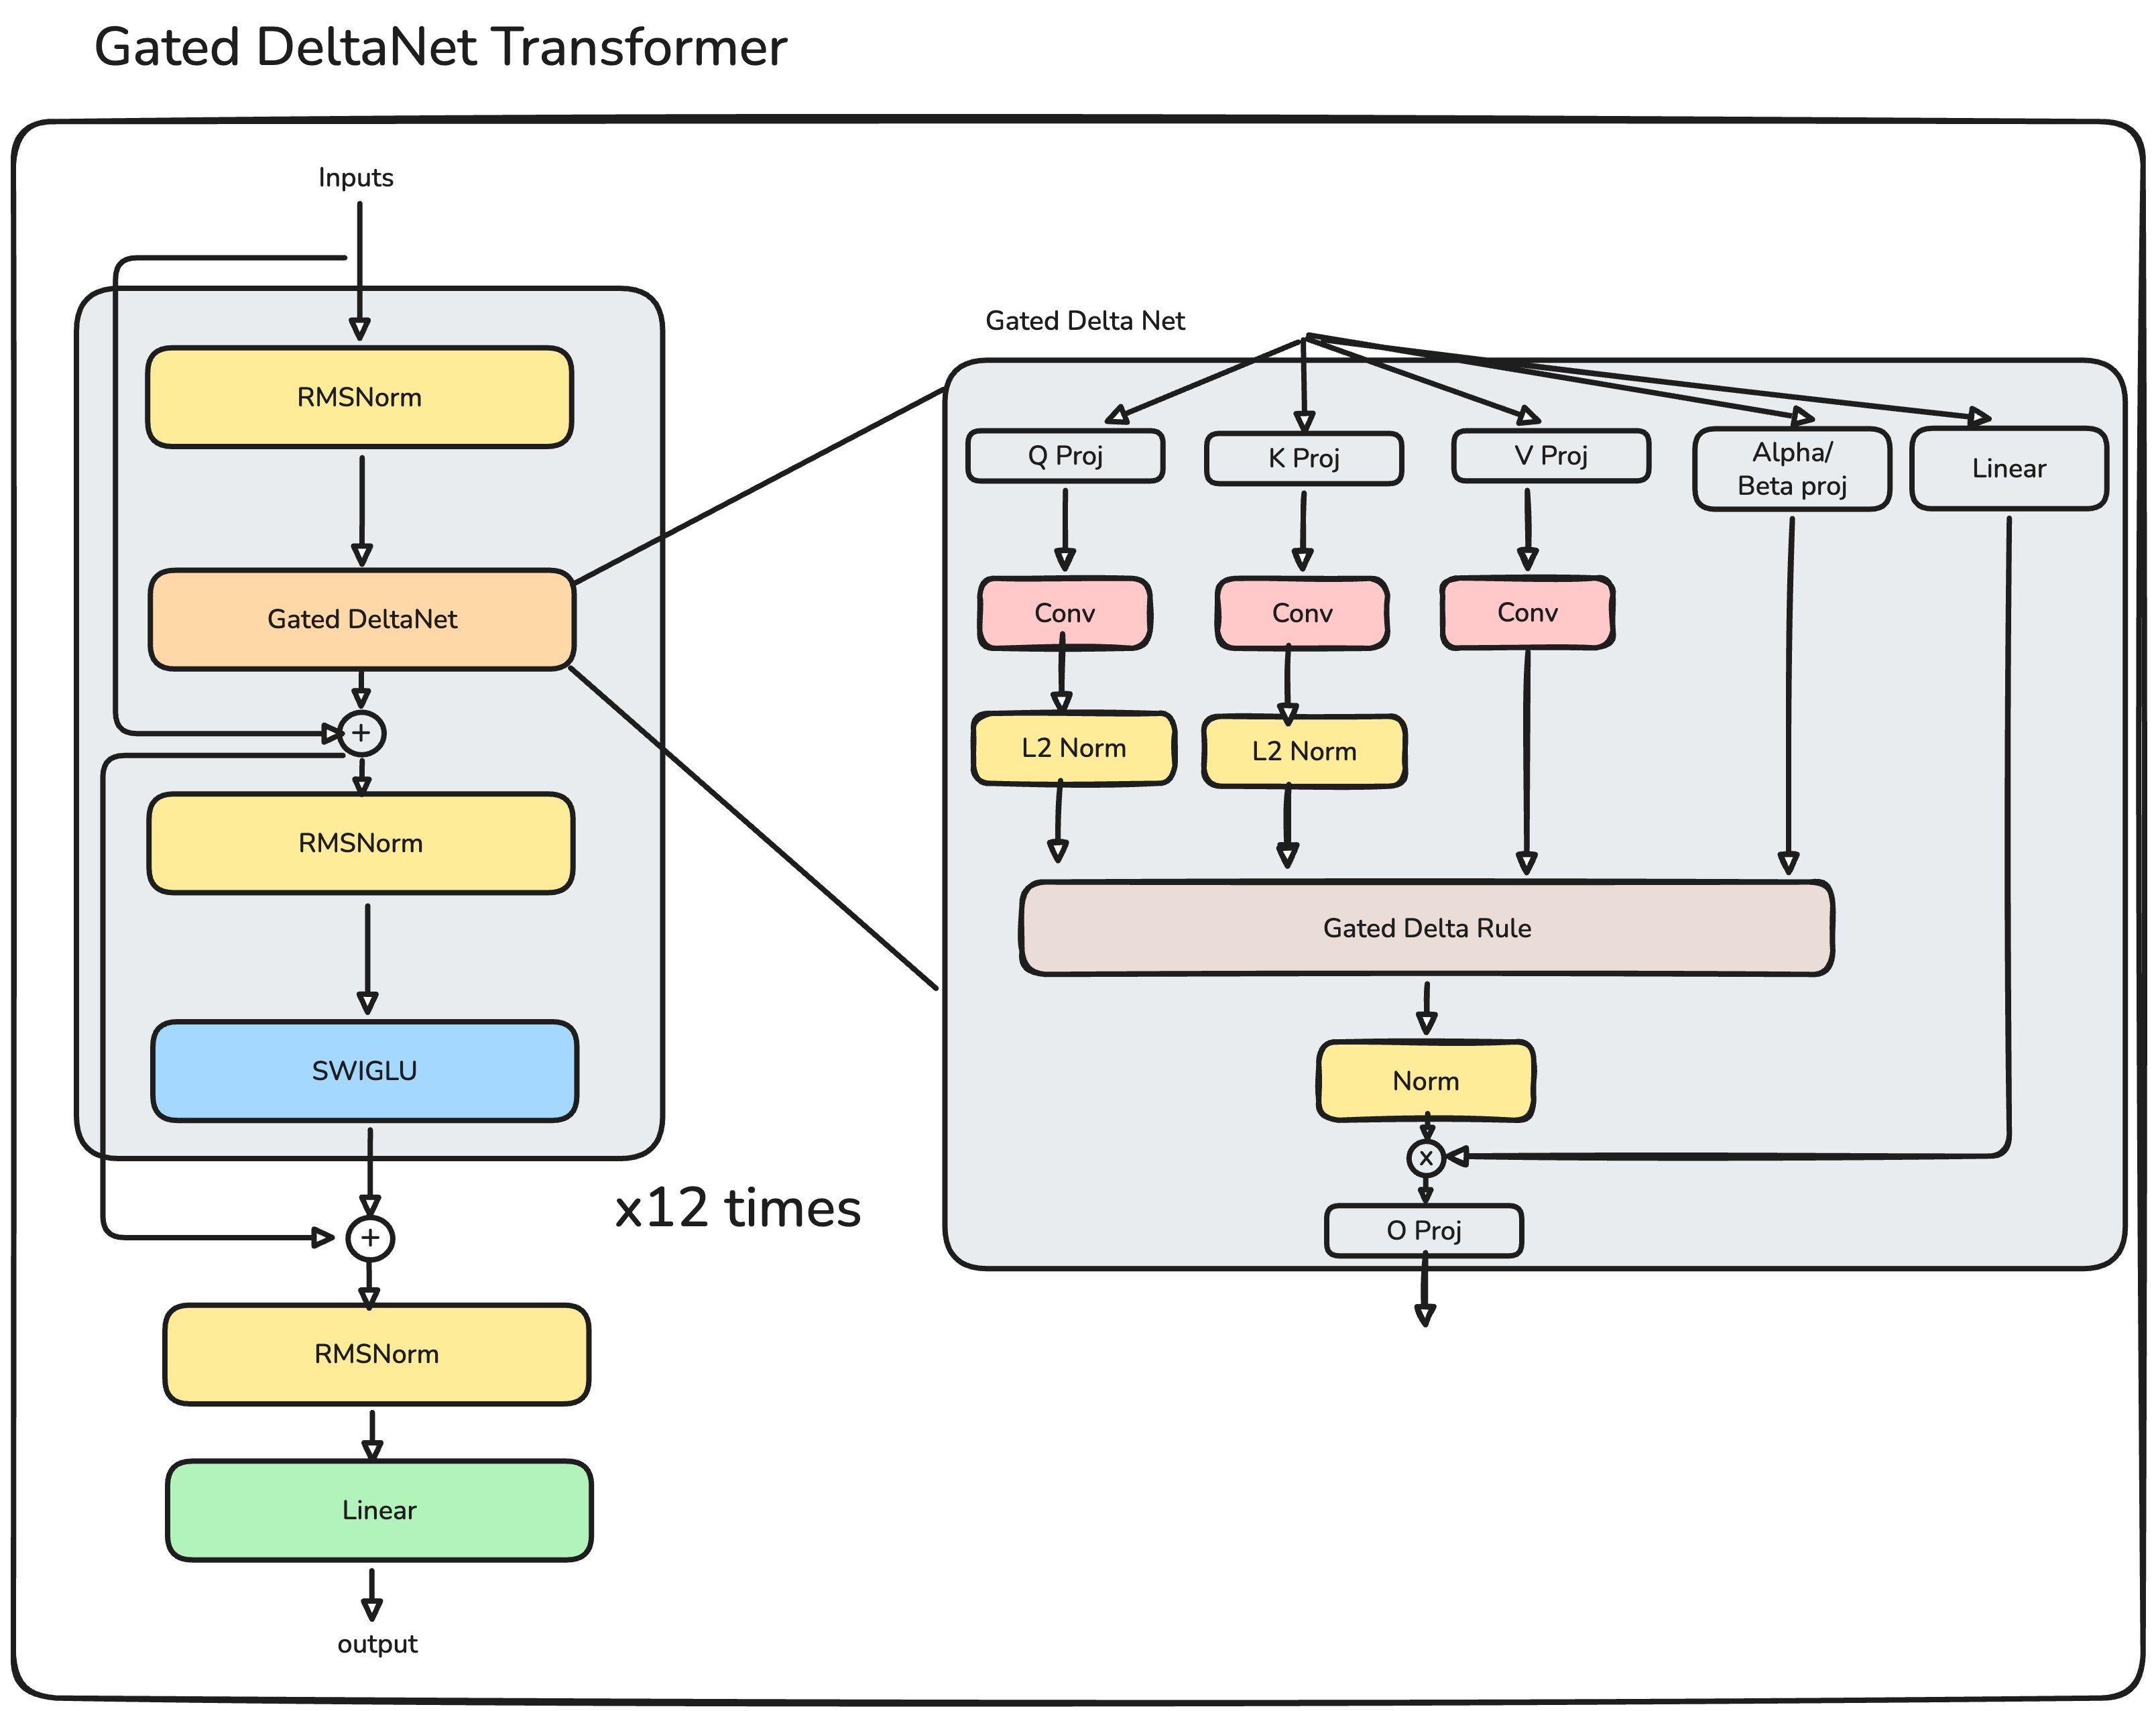
最终的架构如下:
KDA/Kimi Linear
在这个阶段,研究者开始尝试在一个架构中混合多种注意力形式,例如把 Gated DeltaNet 与 Mamba 结合起来。
Kimi Linear 因一个核心主张受到关注:在受控比较中,它超过了完整注意力。作者把它描述为一种可直接替换的架构,质量更好,解码吞吐量最高可提升 6 倍。
Kimi Linear 通过引入细粒度门控改进 Gated DeltaNet。它不再使用单一的标量衰减,而是为每个 channel 学习一个独立的衰减值。
KDA 的更新规则仍然相似,但代码现在更接近下面这样:
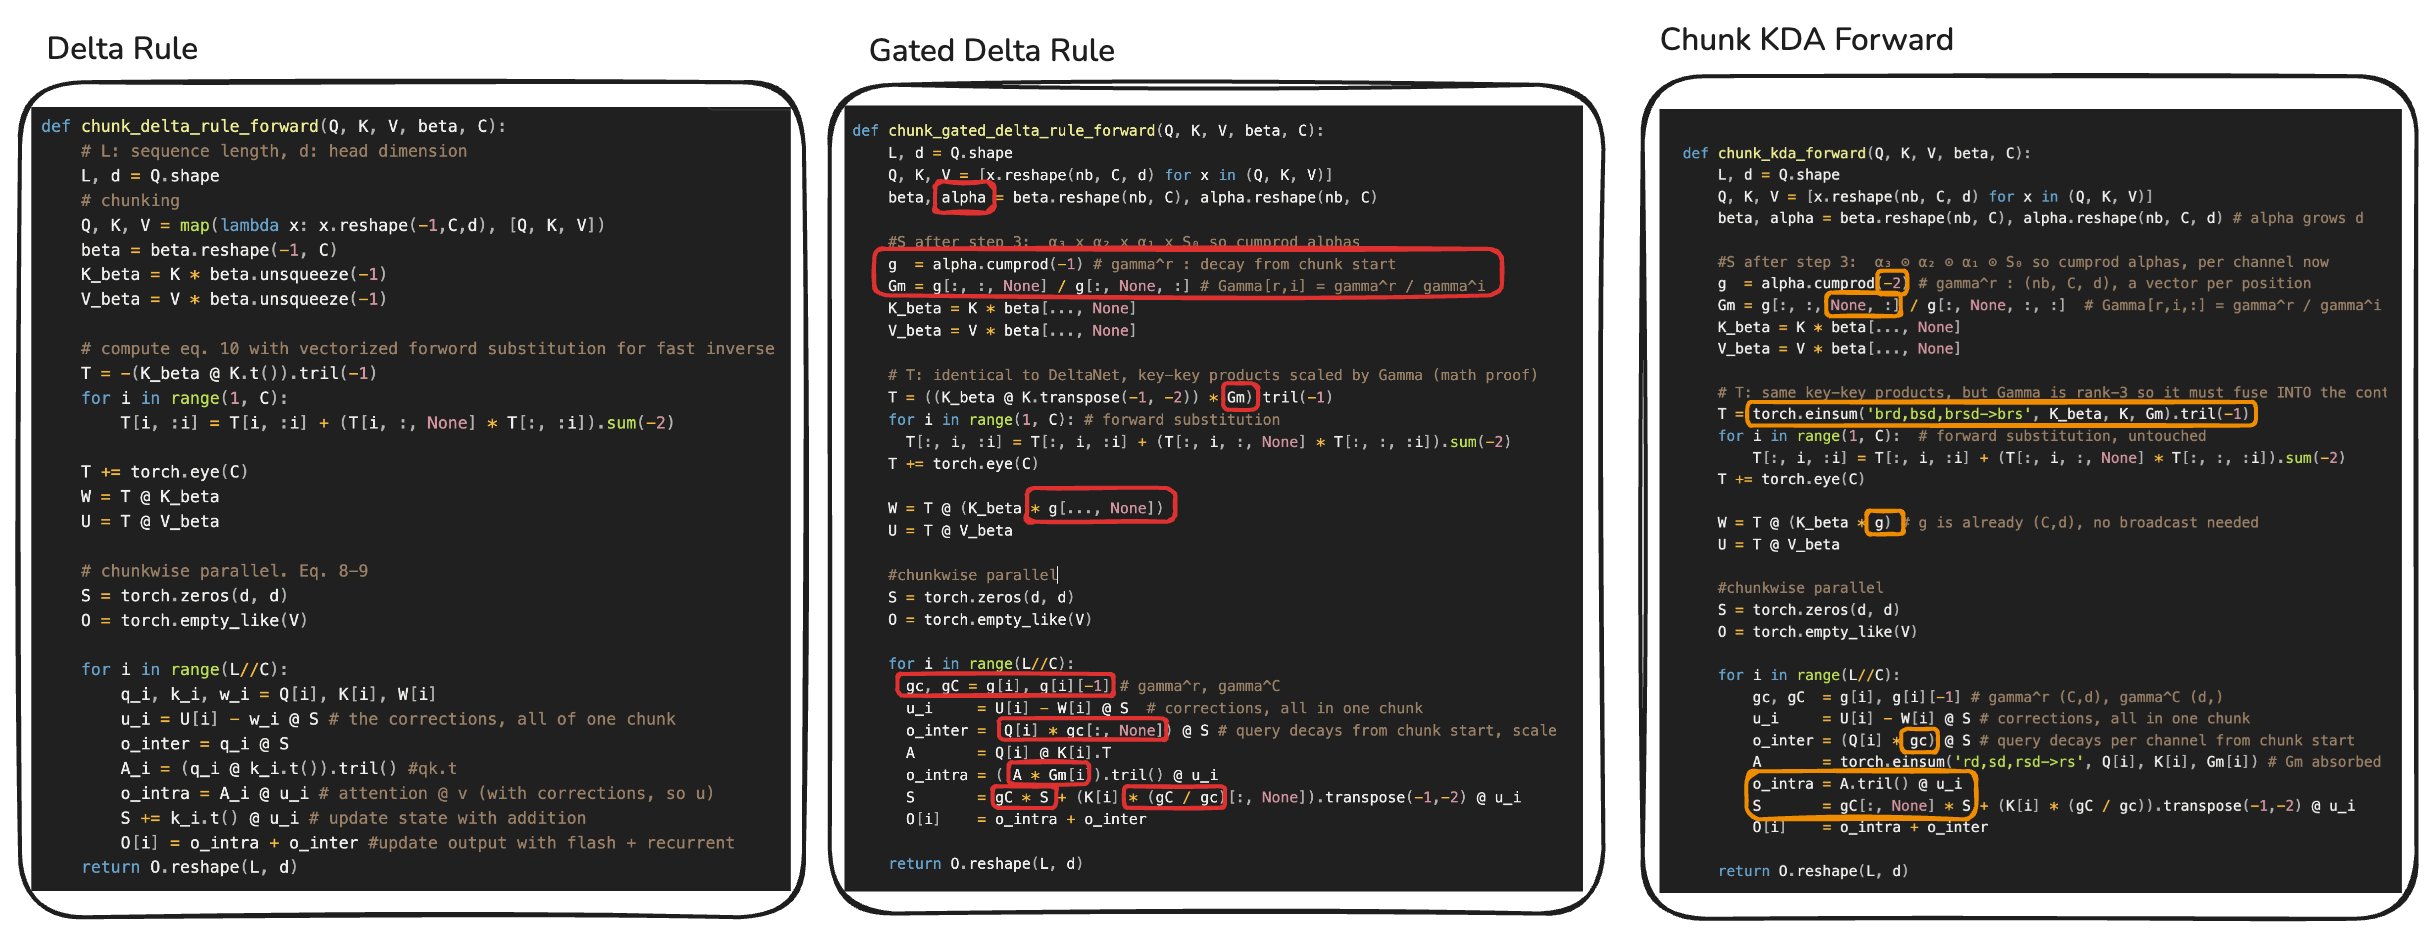
这里的 alpha.reshape(nb, C, d) 体现了论文最重要的贡献:对记忆衰减进行细粒度控制。
把 Kimi Linear 放在 DeltaNet Transformer 旁边比较,可以看到三个主要变化:
- 使用交错排列 Multi-head Latent Attention(MLA)层的混合系统。
- 用 Mixture-of-Experts(MoE)层替换 MLP。
- 通过 alpha projection 为 DeltaNet 增加容量。
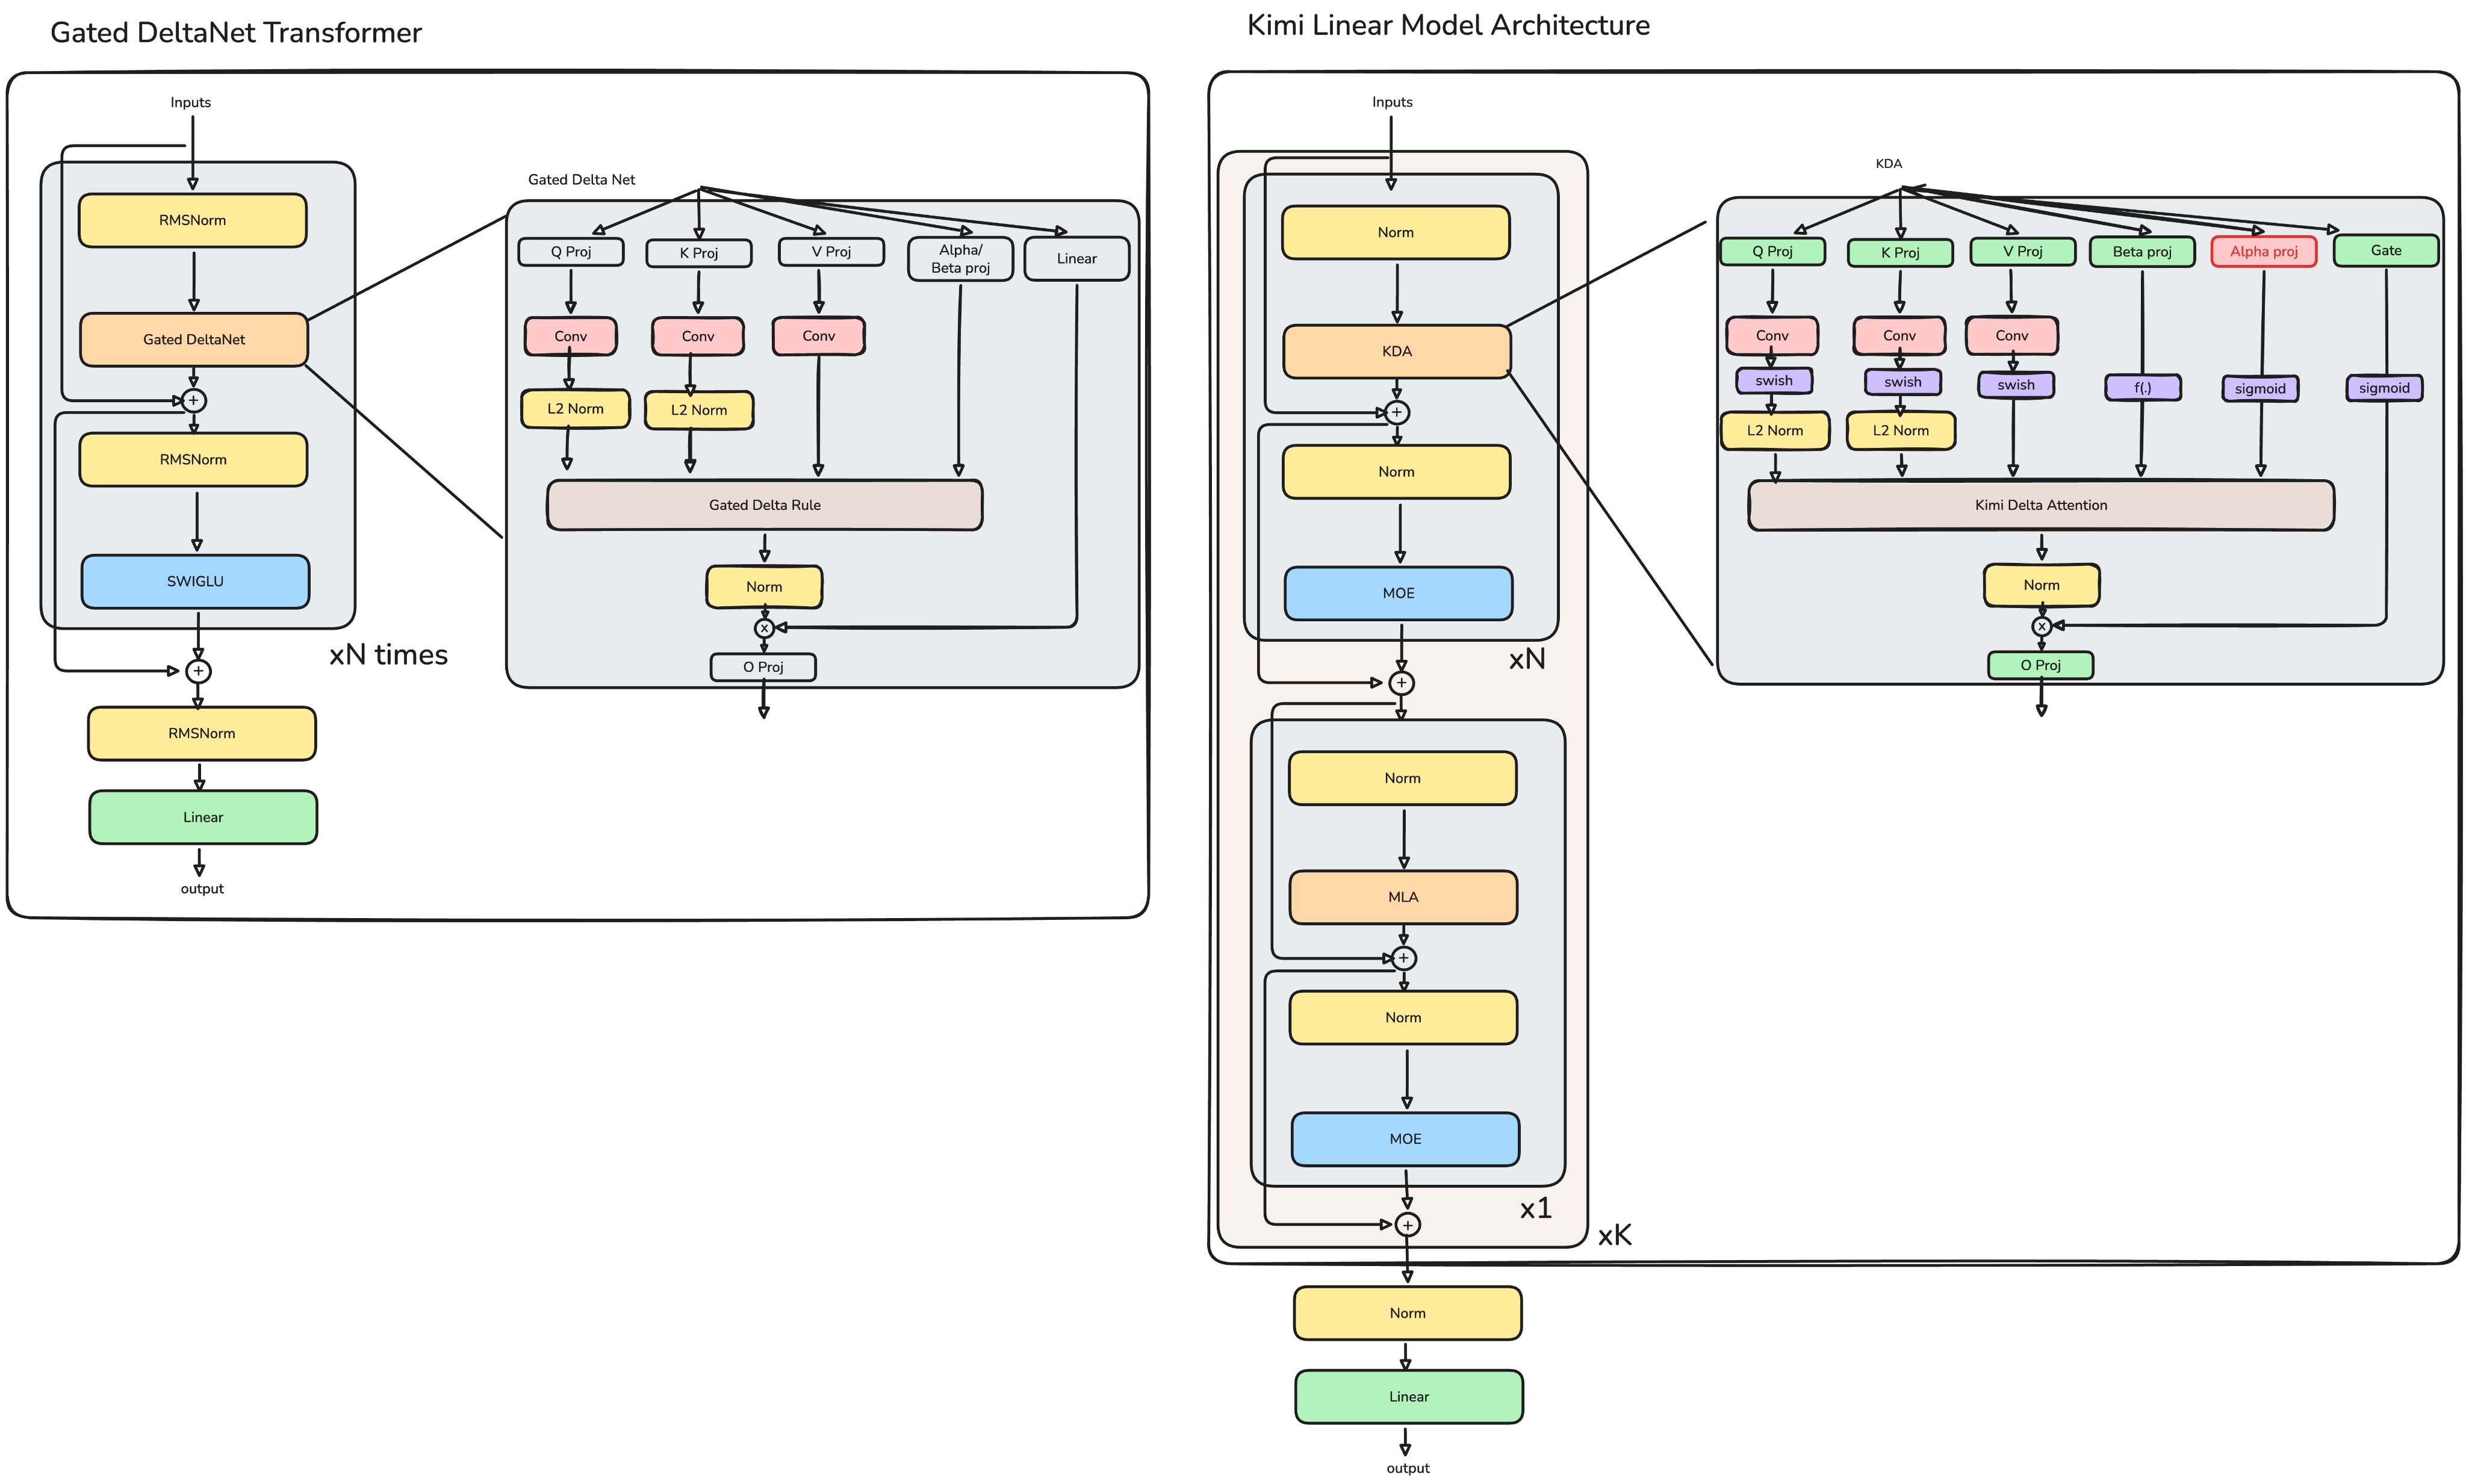
后面的章节会更详细地讲 MLA 和 MoE。现在最重要的一点是:这不是盲目扩展规模。新增容量有明确的数学目的:按 channel 控制的缩放让模型能够更细致地控制记忆衰减。
Scaling law 仍然重要,但容量必须加在正确的位置,并且要以系统能够利用的形式加入。这条演进路径中的每个架构,都在增加容量来解决前一个系统的具体局限。
Kimi K3
最终,KimiK3 的语言骨干与上面的 Kimi Linear 看起来相似。它包含 23 个四层 macrocycle。每个 macrocycle 中,有三层使用 Kimi Delta Attention,第四层使用 Multi-head Latent Attention。第一层使用 dense feed-forward network,其余层使用 latent Mixture-of-Experts。
乍看之下,Kimi Linear 的变化似乎并不大:
- 规模显著扩大
- 每 12 层使用一次 blockwise AttnRes
- MLA query LoRA 与输出门控
- latent-space MoE
- SiTU 激活
- Gated MLA
KDA 提供恒定状态的递归记忆,而周期性的 MLA 层保留了对上下文的完整 softmax 检索。下面的简化图示可以帮助理解接下来讨论的变化。
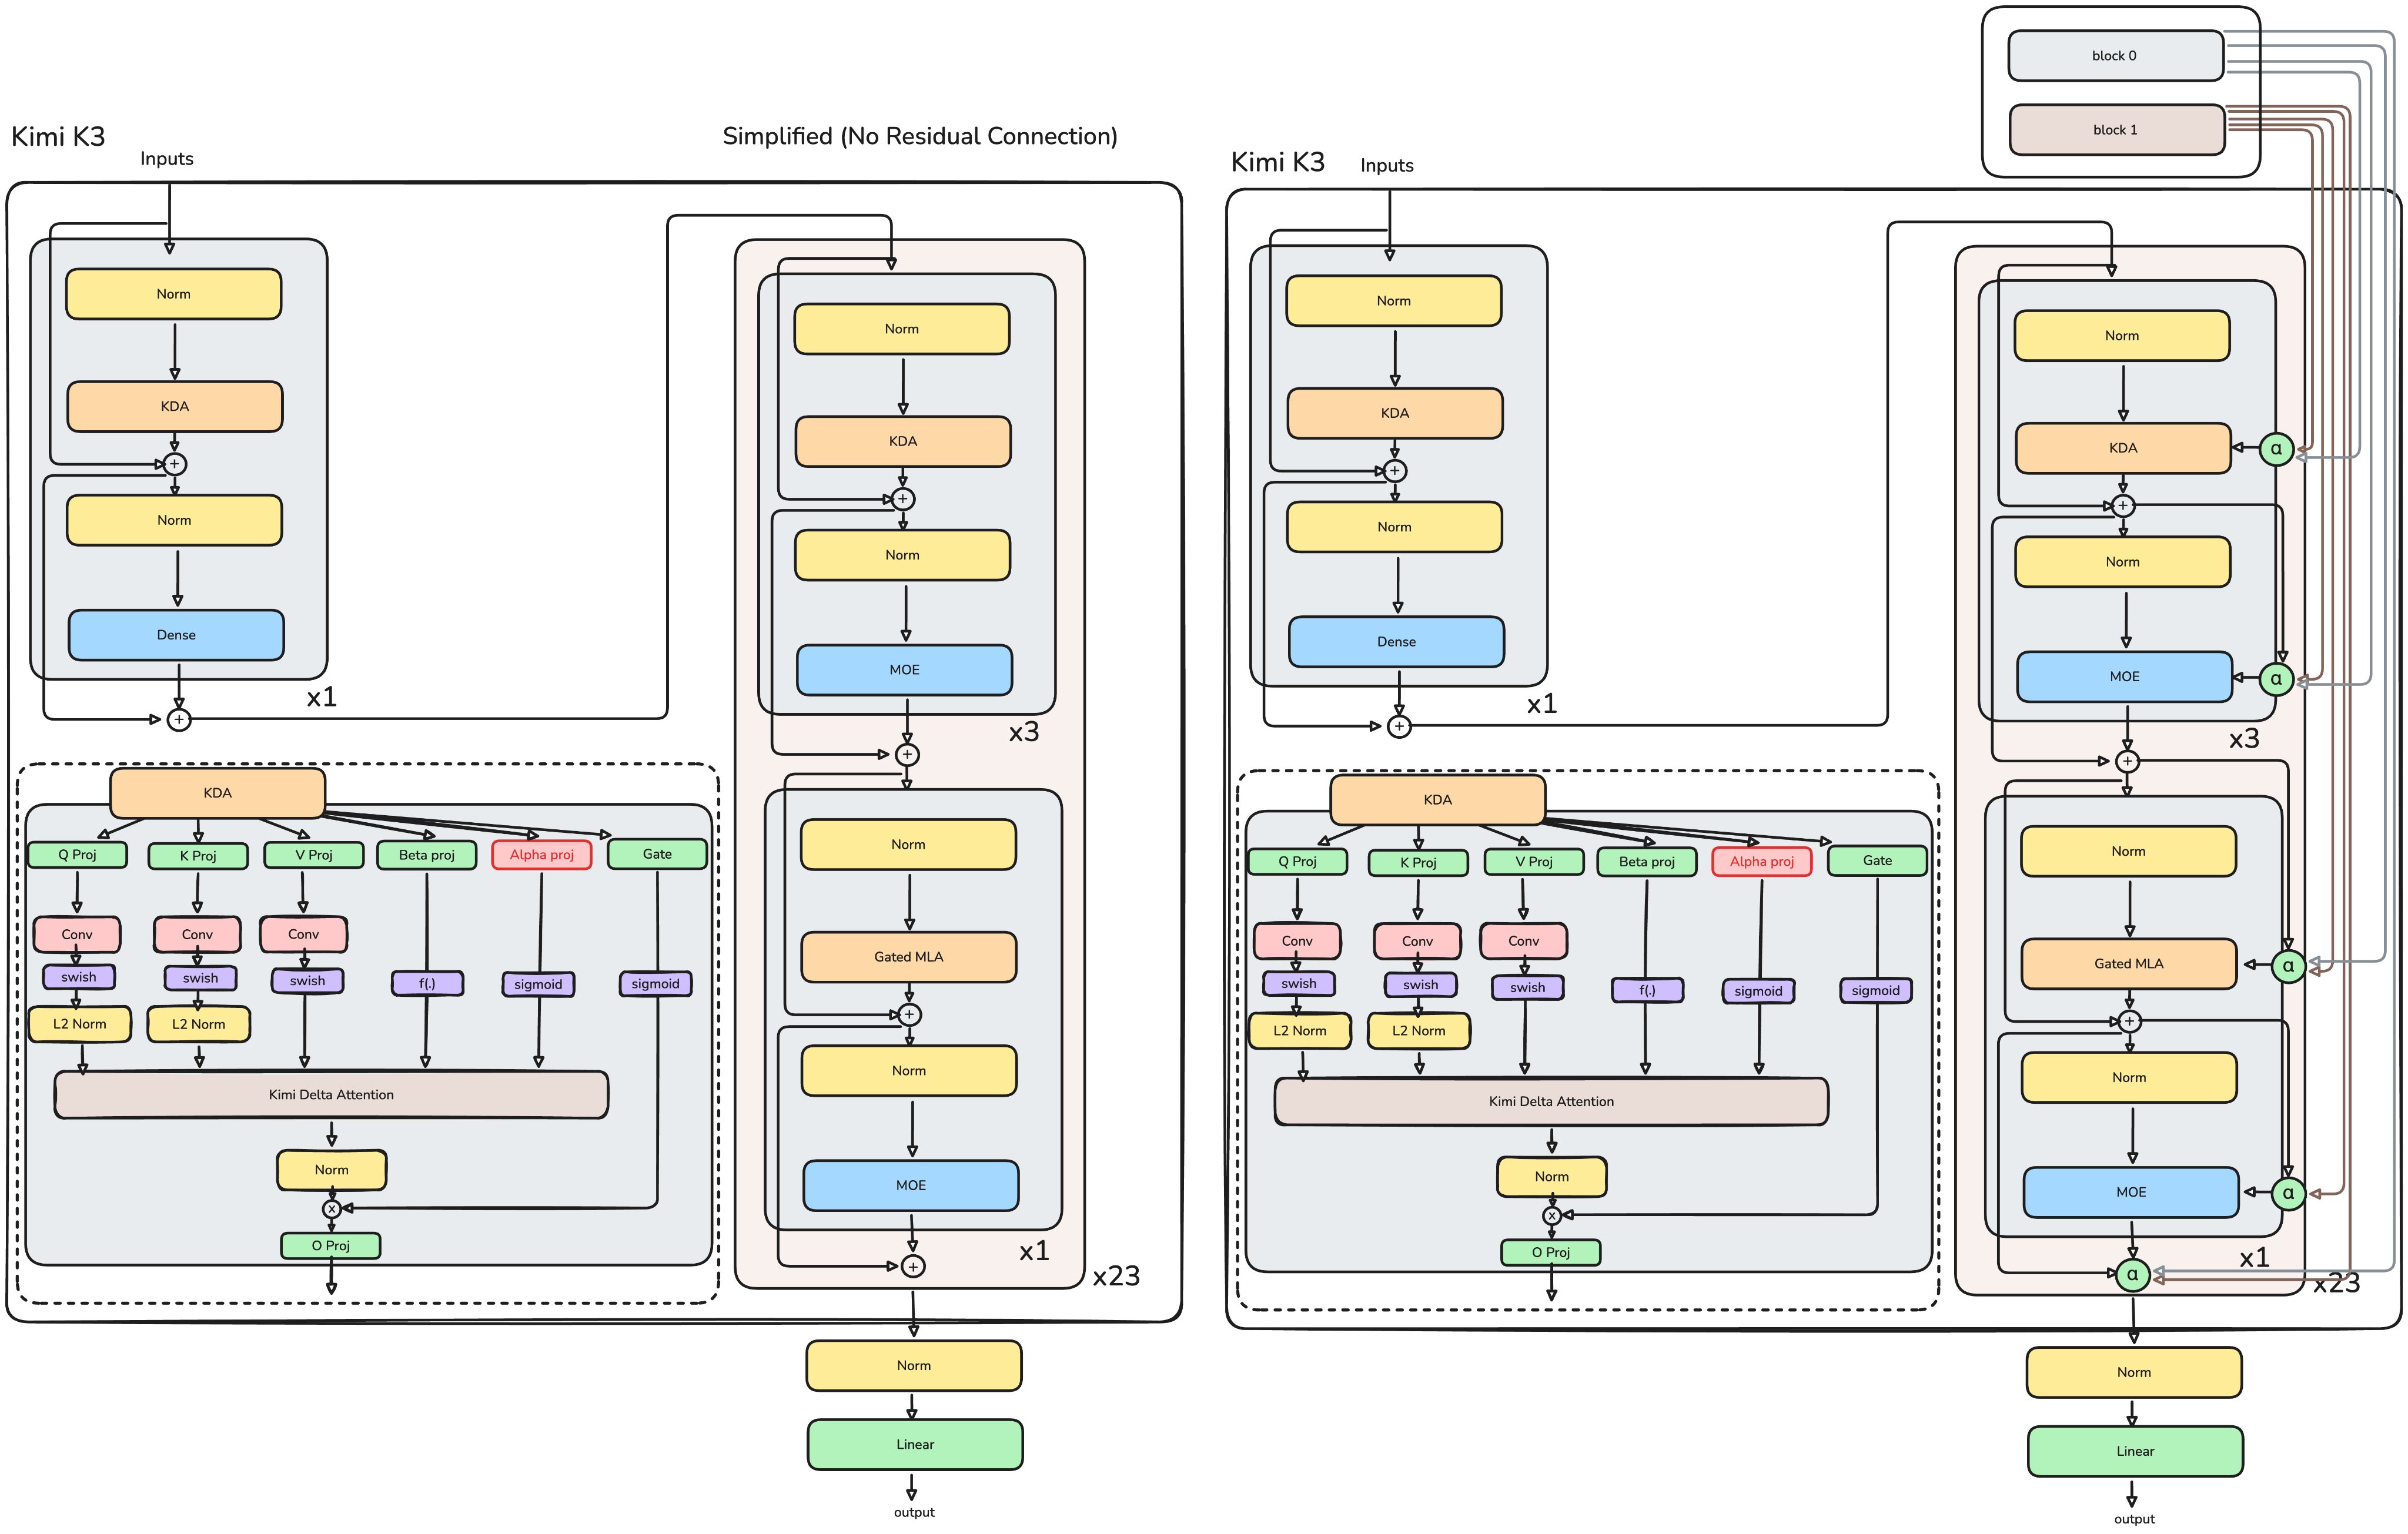
我们先从更直接的变化开始:Gated MLA、latent-space MoE 和 SiTU 激活。
Gated MLA 决定从 MLA 检索出的每个特征有多少可以传入 residual stream。它通过把输入投影出的 gate 与特征逐元素相乘来实现。
在传统 MoE 中,学习到的 router 使用点积相似度,把每个 token 发送给一部分 expert network。KimiK3 总共有 898 个 expert,其中 2 个是共享 expert、会处理每个 token;剩下的 896 个中,router 会为每个 token 选择 16 个。
KimiK3 还改变了 expert 的激活方式。它不再对 up projection 应用 SiLU,再与 gate 做逐元素相乘,最后进行 down projection;它改用 SiTU:
d = x.shape[-1] // 2
gate = x[..., :d].to(torch.float32)
up = x[..., d:].to(torch.float32)
situ_a = self.beta * torch.tanh(gate / self.beta) * torch.sigmoid(gate)
if self.linear_beta is not None:
up = self.linear_beta * torch.tanh(up / self.linear_beta)
return (situ_a * up).to(x.dtype)
模型还会把输入下投影到共享 expert,再把共享 expert 的最终和上投影回来:
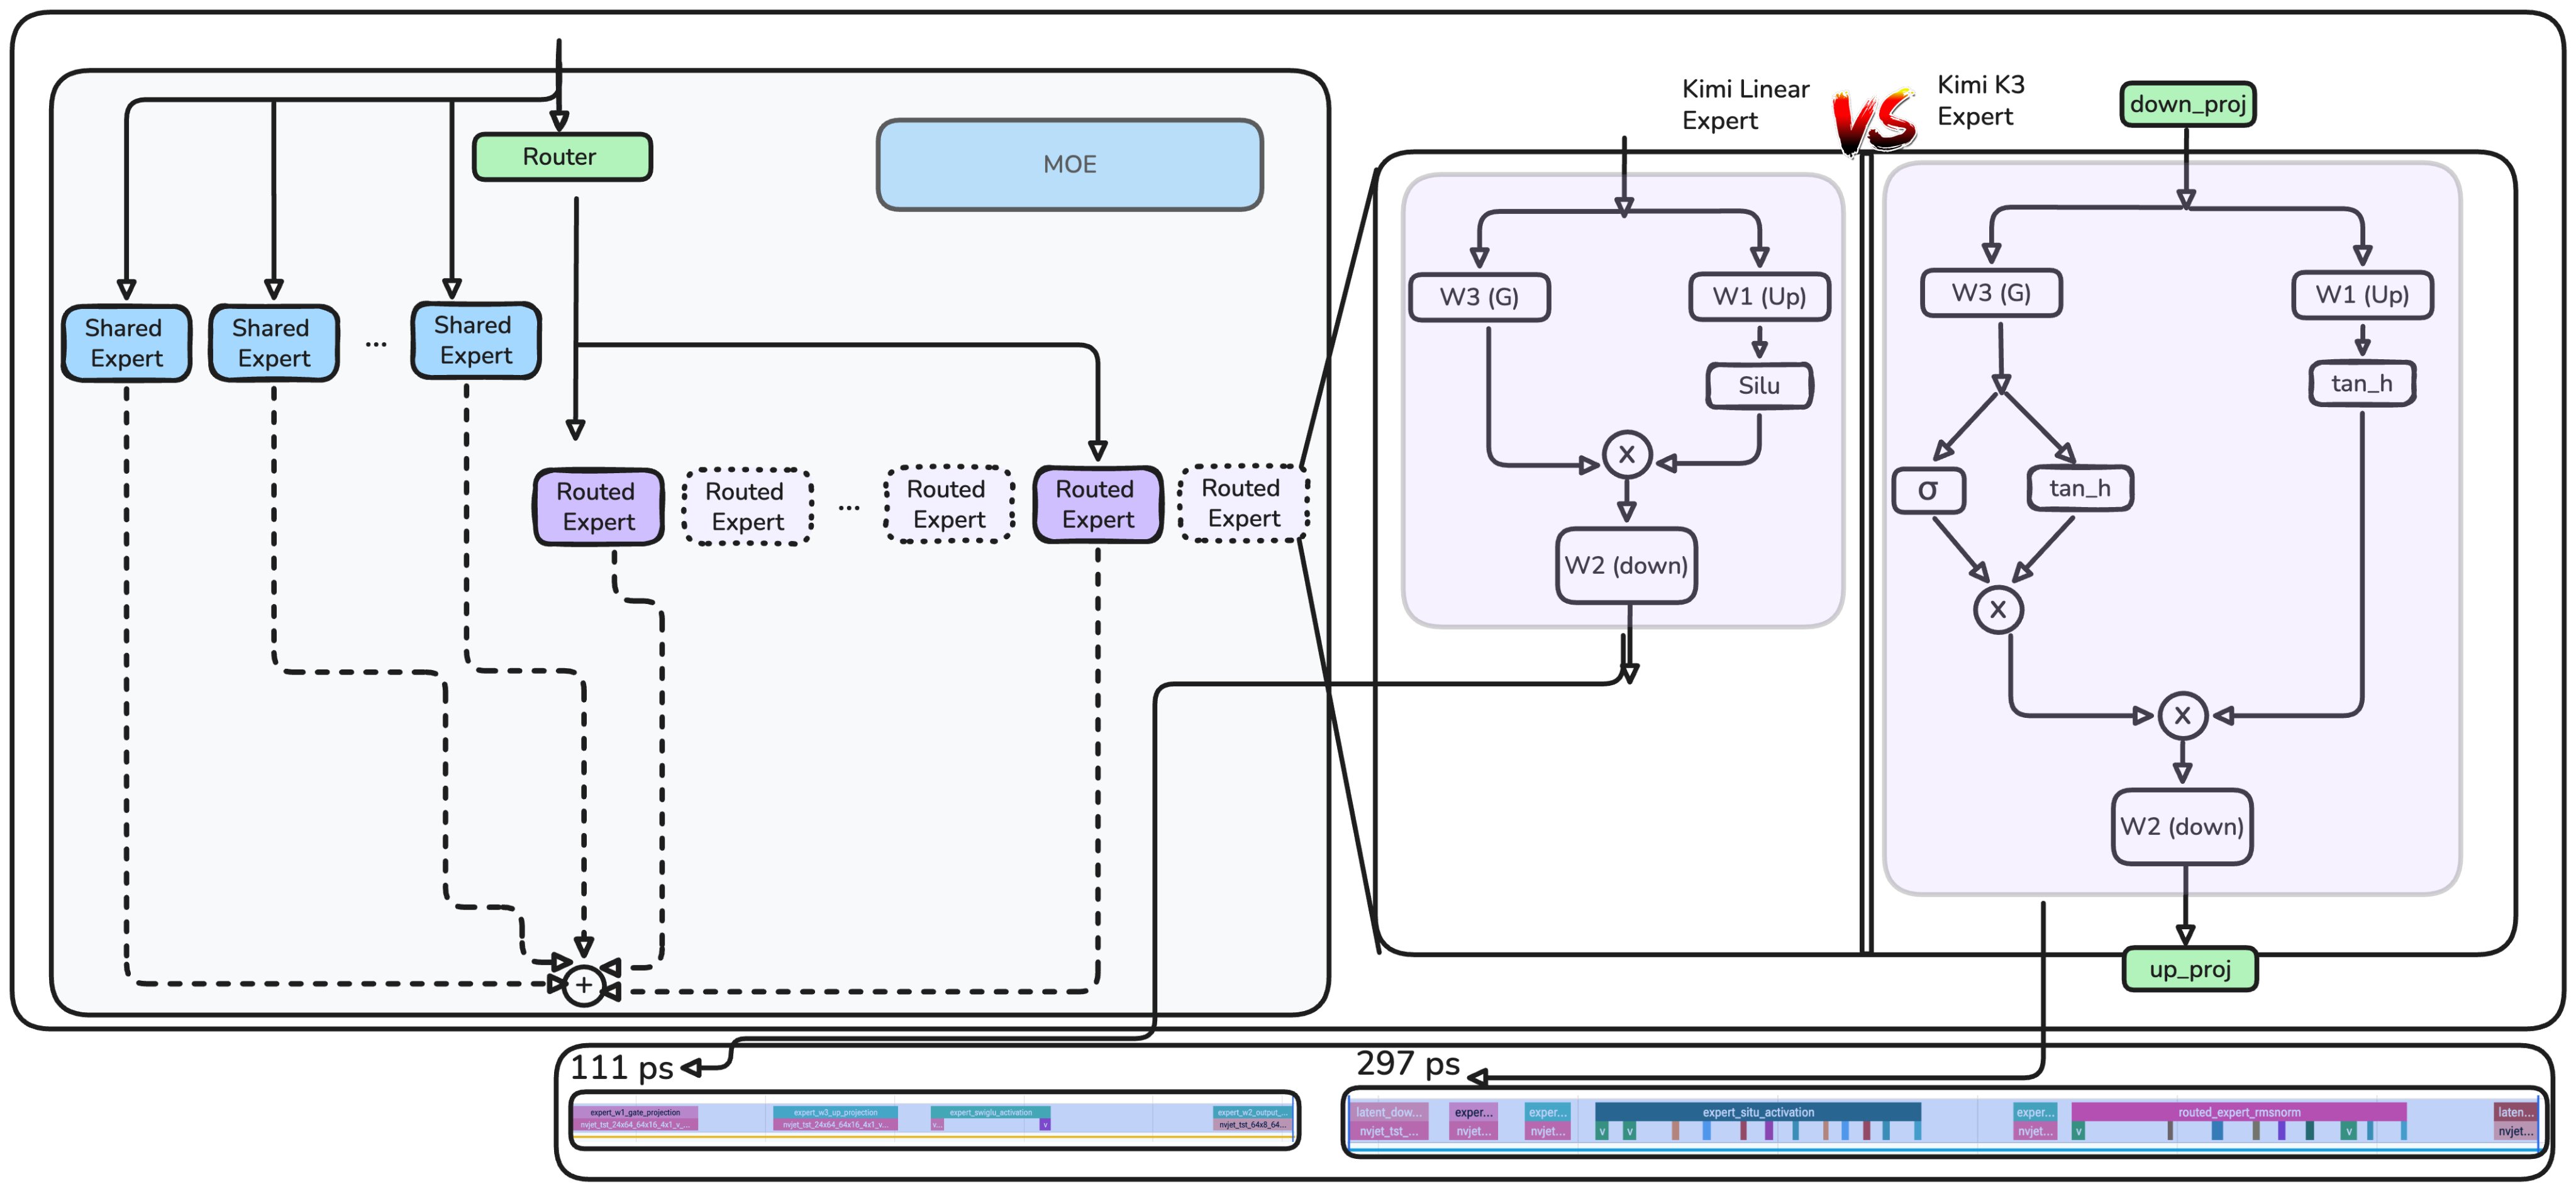
这体现了模型推理中一个反复出现的挑战。没有 fused kernel 时,新激活比原始路径慢了近 3 倍。一个抵消这一开销的优化是让 expert 在压缩后的 latent space 中运行,这会显著加快前向过程,并几乎减半 FLOPs。
剩下的变化包括 MLA query LoRA、输出门控,以及每 12 层一次的 blockwise Attention Residual。AttnRes 大约增加 2% 的推理延迟,但带来两个重要好处:
- 选择性检索更早的表示,缓解 residual dilution 和 hidden-state 增长
- 1.25 倍计算优势
AttnRes 和 MLA 从不同方向解决同一个底层限制。KDA 层使用固定大小的状态,必然会丢弃信息;MLA 从 token context 中检索,而 AttnRes 从更早的深度方向表示中检索。
AttnRes
感谢 @chloey3k 对本节的帮助。在每次前向传播中,输入都会经过一叠层。这里每层由一个注意力 block(KDA 或 MLA)和一个 MLP 或 MoE block 组成。通常,每层的输入都是原始 embedding 与所有前序层输出的总和,并且每一项权重相同。
ℎ 𝑙
ℎ 1 + ∑ 𝑖
1 𝑙 − 1 𝑓 𝑖 ( ℎ 𝑖 )
这里,h_i 是第 i 层的输入,h_1 是当前 token 的 embedding(截至目前序列中的最后一个 token),f_i(h_i) 是第 i 层(一个 attention 或 MLP block)的输出。
问题在于缺少选择性访问。不同类型的层接收到同一个聚合状态,尽管它们可能从不同权重中获益。由于递推完全是加法式的,后面的层还必须学习越来越大的输出,才能影响累积的 residual,这会让训练变得不稳定。AttnRes 不再平等对待所有层,而是给总和中的每一项乘以专门的权重,让模型更重视当前上下文中最有用的层。
ℎ 𝑙
𝛼 0 ⋅ ℎ 1 + ∑ 𝑖
1 𝑙 − 1 𝛼 𝑖 ⋅ 𝑓 𝑖 ( ℎ 𝑖 )
每个权重 alpha_i 都由 query-key 点积计算得到。query 为每层单独学习,而 key 和 value 来自更早的 residual-stream 状态。分数会被归一化为和为 1,再用来形成这些状态的加权组合。
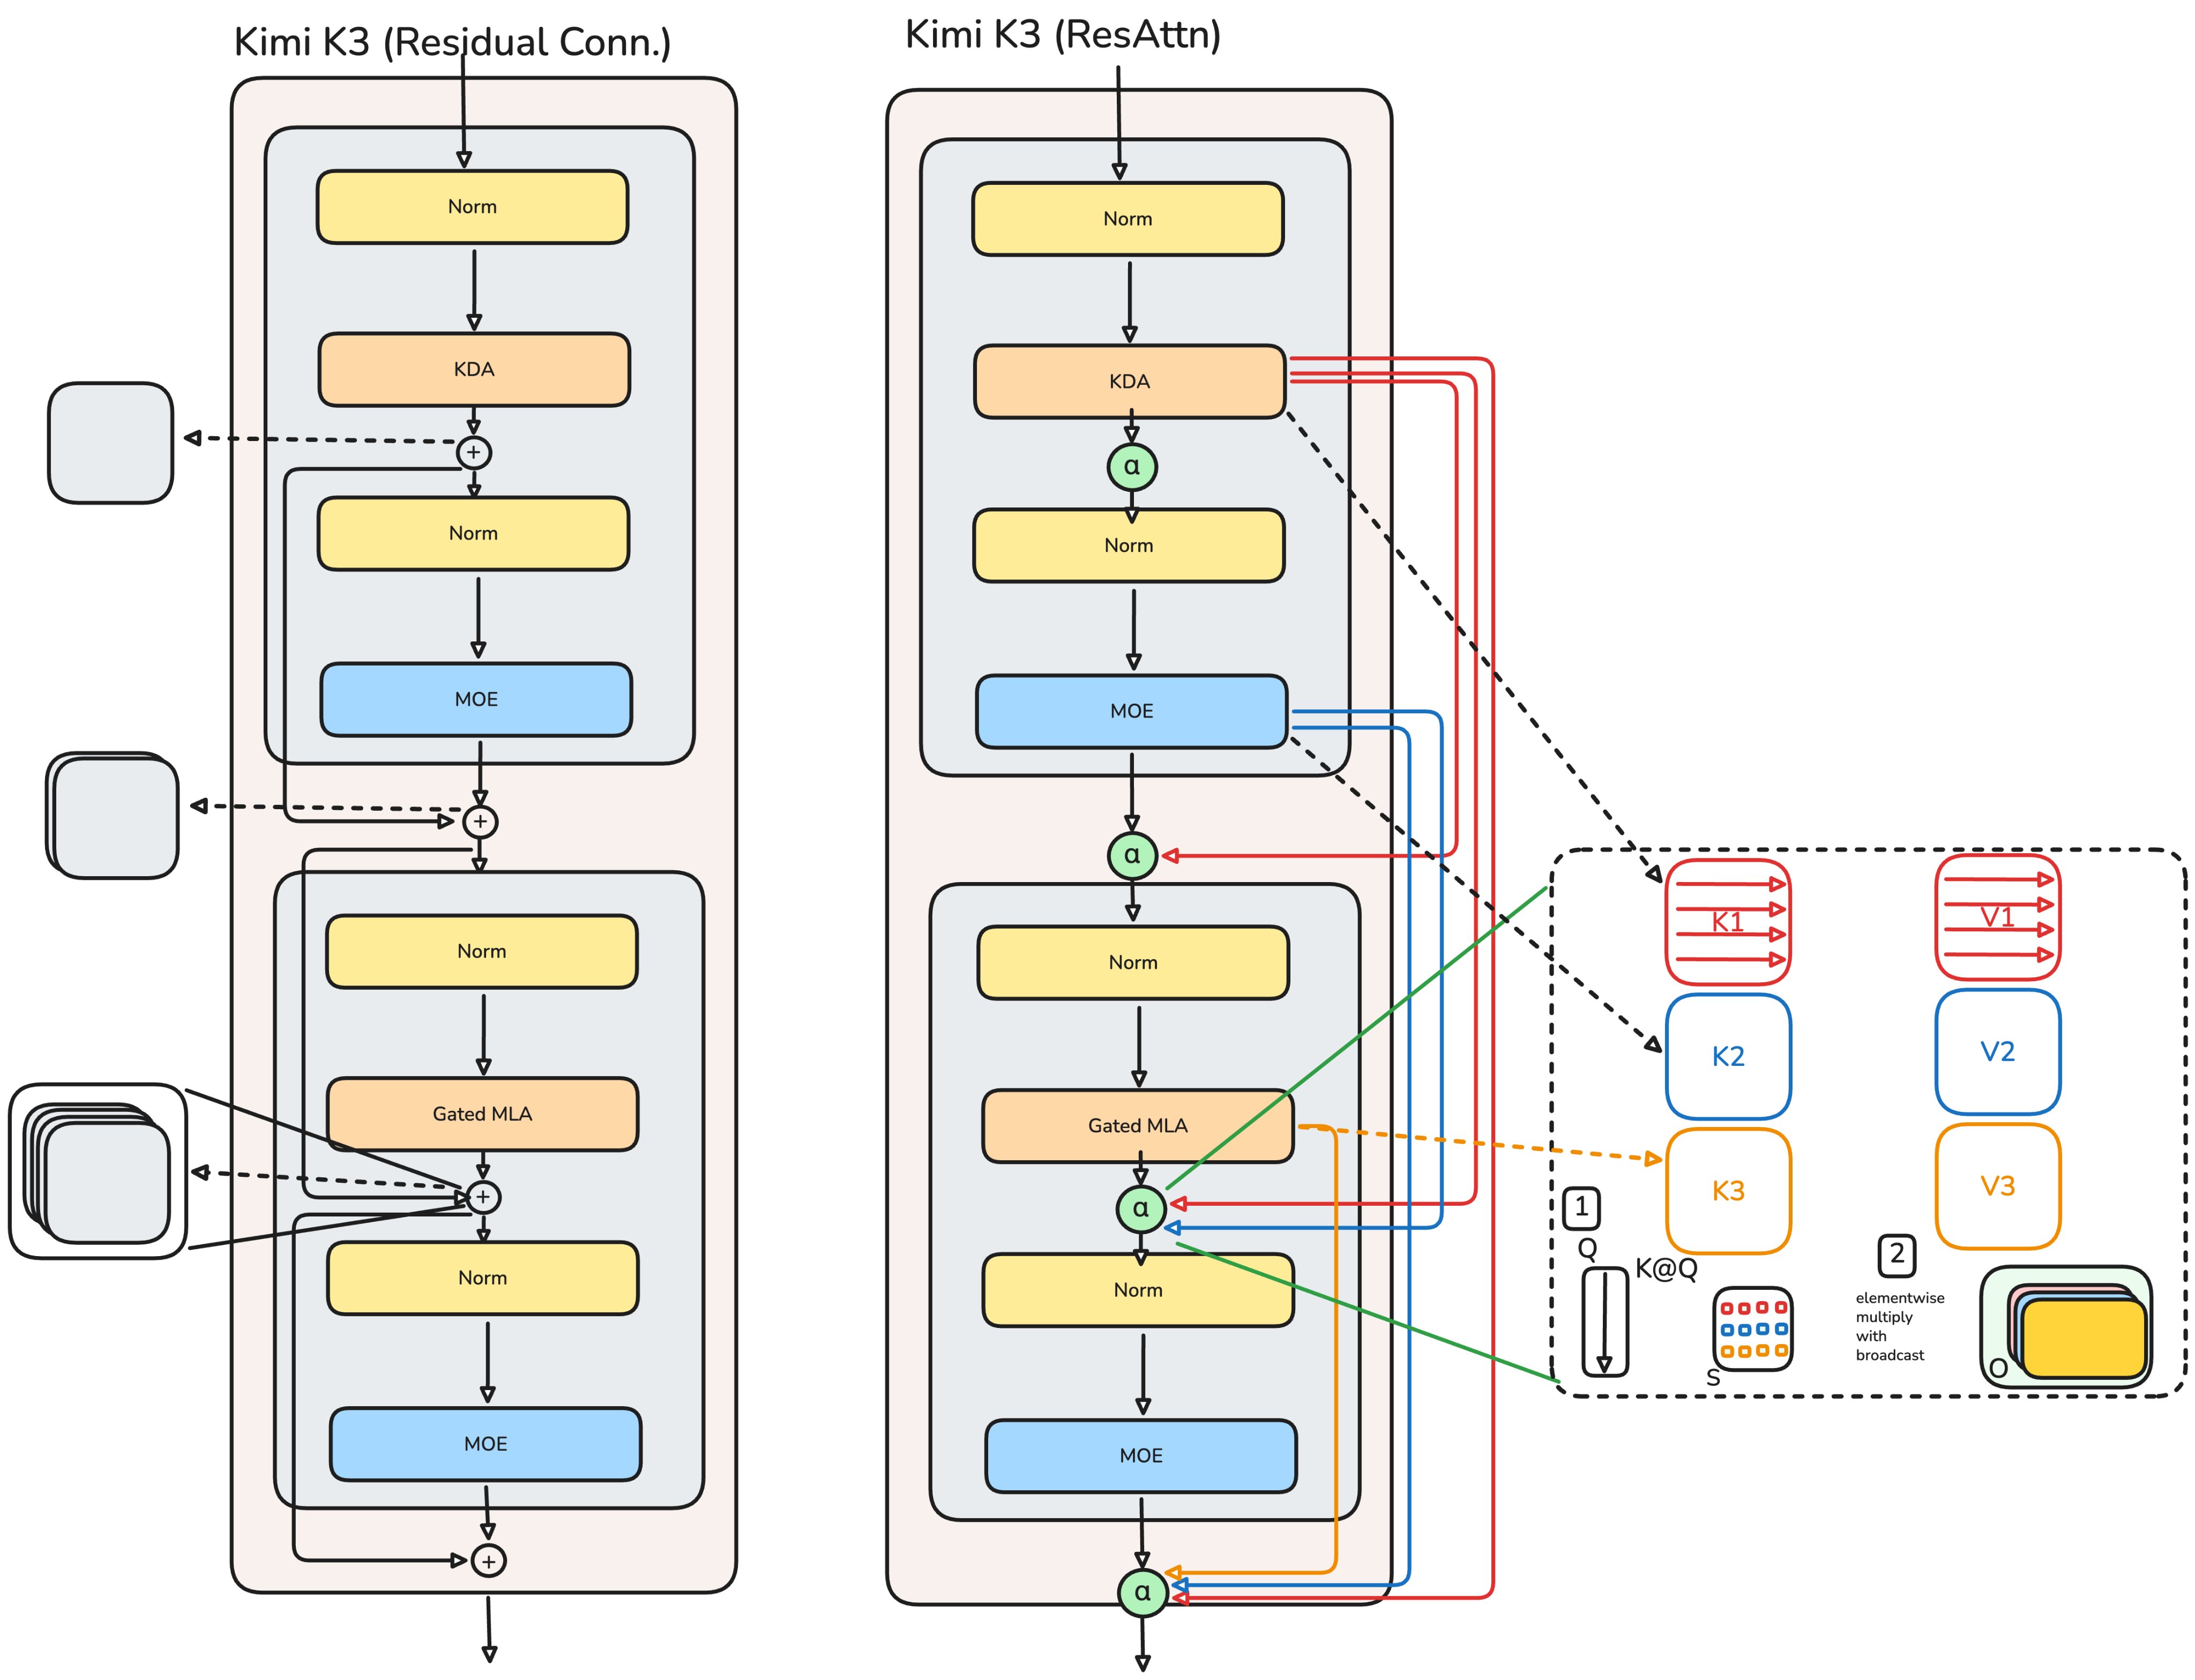
因此,模型不必只依赖紧邻的前一层。AttnRes 让每一层都能选择性访问更早层的输出,使其学习到的 query 可以取回当前计算最有用的表示。
下面的伪代码在 block 粒度上应用同一个想法。一个 block 是 12 个 decoder layer 中累积的 attention 与 MLP 输出的逐元素和,并作为一个深度表示保存下来,供后续 AttnRes 混合。
如果在每一层都应用 residual attention,训练和推理成本会过高。只在固定的 block 边界应用它,可以用更低的成本获得大部分收益。在 KimiK3 中,每个边界位于 12 个 decoder layer 之后。跨越 23 个四层 macrocycle,一共形成 8 个 AttnRes block,从而提升推理速度。
这可能是 block_attn_res 函数中最重要的一部分
V = torch.stack(blocks + [partial_block]) # [N+1, B, T, D]
K = norm(V)
logits = torch.einsum('d, n b t d -> n b t', proj.weight.squeeze(), K)
h = torch.einsum('n b t, n b t d -> b t d', logits.softmax(0), V)
return h
这就完成了从 GPT-2 到 KimiK3 的演进。
核心变化并不只是规模。架构的每一步都改变了模型存储什么、如何更新状态,或如何检索固定大小状态无法保留的信息。
KimiK3 结合了恒定状态的递归记忆、周期性的 softmax 检索、稀疏 expert 容量,以及选择性的深度方向 residual 访问。最终系统把额外容量花在了具有明确功能作用的位置上。
本质上,固定容量的关联记忆(固定维度)需要一套淘汰策略,因为纯加法的线性操作一旦达到容量上限,就会不断累积干扰。因此,需要使用门控、路由或衰减之类的学习型选择机制,而 attention 是最有效的选择性读取机制。